Le blog Workstation
Data Centre
Articles étiquetés Data Centre.
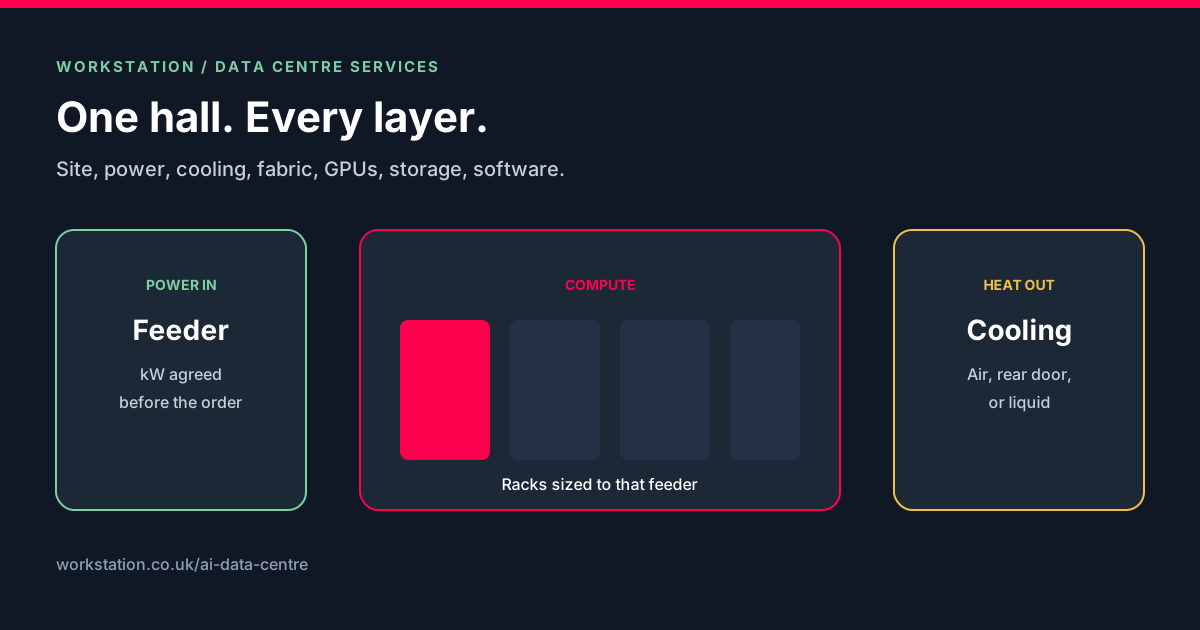
Services de centre de données IA : comment Workstation conçoit, construit et livre
Workstation conçoit des centres de données IA en fonction de la charge que le bâtiment peut supporter. Une seule équipe couvre le site, le budget énergétique, le refroidissement, le réseau, les serveurs GPU, le stockage, le logiciel et un rodage de 72 heures. Voici le service complet, et les cas où un cloud GPU privé est la meilleure réponse.
 Balinder WaliaLire
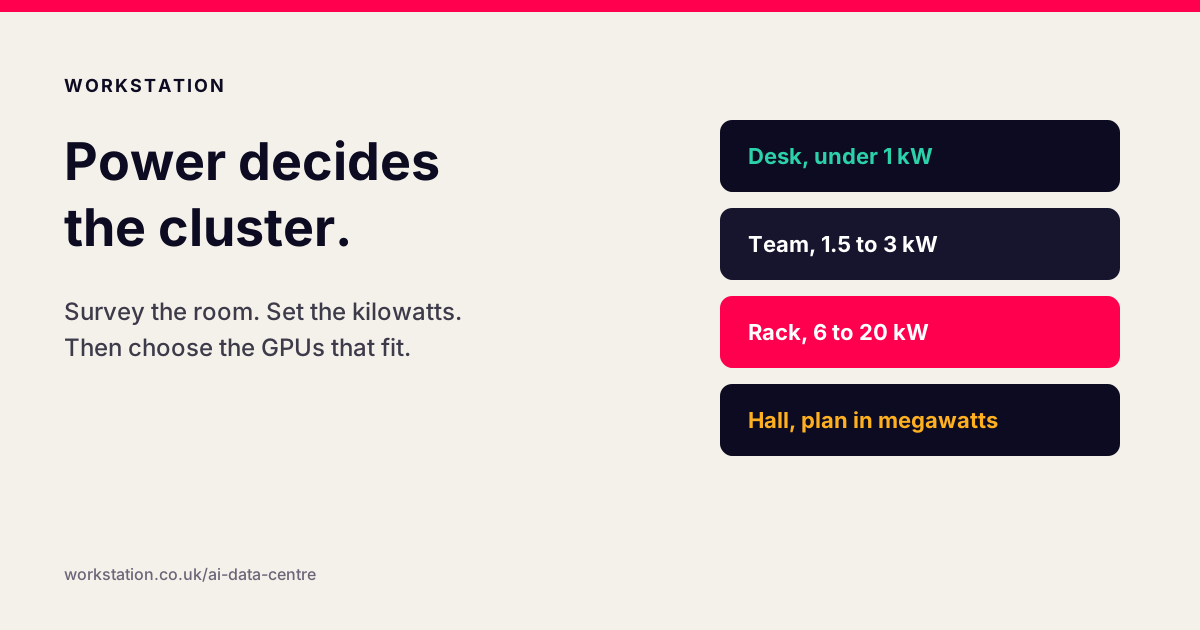
L'énergie d'abord : comment Workstation planifie l'infrastructure IA
Workstation planifie l'infrastructure IA en fixant d'abord le budget énergétique. Étude du site, choix entre refroidissement par air ou par liquide, puis achat des seuls GPU que ce site peut faire fonctionner, d'un bureau à moins de 1 kW à une salle planifiée en mégawatts.
Balinder WaliaLire 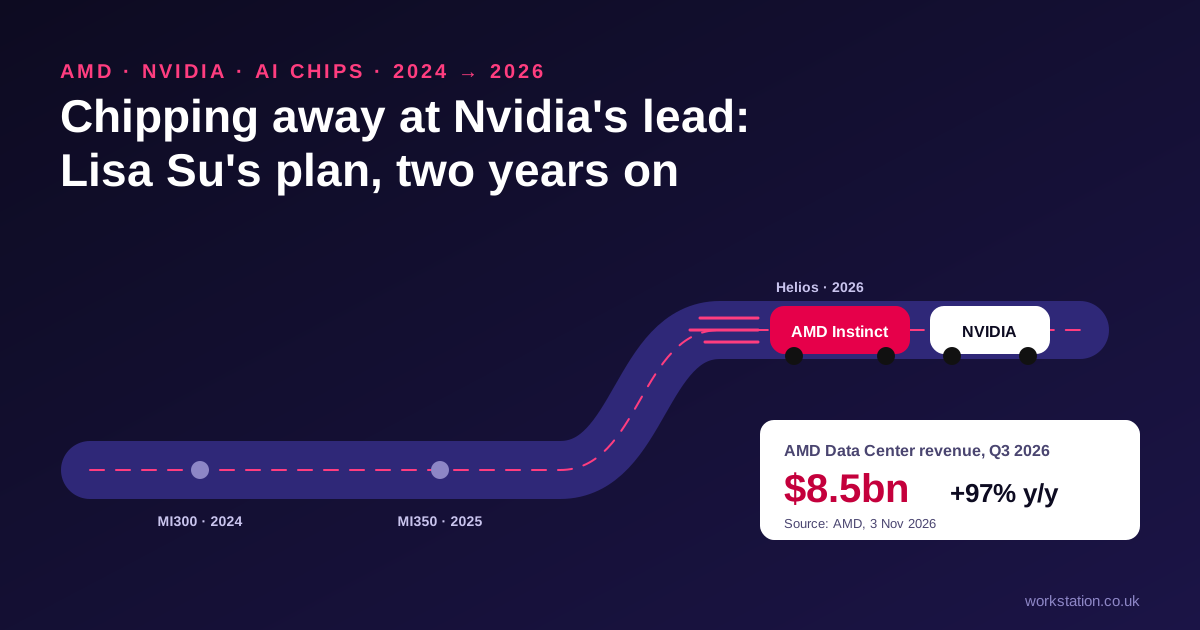
Chipping Away at Nvidia's Lead: Lisa Su's AMD Plan, Two Years On
In December 2024 Bloomberg's The Circuit asked AMD CEO Lisa Su how she would chip away at Nvidia's lead in AI. We check the plan against AMD's 2026 results and Helios launch, and explain what a credible second AI platform means for UK buyers. Includes a link to the interview.
WorkstationLire 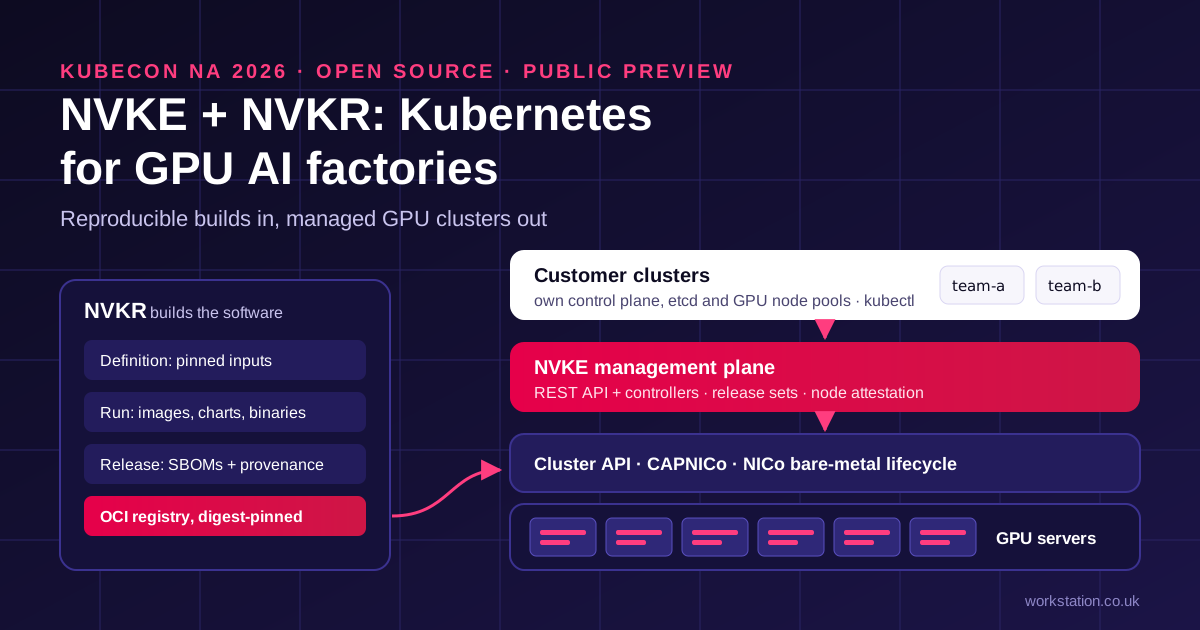
NVIDIA NVKE et NVKR : pourquoi Kubernetes pour GPU devient le système d'exploitation de l'usine d'IA
NVIDIA a publié en open source NVIDIA Kubernetes Engine (NVKE) et NVIDIA Kubernetes Recipes (NVKR) pour exploiter Kubernetes en mode géré sur une infrastructure GPU. Ce qu'ils font en termes simples, ce que signifie réellement la préversion publique, pourquoi l'ingénierie de l'IA crée une nouvelle demande de compétences cloud et DevOps, et qui devrait les évaluer dès maintenant.
Balinder WaliaLire 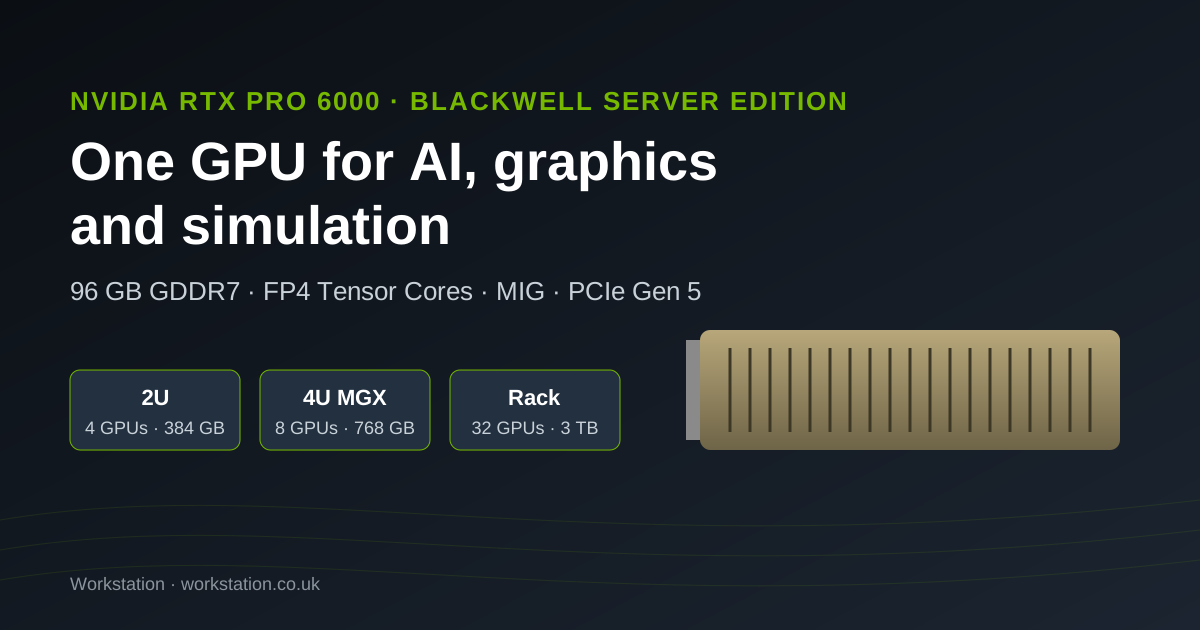
NVIDIA RTX PRO 6000 Blackwell Server Edition : un seul GPU pour l'IA, le graphisme et la simulation dans une salle serveurs au Royaume-Uni
96 Go de GDDR7, des Tensor Cores FP4 et des RT Cores sur une carte PCIe standard : ce que fait la RTX PRO 6000 Blackwell Server Edition de NVIDIA, pourquoi elle convient aux entreprises qui exécutent une IA privée dans des salles dont elles disposent déjà, les trois tailles de système, du serveur 2U à quatre GPU au rack de 32 GPU comme le RackScale 32 d'AMAX, et ce qu'il faut vérifier avant de commander.
Balinder WaliaLire 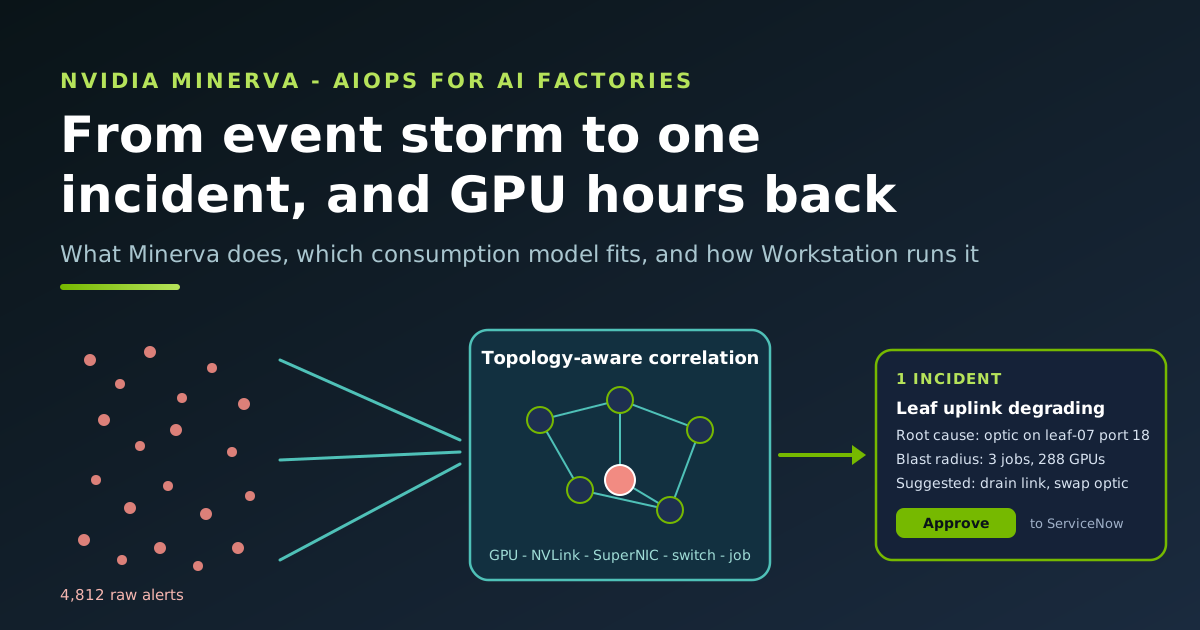
NVIDIA Minerva pour les usines d'IA : transformer les tempêtes d'alertes en heures GPU récupérées
Une seule optique qui se dégrade peut déclencher des milliers d'alertes et bloquer un millier de GPU. Ce que fait NVIDIA Minerva, ce qu'il vaut en heures GPU, goodput, MTBI, MTTR et tokens, lequel de ses trois modèles de consommation convient, des exemples chiffrés pour un néocloud Vera Rubin NVL72, un cluster Blackwell universitaire et une entreprise équipée de Grafana et ServiceNow, et son lien avec UFM.
Balinder WaliaLire 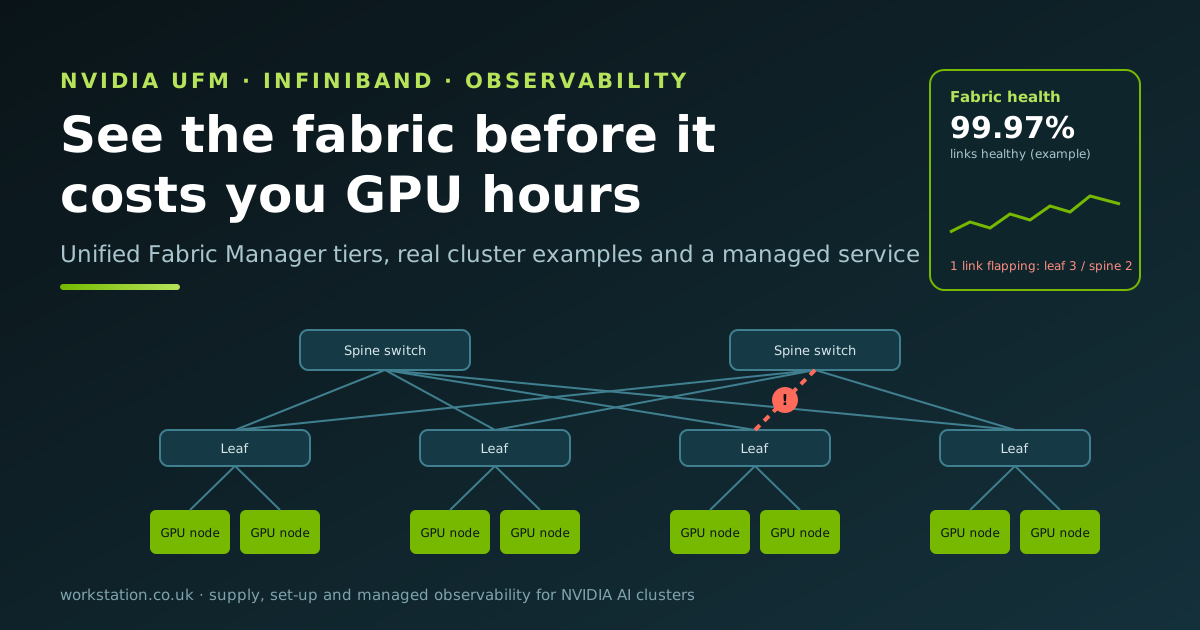
NVIDIA UFM pour les clusters d'IA : pourquoi la visibilité de la fabric InfiniBand détermine ce que valent vos GPU
Un seul lien InfiniBand instable peut bloquer une tâche de 256 GPU. Ce que fait NVIDIA Unified Fabric Manager, quand choisir UFM Telemetry, Enterprise ou Cyber-AI, des exemples chiffrés pour un cluster DGX B300 de 4 nœuds, un cluster de 32 nœuds de type SuperPOD et un service Slurm universitaire, et ce que vaut la visibilité de la fabric en heures GPU.
Balinder WaliaLire 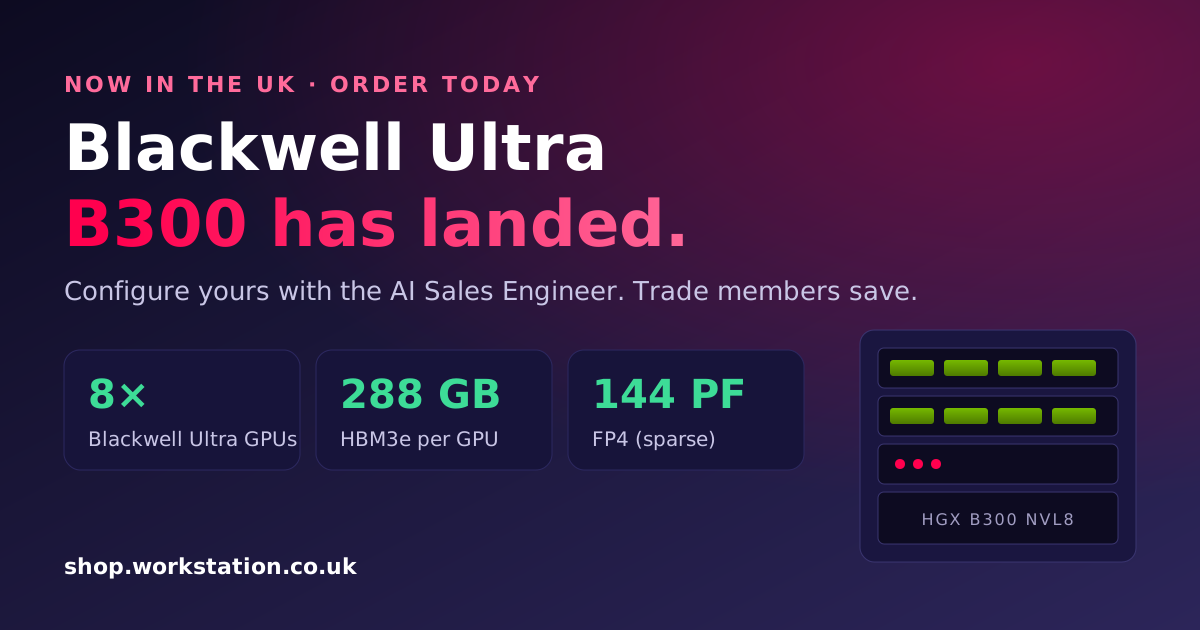
Le NVIDIA Blackwell Ultra B300 est arrivé au Royaume-Uni : configurez le vôtre dès aujourd'hui
Les systèmes NVIDIA Blackwell Ultra B300 sont arrivés chez nos partenaires de distribution au Royaume-Uni. Configurez et chiffrez votre système B300 à huit GPU en quelques minutes avec notre AI Sales Engineer, économisez avec Workstation Trade et commandez dès aujourd'hui pour être parmi les premiers servis à l'arrivée des stocks britanniques.
Balinder WaliaLire 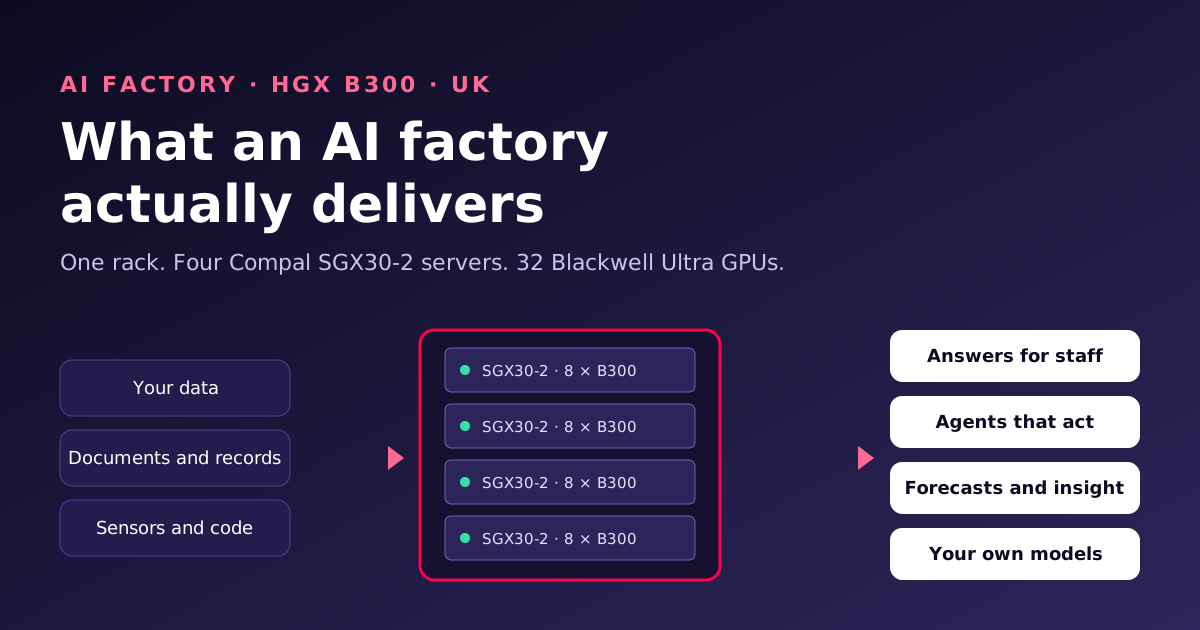
Ce qu'apporte réellement une usine d'IA : un rack, 32 GPU Blackwell Ultra et le travail qu'il accomplit pour vous
Une usine d'IA transforme vos propres données en réponses, en agents, en prévisions et en modèles entraînés, sur du matériel que vous contrôlez. Voici ce qui entre, ce qui sort, comment le travail circule au quotidien, et ce dont un rack de quatre serveurs Compal SGX30-2 avec 32 GPU NVIDIA Blackwell Ultra a besoin pour fonctionner.
Balinder WaliaLire