NVIDIA Minerva pour les usines d'IA : transformer les tempêtes d'alertes en heures GPU récupérées
Ce que fait Minerva, quel modèle de consommation convient à qui, trois exemples chiffrés, et comment Workstation le fournit, l'intègre et en assure le support
 Balinder Walia9 novembre 202613 min read
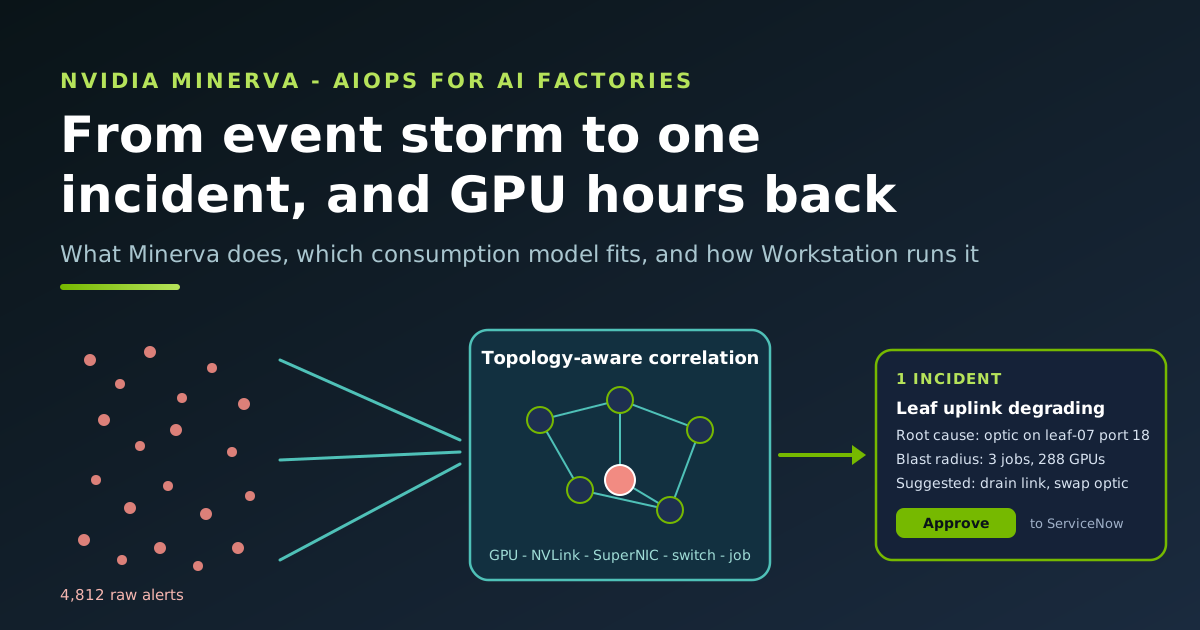
Une usine d'IA se rentabilise en heures GPU et en tokens, et elle les perd sans bruit : un nœud à la traîne, une optique qui se dégrade, une tempête d'alertes que personne ne parvient à lire à temps. Cet article s'adresse aux CTO, aux exploitants d'usines d'IA et de néoclouds ainsi qu'aux responsables du calcul pour la recherche. Il explique simplement ce qu'est NVIDIA Minerva, ce qu'il vaut pour l'entreprise, lequel de ses trois modèles de consommation convient à quelle organisation, quel est son lien avec NVIDIA UFM, et comment Workstation le fournit, le met en place, l'intègre et en assure le support. Les ingénieurs qui veulent l'architecture, la configuration d'intégration et le runbook de déploiement liront l'article technique.

Ce qu'est NVIDIA Minerva, en termes simples
NVIDIA a annoncé Minerva en octobre 2026 et le présente sur sa page officielle NVIDIA Minerva comme le principal produit d'observabilité de ses usines d'IA, y compris les systèmes bâtis sur les plateformes Vera Rubin et Blackwell. Débarrassé du jargon, il fait cinq choses :
- Il collecte tout, une seule fois. La santé des GPU, les commutateurs NVLink qui relient les GPU au sein d'un rack, les commutateurs Ethernet Spectrum-X et les SuperNIC qui relient les racks entre eux, les DPU, NCCL (la bibliothèque que les GPU utilisent pour échanger leurs résultats), les ordonnanceurs de tâches tels que Slurm et NVIDIA Run:ai, le stockage et les charges de travail d'IA elles-mêmes. Il ingère ces données via des standards ouverts : OpenTelemetry, le streaming gNMI depuis les commutateurs, syslog, DCGM pour les GPU, les données Slurm et du JSON simple.
- Il tient une carte à jour. Un graphe de connaissances enregistre quel GPU se trouve dans quel nœud, quel port est relié à quel commutateur et quelle tâche s'exécute où, et il se met à jour au fil de l'arrivée et du départ des tâches.
- Il apprend la normale et repère l'anormal. L'apprentissage automatique établit une référence pour chaque signal et signale la dérive qui précède généralement une panne.
- Il explique, au lieu de se contenter d'alerter. Lorsqu'un problème survient, il parcourt la carte pour trouver la cause commune derrière les symptômes, détermine quelles tâches et quels GPU sont touchés et envoie un incident unique vers Slack, Microsoft Teams, PagerDuty ou ServiceNow.
- Il répond. Un assistant nommé Sherlock permet aux opérateurs de poser des questions en langage naturel sur la télémétrie en direct, et un serveur MCP (Model Context Protocol) permet à vos propres agents d'IA d'interroger Minerva. Lorsque vous l'autorisez, les correctifs recommandés peuvent être appliqués automatiquement, par exemple via Ansible.
Il peut s'exécuter dans votre centre de données ou en tant que service hébergé par NVIDIA, et NVIDIA affirme qu'il passe à l'échelle de centaines de milliers de GPU. Le Minerva Collector fait également partie de NVIDIA DSX OS, ce qui permet d'étendre la même vue du GPU jusqu'à l'alimentation et au refroidissement du bâtiment.
Pourquoi c'est important pour l'entreprise
Une usine d'IA est une machine très coûteuse dont la production se mesure en tokens et en modèles entraînés. Tout ce qui l'arrête, la ralentit ou la rend difficile à réparer se répercute directement sur le coût par token. NVIDIA exprime la valeur de Minerva dans les termes que les exploitants utilisent déjà dans leurs rapports, et nous faisons de même :
- Heures GPU récupérées. Les pannes qui ralentissent les tâches sans bruit, comme un seul nœud à la traîne qui retient des milliers de GPU à chaque étape de synchronisation, sont détectées en quelques minutes au lieu de plusieurs jours.
- Goodput plus élevé. Le goodput est la part du temps GPU qui produit un travail utile, une fois déduits les redémarrages, les réexécutions et les attentes. C'est ce chiffre qui compte, pas l'utilisation brute.
- Moins d'interruptions (MTBI plus élevé). Le temps moyen entre interruptions augmente lorsque les composants défaillants sont repérés tôt et remplacés pendant une fenêtre planifiée plutôt qu'en pleine exécution.
- Réparation plus rapide (MTTR plus faible). Le temps moyen de réparation diminue lorsque le premier message désigne déjà la cause probable et le périmètre d'impact.
- Des astreintes plus sereines. Un incident au lieu de milliers d'alertes signifie que les équipes réagissent à ce qui compte vraiment, et restent en poste.
- Plus de tokens. Pour l'inférence, chaque heure de débit dégradé représente une production perdue et, pour un fournisseur, un chiffre d'affaires perdu.
- Souveraineté des données. Un déploiement sur site conserve la télémétrie, la topologie et les métadonnées des tâches au sein de votre propre parc, ce qui compte pour le secteur public britannique, la recherche et les clients réglementés.
Trois modèles de consommation, et à qui chacun convient
NVIDIA propose Minerva de trois façons, du « faites-le vous-même » à la solution entièrement clés en main. Nous aidons nos clients à choisir en leur demandant ce qu'ils exploitent déjà et quelle part de l'analyse ils souhaitent maîtriser eux-mêmes.
| Modèle | Ce que vous obtenez | Convient à | Points d'attention |
|---|---|---|---|
| DIY Observability | Minerva en tant que collecteur de la télémétrie de l'usine d'IA, alimentant vos propres outils d'observabilité tels que Grafana. | Les équipes dotées d'une pratique Prometheus et Grafana mature qui veulent une collecte de données alignée sur NVIDIA sans changer d'outils. | Vous construisez et maintenez vous-même les tableaux de bord, les alertes et la corrélation. |
| AIOps with DIY Observability | Le collecteur plus l'apprentissage automatique, la détection d'anomalies et la corrélation de Minerva, les analyses étant renvoyées vers vos outils et agents existants. | Les entreprises disposant d'une pile Grafana, ServiceNow ou PagerDuty établie qui veulent des alertes moins nombreuses et de meilleure qualité sans nouvelle console. | L'intégration et le routage des alertes doivent être conçus avec soin, afin que les incidents arrivent une seule fois dans la bonne file. |
| Turnkey | La plateforme complète : collecte, analyses, assistant Sherlock, ainsi que les tableaux de bord et l'interface utilisateur propres à Minerva. | Les usines d'IA et les néoclouds qui veulent dès le premier jour une vue d'exploitation unique, alignée sur les architectures de référence de NVIDIA. | Décidez tôt comment elle cohabitera avec la supervision que vous exploitez déjà pour les systèmes non GPU. |
Les licences, éditions et conditions de support sont fixées par NVIDIA et peuvent évoluer ; nous les confirmons donc pour chaque devis. Le choix n'est pas non plus définitif : de nombreux clients commencent par le collecteur et ajoutent l'AIOps une fois qu'ils ont confiance dans les données.
Trois exemples
Les chiffres ci-dessous sont illustratifs et détaillés pour montrer la structure de l'analyse de rentabilité. Votre coût par heure GPU, votre combinaison de tâches et vos taux de panne seront différents.
1. Un néocloud avec environ un millier de GPU Vera Rubin
Quatorze racks Vera Rubin NVL72, 1 008 GPU, sur une fabric Ethernet Spectrum-X, loués à des clients pour de grands entraînements et pour l'inférence. Avec un coût complet illustratif de 6 £ par heure GPU, le parc représente environ 8,8 millions d'heures GPU par an ; chaque point de goodput perdu coûte donc environ 530 000 £.
- Notre recommandation habituelle : Minerva Turnkey sur site, avec le collecteur déployé dans le cadre de DSX OS afin que l'alimentation et le refroidissement du site figurent sur la même chronologie que les GPU, et les incidents acheminés vers le ServiceNow du fournisseur.
- Où se trouve l'argent : supposons que la tâche d'entraînement d'un locataire couvre huit racks (576 GPU) et que chaque interruption fasse perdre environ 50 minutes de travail et de temps de redémarrage, soit environ 480 heures GPU. Passer d'une interruption tous les deux jours à une tous les trois jours évite environ 60 interruptions par an, soit environ 29 000 heures GPU ou 175 000 £ pour cette seule catégorie de tâches.
- Exemple : un nœud dont une connexion NVLink se dégrade lentement devient un retardataire. Sans corrélation, la tâche tourne simplement 15 % plus lentement et le client se plaint plusieurs jours plus tard. Avec la corrélation, le retardataire est identifié en quelques minutes, la tâche est déplacée hors du nœud à son prochain point de reprise et le tiroir est réparé pendant une fenêtre planifiée.
2. Une université avec un cluster Blackwell de 256 GPU
Trente-deux serveurs HGX B300, 256 GPU, partagés par des groupes de recherche via Slurm et exploités par une petite équipe centrale qui utilise déjà Grafana pour tout le reste. À 2,50 £ par heure GPU, 1 % de l'année du cluster représente environ 22 400 heures GPU, soit 56 000 £.
- Notre recommandation habituelle : commencer par DIY Observability, en envoyant les données collectées par Minerva dans le Grafana existant de l'équipe, les données GPU et de tâches étant étiquetées par tâche Slurm afin que chaque département voie sa propre utilisation. Passer à AIOps with DIY Observability lorsque l'équipe souhaite une analyse automatisée des causes premières des tâches en échec.
- Résultat pour l'organisation : des réponses fondées sur des preuves aux deux questions que reçoit tout service de calcul pour la recherche : « pourquoi ma tâche a-t-elle échoué ? » et « qui a utilisé les GPU ? ». Cela appuie la refacturation, les demandes de financement et un ordonnancement équitable.
- Remarque sur la fabric : si le réseau GPU du cluster est en InfiniBand plutôt qu'en Ethernet Spectrum-X, NVIDIA UFM reste l'outil qui exploite et surveille cette fabric ; voir notre article sur UFM. Nous vérifions auprès de NVIDIA comment les données de Minerva et d'UFM sont combinées pour la version que vous achetez.
3. Une entreprise disposant déjà de Grafana, ServiceNow et PagerDuty
Une société de services financiers exploite 128 GPU Blackwell (seize serveurs HGX B300) pour l'inférence interne, soit environ 2 milliards de tokens par jour. Son équipe d'exploitation vit déjà dans Grafana, ServiceNow et PagerDuty et ne veut pas d'une console supplémentaire.
- Notre recommandation habituelle : AIOps with DIY Observability, sur site pour la souveraineté des données. Les incidents corrélés de Minerva créent des tickets ServiceNow et des appels PagerDuty ; ses analyses apparaissent dans le Grafana existant ; Sherlock et le serveur MCP sont activés en lecture seule pour l'équipe plateforme.
- Résultat pour l'organisation (illustratif) : environ 3 000 alertes brutes par semaine deviennent quelques dizaines d'incidents, et les appels adressés à l'ingénieur d'astreinte passent de plus d'une centaine par semaine à une quinzaine. Le temps de réparation typique passe d'environ trois heures à moins d'une heure, car le ticket désigne déjà la cause.
- Impact en tokens : un ralentissement de quatre heures qui réduit le débit de 30 % coûte environ 100 millions de tokens de production. Le détecter en 30 minutes permet d'en conserver la plupart.
Minerva et UFM : qui fait quoi ?
Notre article précédent sur NVIDIA UFM présentait Unified Fabric Manager, le logiciel de NVIDIA pour exploiter et superviser les fabrics InfiniBand : gestion du sous-réseau, partitions, télémétrie de la fabric et prédiction des pannes. Minerva a un périmètre différent :
- UFM est un gestionnaire de fabric. Il configure et exploite un réseau InfiniBand et rend compte de son état de santé.
- Minerva est une plateforme AIOps pour l'ensemble de l'usine d'IA. Selon la description de NVIDIA, elle couvre le calcul, le scale-up NVLink, le scale-out et le scale-across Ethernet Spectrum-X, les ordonnanceurs, le stockage et les charges de travail, et son rôle est la corrélation et le diagnostic sur l'ensemble de ces éléments, pas l'exploitation du réseau.
Un cluster InfiniBand a donc toujours besoin d'un gestionnaire de sous-réseau tel qu'UFM, et une usine d'IA Spectrum-X tire son observabilité réseau de Minerva. Lorsqu'un site possède les deux, nous concevons un schéma d'étiquetage unique et un flux d'incidents unique pour que les deux n'appellent pas les équipes deux fois.
Ce que fait Workstation
Nous sommes revendeur et intégrateur britannique d'infrastructures d'IA NVIDIA. Pour Minerva, cela signifie :
- Fourniture. La licence Minerva selon le bon modèle, ainsi que les systèmes qu'elle surveille : racks Vera Rubin NVL72, systèmes DGX et HGX, Ethernet Spectrum-X, SuperNIC et DPU BlueField.
- Mise en place et intégration. Nous déployons les collecteurs et, si nécessaire, un niveau OpenTelemetry pour vos sources existantes ; connectons Minerva à Slack ou Teams, PagerDuty et ServiceNow ; alimentons Grafana ; configurons les métadonnées Slurm ou Run:ai ; et observons une période d'établissement des références avant que quoi que ce soit n'appelle qui que ce soit.
- Sécuriser l'automatisation. Les accès Sherlock et MCP démarrent en lecture seule. La remédiation passe par des playbooks Ansible approuvés avec des enregistrements de changement, et nous la validons par des exercices de panne avant la remise.
- Support et exploitation. Nos ingénieurs assurent au quotidien le support de Minerva et des services logiciels associés, ajustent la réduction du bruit, maintiennent le niveau collecteur sain et hautement disponible, et rendent compte chaque mois des heures GPU, du goodput, du MTBI et du MTTR. Nous travaillons aux côtés de votre équipe et du support NVIDIA.
Questions à se poser avant d'acheter
- Combien coûte une heure de votre usine d'IA, et quelle part de goodput pensez-vous perdre aujourd'hui ?
- Dans quels outils votre équipe d'exploitation vit-elle déjà, et Minerva doit-il les alimenter ou les remplacer ?
- La télémétrie et les métadonnées des tâches doivent-elles rester sur site, et qui peut les consulter ?
- Quel degré d'automatisation votre processus de gestion des changements autorisera-t-il, et qui l'approuve ?
- Votre fabric GPU est-elle en Ethernet Spectrum-X, en InfiniBand, ou les deux ?
Partenaire NVIDIA : ingénierie, logiciels et équipes
Workstation est partenaire NVIDIA. Au-delà de la fourniture du matériel, nous apportons l'ingénierie, les logiciels et le personnel nécessaires pour planifier, construire et exploiter des centres de données d'IA : études de site et d'alimentation, conception des racks et de la fabric, installation de Spectrum-X, NVLink et InfiniBand, mise en place de Minerva, UFM, DCGM et OpenTelemetry, intégration de Kubernetes, Run:ai et Slurm, et des ingénieurs qui vous accompagnent jusqu'à la remise et au-delà, dans le cadre du support géré. Pour la description du produit par NVIDIA elle-même, consultez la page officielle NVIDIA Minerva et la fiche technique de Minerva (toutes deux s'ouvrent dans un nouvel onglet).
Prochaines étapes
Ouvrez la galerie interactive de tableaux de bord pour découvrir les dix-sept vues que nous mettons en place autour d'un déploiement Minerva. Consultez ensuite NVIDIA Minerva dans notre boutique, ou demandez à notre ingénieur commercial IA de dimensionner le déploiement, le modèle de consommation et les systèmes qui l'entourent. Nous commençons volontiers par une revue d'observabilité d'un cluster d'IA que vous exploitez déjà.
Les chiffres de cet article sont des exemples illustratifs, et non des mesures provenant d'un client particulier.
Mention des droits : NVIDIA, le logo NVIDIA, Minerva, Sherlock (en tant que nom de l'assistant de NVIDIA), DSX, DSX OS, DGX, HGX, Vera Rubin, Blackwell, Spectrum, Spectrum-X, NVLink, ConnectX, SuperNIC, BlueField, DCGM, NCCL, Run:ai et Unified Fabric Manager (UFM) sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. Les produits et technologies NVIDIA peuvent être couverts par des brevets et d'autres droits de propriété intellectuelle détenus par NVIDIA Corporation, et tous ces droits sont reconnus et réservés à leurs titulaires. Les informations sur les produits sont résumées dans nos propres termes à partir des documents publics de NVIDIA ; le site web et la documentation de NVIDIA font foi. Les autres noms de sociétés et de produits, notamment Grafana, Prometheus, Slack, Microsoft Teams, PagerDuty, ServiceNow, Ansible, OpenTelemetry, Slurm et Kubernetes, peuvent être des marques de leurs propriétaires respectifs. Les tableaux de bord, configurations et textes propres à Workstation sont © Workstation.