NVIDIA RTX PRO 6000 Blackwell Server Edition : un seul GPU pour l'IA, le graphisme et la simulation dans une salle serveurs au Royaume-Uni
Ce qu'est la RTX PRO 6000 Server Edition, à qui elle convient, les configurations 2U, 4U et rack de 32 GPU, sa comparaison avec la L40S, et comment Workstation la livre
 Balinder Walia10 novembre 20268 min read
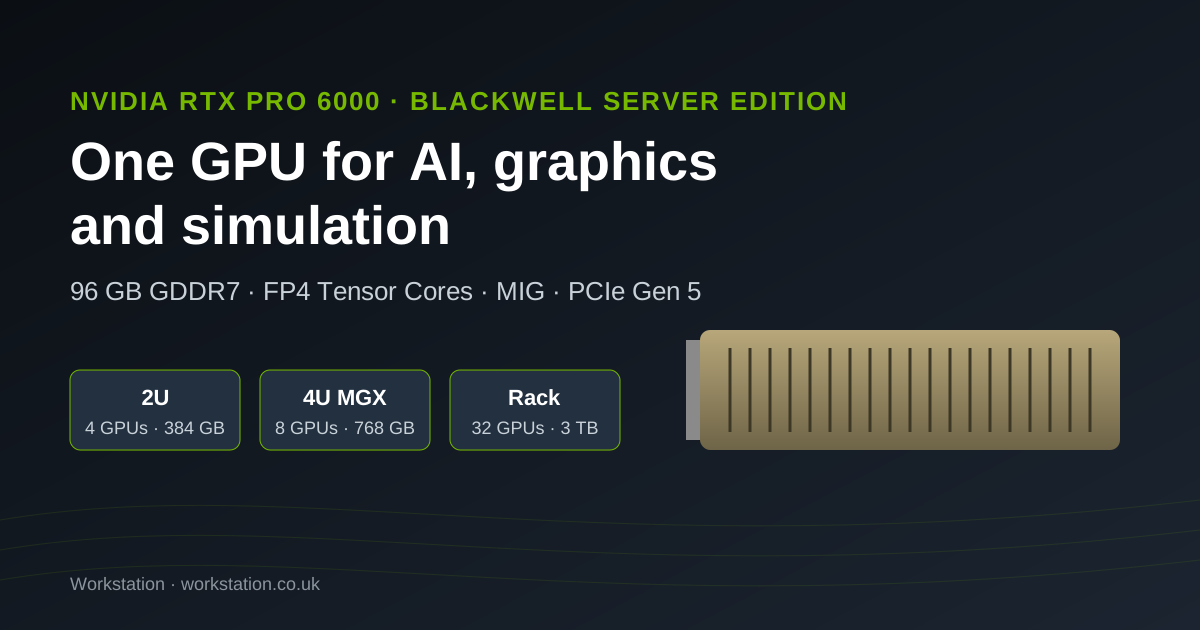
La plupart des entreprises qui veulent une IA privée n'ont pas besoin d'un supercalculateur. Elles ont besoin de quelques serveurs qui exécutent leurs modèles, le travail 3D de leurs concepteurs et leurs simulations, dans un rack dont elles disposent déjà, avec une consommation que leur bâtiment peut fournir. La RTX PRO 6000 Blackwell Server Edition de NVIDIA est conçue pour cette tâche. Cet article explique ce qu'elle est, à qui elle convient, les trois tailles de système que l'on achète et ce qu'il faut vérifier avant de commander.

Ce que c'est, en termes simples
NVIDIA vend deux types de GPU pour centre de données. Le premier est la famille HGX (B200, B300 et leurs successeurs) : huit GPU reliés par NVLink sur une seule carte, conçus pour entraîner les plus grands modèles. Le second est une carte PCIe qui s'insère dans un serveur ordinaire. La RTX PRO 6000 Blackwell Server Edition est la plus récente et la plus performante du second type, et elle succède à la L40S.
- 96 Go de mémoire GDDR7 par GPU, avec correction d'erreurs. La mémoire détermine la taille du modèle que vous pouvez exécuter et le nombre de personnes pouvant l'utiliser simultanément. 96 Go, c'est le double de la L40S.
- Tensor Cores de cinquième génération avec FP4. Le FP4 est un format numérique sur 4 bits qui réduit environ de moitié la mémoire et double la vitesse d'un modèle par rapport au FP8, pour les modèles qui conservent leur précision à ce niveau. NVIDIA annonce jusqu'à 4 PFLOPS en FP4 par carte.
- Du matériel graphique également. 188 RT Cores pour le ray tracing, quatre encodeurs vidéo, quatre décodeurs et quatre sorties DisplayPort 2.1. La même carte qui fait fonctionner un chatbot peut produire le rendu d'une visualisation de produit ou exécuter un jumeau numérique Omniverse.
- Un GPU ou quatre. Le Multi-Instance GPU (MIG) divise une carte en jusqu'à quatre GPU isolés, chacun avec sa propre mémoire et sa propre puissance de calcul, afin que les petites tâches et les équipes distinctes ne gaspillent pas une carte entière.
- Refroidissement par air ou par liquide. La carte refroidie par air est une carte passive, double slot, pleine longueur, qui s'appuie sur les ventilateurs du serveur. Une version simple slot refroidie par liquide convient aux configurations plus denses.
Pourquoi c'est important pour une entreprise britannique
Trois éléments en font un choix pratique pour les entreprises en dehors des hyperscalers.
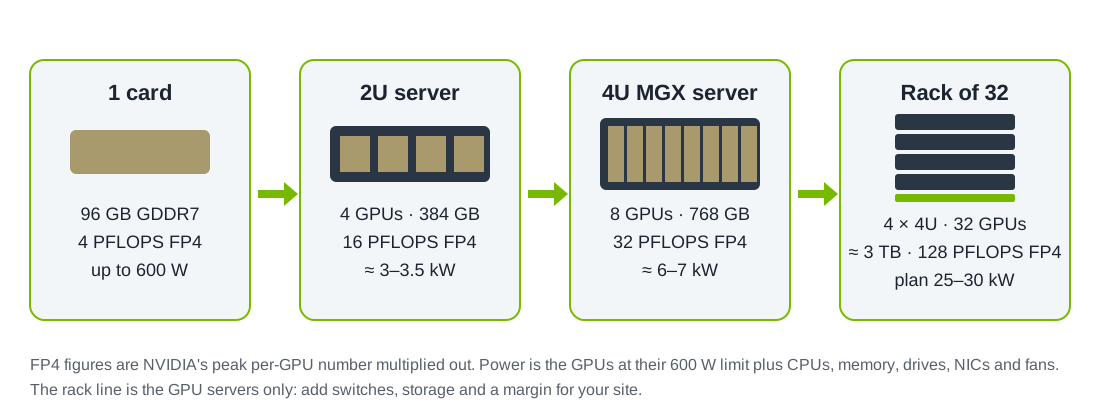
Elle s'adapte à la salle dont vous disposez. Un serveur à quatre GPU occupe 2U et consomme environ 3 à 3,5 kW à pleine puissance GPU. C'est à la portée de nombreuses salles serveurs et baies de colocation existantes, contrairement à un système HGX à huit GPU qui nécessite souvent 10 kW ou plus pour un seul serveur, et parfois un refroidissement liquide.
Elle sert plus d'une équipe. De nombreuses entreprises achètent du matériel d'IA pour un seul projet et le voient ensuite rester inutilisé. Comme la RTX PRO 6000 est aussi performante en graphisme qu'en IA, les mêmes serveurs peuvent exécuter l'inférence pour le service client le jour, et le rendu, la simulation ou l'affinage la nuit.
Vos données restent dans vos locaux. Exécuter des modèles sur votre propre matériel conserve les invites, les documents et les résultats dans votre bâtiment, ce qui facilite le respect du RGPD britannique, de la confidentialité des clients et des règles sectorielles. Une fois le matériel payé, une utilisation quotidienne intensive ne coûte que l'électricité, sans facture au token.
Trois tailles, du service au hall de centre de données
| Système | Mémoire GPU | Usage typique | Puissance à prévoir |
|---|---|---|---|
| 2U, quatre GPU | 384 Go | L'assistant privé d'un service, la recherche documentaire avec RAG, un premier service d'inférence en production | Environ 3 à 3,5 kW |
| 4U, huit GPU (NVIDIA MGX) | 768 Go | Plusieurs modèles à la fois, des modèles plus grands, de nombreux utilisateurs simultanés, un nœud de rendu partagé | Environ 6 à 7 kW |
| Un rack de 32 GPU | Environ 3 To | Inférence à l'échelle de l'entreprise, systèmes multi-agents, fermes de rendu, génération de données synthétiques | 25 à 30 kW par rack |
L'option à l'échelle du rack mérite qu'on s'y attarde. AMAX, un intégrateur de systèmes américain, commercialise une conception appelée RackScale 32 : 32 GPU RTX PRO 6000 Server Edition sur des processeurs AMD EPYC 9005 doubles dans des serveurs NVIDIA MGX, reliés par NVIDIA Spectrum-X Ethernet ou Quantum InfiniBand. Cela donne environ 3 To de mémoire GPU et, selon les chiffres de pointe de NVIDIA, 128 PFLOPS en FP4 dans un seul rack. AMAX la présente comme une brique de base pour une « usine d'IA » qui s'agrandit rack par rack. La brique de base à l'intérieur est un serveur MGX 4U à huit GPU, comme l'AceleMax AXG-428AG d'AMAX, avec de la place pour cinq cartes réseau à 400 Gb/s et huit disques E1.S.
Vous n'êtes pas obligé de commencer par un rack. La plupart de nos clients commencent avec un serveur 2U ou 4U, valident la charge de travail, puis ajoutent des serveurs de même configuration. Une configuration homogène simplifie cette croissance.
RTX PRO 6000 ou L40S ?
Si vous exploitez déjà des serveurs L40S, la RTX PRO 6000 Server Edition est la mise à niveau naturelle. Elle offre deux fois plus de mémoire, près de deux fois plus de bande passante (1 597 Go/s contre 864 Go/s), le FP4, le MIG et le PCIe Gen 5. Un modèle qui nécessitait deux cartes L40S tient souvent sur une seule RTX PRO 6000, ce qui économise des slots, de l'énergie et des licences. La L40S reste pertinente lorsque la puissance est limitée (350 W contre jusqu'à 600 W) ou lorsque vos modèles tiennent largement dans 48 Go.
Ce qu'elle ne fait pas
- Pas de NVLink. Les cartes communiquent via PCIe. Cela convient pour exécuter de nombreuses copies d'un modèle, ou un modèle réparti sur quelques GPU. Les grands entraînements qui exigent que les GPU partagent constamment des données relèvent des systèmes HGX.
- Les chiffres de pointe sont des pointes. Les chiffres FP4 et FP8 de NVIDIA sont des maximums. Votre débit dépend du modèle, de la précision, de la longueur du contexte et du logiciel ; c'est pourquoi nous mesurons votre charge de travail avant de dimensionner la commande.
- 600 W, c'est beaucoup de chaleur. Huit cartes à pleine puissance représentent près de 5 kW pour les seuls GPU. La limite de puissance peut être abaissée, ce qui sacrifie un peu de vitesse au profit de davantage de GPU par rack.
Comment Workstation la livre
- Dimensionnement. Nous déterminons la mémoire GPU, le nombre d'utilisateurs et le stockage à partir de vos modèles, de vos longueurs de contexte et du trafic attendu, et choisissons le plus petit système qui fait le travail.
- Vérification du site. Puissance par rack, refroidissement, charge au sol, liaisons réseau montantes et itinéraires d'accès, avant tout devis.
- Devis. Un devis écrit indiquant la configuration exacte, le délai, ainsi que l'alimentation et le refroidissement nécessaires. Les prix de ces systèmes varient avec l'approvisionnement en GPU ; nous les confirmons donc par écrit plutôt que de les deviner.
- Montage et test. Système d'exploitation, pilotes NVIDIA pour centre de données, CUDA, container toolkit et votre pile d'inférence ou de rendu, puis un rodage à pleine charge.
- Installation et support. Nous installons le système en rack, le câblons, vous le remettons et en assurons le support depuis le Royaume-Uni, avec la garantie du fabricant sur le matériel.
Pour tous les détails, des formules de dimensionnement de la mémoire et du MIG à la topologie PCIe, au réseau et à une liste de contrôle de déploiement, lisez notre guide technique de la RTX PRO 6000 Blackwell Server Edition. La page RTX PRO 6000 présente la spécification complète et les systèmes que nous fournissons.
Sources
- NVIDIA : RTX PRO 6000 Blackwell Server Edition
- AMAX : RackScale 32 avec NVIDIA RTX PRO 6000 Blackwell Server Edition
- AMAX : RTX PRO 6000 Blackwell Server Edition vs L40S
Marques commerciales. NVIDIA, le logo NVIDIA, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X et Quantum sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. AMAX et AceleMax sont des marques commerciales d'AMAX Engineering Corporation. AMD et EPYC sont des marques commerciales d'Advanced Micro Devices, Inc. Toutes les autres marques commerciales appartiennent à leurs propriétaires respectifs. Workstation est un fournisseur indépendant ; aucune approbation de la part de ces entreprises n'est sous-entendue. La vidéo appartient à NVIDIA.