NVIDIA NVKE et NVKR : pourquoi Kubernetes pour GPU devient le système d'exploitation de l'usine d'IA
Ce que NVIDIA a publié en open source à la KubeCon 2026, pourquoi c'est important et ce que cela signifie pour les développeurs et les ingénieurs DevOps
 Balinder Walia14 novembre 202611 min read
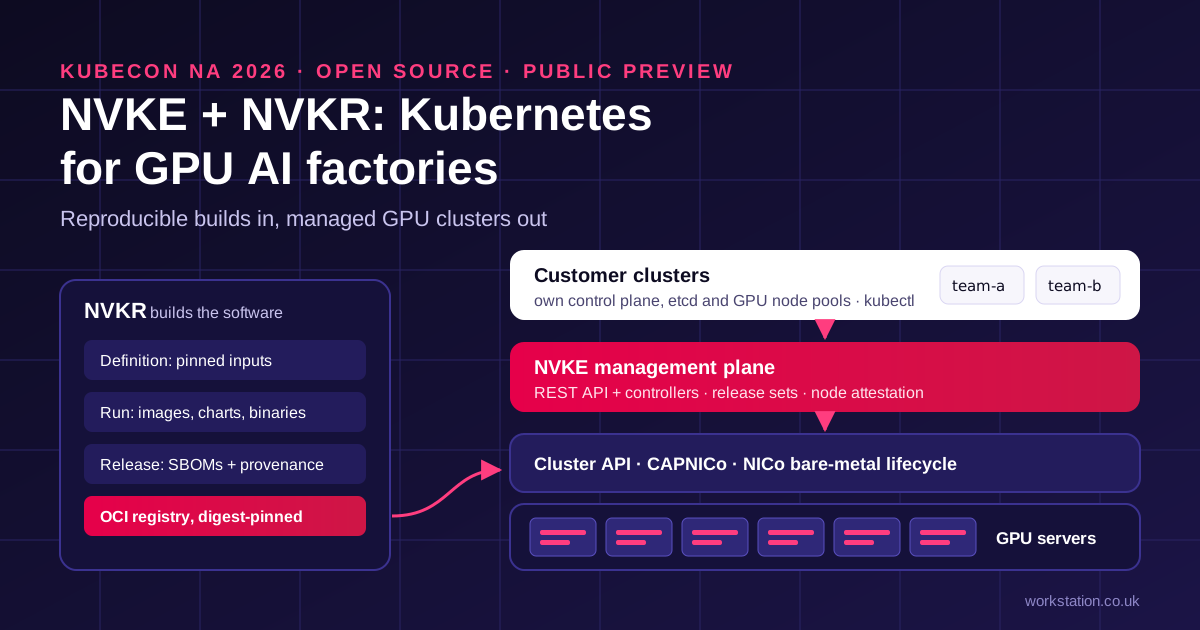
Lors de la KubeCon North America du 10 novembre 2026, NVIDIA a publié en open source deux projets : NVIDIA Kubernetes Engine (NVKE) et NVIDIA Kubernetes Recipes (NVKR). En apparence, il ne s'agit que d'outils Kubernetes supplémentaires. L'enjeu le plus important est la direction qu'ils indiquent : la capacité GPU est de plus en plus consommée via Kubernetes, et quelqu'un doit construire, exploiter et mettre à niveau ces clusters. Cet article explique simplement ce que font ces deux projets, pourquoi ils comptent, ce qu'ils signifient pour les développeurs et les ingénieurs DevOps, et qui devrait s'y intéresser dès maintenant.

Ce que NVIDIA a annoncé
NVIDIA a publié les deux projets sur GitHub au sein de son organisation DSX AI Factory, accompagnés d'une présentation détaillée sur le NVIDIA Technical Blog. Ce sont des composants de la NVIDIA DSX AI Factory Platform, la conception de référence de NVIDIA pour construire et exploiter des centres de données GPU.
- NVKE (NVIDIA Kubernetes Engine) est un plan de gestion. Vous l'installez une seule fois, sur un petit cluster de vos propres serveurs, et il crée et exploite des clusters Kubernetes distincts pour vos clients. Chaque cluster client dispose de son propre plan de contrôle, de sa propre base de données etcd et de ses propres pools de nœuds GPU. Vous les gérez via une API et un outil en ligne de commande appelé
nvkectl; vos clients utilisent leurs clusters avec lekubectlhabituel. - NVKR (NVIDIA Kubernetes Recipes) est un système de build et de publication. Il prend un ensemble déclaré de versions logicielles, construit les images de système d'exploitation des nœuds, les images de conteneurs, les charts Helm et les binaires, et enregistre exactement ce qui entre dans chacun d'eux, avec des nomenclatures logicielles (SBOM), une provenance et des signatures que vous pouvez vérifier au regard de votre propre politique.
Les deux peuvent être utilisés ensemble ou séparément. NVKE ne dépend pas de NVKR à l'exécution, et NVKR peut construire des artefacts pour d'autres systèmes de gestion Kubernetes. NVIDIA indique que NVKE est une Certified Kubernetes AI Platform et un Certified Kubernetes Installer, dont la conformité a été testée sur Kubernetes 1.36.
NVIDIA a également cité des premiers utilisateurs. Les NVIDIA Cloud Partners Firmus et SK Telecom intègrent NVKE et NVKR à leurs usines d'IA, et Mirantis, Rafay, Spectro Cloud, OpenNebula Systems et vCluster intègrent des composants à leurs offres Kubernetes gérées, Netris activant NVKE dans son automatisation réseau.
Pourquoi c'est plus important qu'un énième outil Kubernetes
Il y a cinq ans, « infrastructure GPU » désignait quelques serveurs sous un bureau et un identifiant partagé. Aujourd'hui, ceux qui achètent de la capacité GPU, qu'il s'agisse d'un groupe de recherche, d'une équipe produit ou d'un client externe, la veulent de plus en plus comme ils obtiennent tout le reste : sous la forme d'un cluster Kubernetes vers lequel ils peuvent diriger leurs outils existants. C'est une demande raisonnable. C'est aussi un service difficile à fournir. Derrière « donnez-moi un cluster avec quatre nœuds GPU » se cache une longue liste de tâches :
- trouver des serveurs libres et les démarrer avec le bon système d'exploitation, les bons pilotes et les bons agents ;
- s'assurer qu'un serveur vous appartient réellement avant qu'il ne rejoigne le cluster de qui que ce soit ;
- maintenir le cluster d'un client isolé de celui du suivant ;
- mettre à niveau Kubernetes et les images des nœuds sans interrompre les entraînements en cours ;
- savoir exactement quelles versions logicielles se trouvent sur chaque nœud en cas de problème, et pouvoir les reconstruire à l'identique plus tard ;
- et qualifier tout cela sur plusieurs générations de GPU et plusieurs versions de Kubernetes.
Les grands clouds publics ont résolu ce problème en interne, avec d'importantes équipes. NVKE et NVKR sont la tentative de NVIDIA de fournir les mêmes briques à tous ceux qui exploitent des GPU : clouds GPU spécialisés, opérateurs télécoms, usines d'IA souveraines, universités et entreprises disposant de leurs propres racks. Le signal intéressant n'est pas que NVIDIA ait écrit un installateur Kubernetes. C'est que l'entreprise qui fabrique les GPU considère désormais leur exploitation via Kubernetes comme faisant partie du produit.
Comment cela fonctionne, en quatre étapes

- Construire. NVKR construit l'image de nœud (une image disque sur laquelle sont installés Kubernetes, la pile réseau et les agents de nœud), l'image du contrôleur NVKE, son chart Helm et l'outil
nvkectl, le tout à partir de sources aux versions figées. - Amorcer.
nvkectldémarre un petit cluster temporaire sur une machine d'amorçage. Ce cluster temporaire demande trois serveurs à NVIDIA Infra Controller (NICo), le service de provisionnement bare metal de NVIDIA, les démarre à partir de l'image de nœud et leur passe la main. Les trois serveurs deviennent le cluster de gestion permanent et le cluster temporaire est supprimé. - Publier ce que les clients peuvent exécuter. L'opérateur publie des « release sets » : une combinaison nommée et testée d'image machine, de version de Kubernetes et de configuration de nœud. Les clients choisissent une release par son nom ; ils ne manipulent jamais d'images de système d'exploitation ni de scripts de démarrage.
- Créer des clusters. Un cluster client tient en une courte requête YAML : version de Kubernetes, trois serveurs de plan de contrôle, un pool de nœuds GPU d'une taille donnée. NVKE le provisionne, et l'opérateur remet au client un kubeconfig.
Deux choix de conception se distinguent. Premièrement, chaque nœud doit prouver son identité, au moyen de sa puce de sécurité matérielle (TPM) et du framework d'identité SPIFFE/SPIRE, avant de recevoir les identifiants qui lui permettent de rejoindre un cluster. Deuxièmement, NVKE utilise la Cluster API standard de Kubernetes pour dialoguer avec l'infrastructure, de sorte que la couche de provisionnement est une interface ouverte bien connue plutôt qu'une boîte noire. Notre note technique détaille chaque étape avec les commandes, la configuration et les versions figées.
Ce que « préversion publique » signifie réellement ici
NVIDIA est exceptionnellement direct sur les limites actuelles, et elles comptent pour quiconque planifie un service :
- Après l'installation, l'API NVKE fonctionne en HTTP simple avec l'authentification désactivée. Vous devez vous-même restreindre l'accès réseau, activer l'authentification et placer TLS devant elle.
- NVKE n'applique aucune autorisation : tout appelant authentifié peut créer ou supprimer le cluster de n'importe quel client.
- Le cluster de gestion ne se met pas à niveau, ne se met pas à l'échelle et ne se répare pas tout seul, et il n'existe pas encore de procédure documentée de mise à niveau ni de sauvegarde et restauration pour lui.
- Les clients reçoivent un kubeconfig administrateur qui ne peut pas être révoqué avant l'expiration de son certificat.
- NICo est le moyen par défaut (et, en pratique, le principal) d'obtenir des machines.
- Aucune release de NVKR n'est encore « qualifiée », et les images de nœud avec chiffrement intégral du disque sont réservées à l'évaluation.
Rien de tout cela n'est surprenant pour une première version publique, et les feuilles de route publiques montrent la direction prise. Mais cela signifie qu'aujourd'hui, NVKE est un produit à évaluer, pas un produit sur lequel bâtir un engagement de niveau de service.
Ce qu'il faut en retenir pour les développeurs et les ingénieurs DevOps
Une idée répandue veut que l'ingénierie de l'IA remplace le travail cloud et DevOps. Des annonces comme celle-ci suggèrent le contraire. L'IA crée des exigences nouvelles et plus difficiles précisément pour ces compétences.
Savoir appeler un grand modèle de langage via une API est utile. C'est aussi la partie la plus facile à apprendre et à automatiser. La profondeur d'ingénierie réside dans la compréhension de la façon dont les systèmes d'IA s'exécutent, passent à l'échelle et tombent en panne en production :
- Ordonnancement tenant compte des GPU. Comment Kubernetes place les charges de travail GPU, à quoi ressemblent des pools de nœuds par génération de GPU, et pourquoi un GPU inactif dans une tâche « en cours » est le bogue le plus coûteux que vous livrerez jamais.
- Infrastructure immuable et reproductible. Tout le principe de NVKR est que vous devez pouvoir dire exactement ce qui se trouve sur un nœud et le reconstruire octet par octet. C'est du DevOps et de la sécurité de la chaîne d'approvisionnement logicielle, appliqués à des parcs de GPU.
- Identité et isolement. L'attestation matérielle, le chiffrement etcd par cluster, l'isolement réseau entre locataires et une gestion rigoureuse des identifiants sont des compétences de sécurité de plateforme, pas de data science.
- Cycle de vie et mises à niveau. Déployer une nouvelle version de Kubernetes ou de pilote sur des nœuds GPU sans interrompre un entraînement d'une semaine est un problème de planification et d'automatisation.
- Observabilité. NVKE est livré avec une chaîne de télémétrie basée sur OpenTelemetry. Il faut encore quelqu'un pour décider quoi mesurer, où l'envoyer et ce qui doit réveiller un humain.
Si vous êtes développeur et que vous vous orientez vers l'IA, apprendre comment ces clusters sont construits et exploités vous rendra bien plus utile qu'un énième cours de prompt engineering. Si vous êtes déjà ingénieur plateforme ou DevOps, vos compétences ne deviennent pas obsolètes ; elles vont être recherchées sur une nouvelle catégorie de matériel, bien plus coûteuse.
Les plateformes Kubernetes centrées sur les GPU deviendront-elles un pilier de l'IA en entreprise ?
Notre avis : oui, mais pas de la manière que les gros titres pourraient laisser croire. La plupart des entreprises n'installeront pas NVKE elles-mêmes. Il est probable que les fournisseurs auprès desquels elles achètent de la capacité GPU, clouds GPU spécialisés, opérateurs télécoms, programmes d'IA souveraine et fournisseurs de services gérés, se standardisent sur une solution de ce type, car elle réduit le coût d'une offre « Kubernetes avec GPU » en tant que service. Les entreprises en ressentiront l'effet sous la forme de clusters GPU plus cohérents et plus portables, où qu'elles les louent ou les exploitent.
Pour les organisations qui exploitent leurs propres racks GPU, l'intérêt est le plus fort lorsque vous servez plusieurs équipes ou clients à partir d'un même parc matériel. Une équipe unique sur un cluster unique est généralement mieux servie aujourd'hui par une distribution Kubernetes mature et supportée, tout en empruntant à NVKR sa discipline d'images de nœud figées, signées et reproductibles.

Qui devrait s'intéresser à NVKE et NVKR dès maintenant
| Vous êtes | Que faire maintenant |
|---|---|
| Un cloud GPU, un hébergeur ou un opérateur télécom proposant Kubernetes à ses clients | Évaluez sérieusement NVKE. Lancez le démarrage rapide local, puis un laboratoire sur du matériel disponible avec NICo, et mettez chaque limitation de la préversion en regard de vos engagements de service. |
| Une entreprise ou une université partageant un parc GPU entre départements | Lancez le démarrage rapide local et suivez la feuille de route. Commencez dès maintenant à utiliser des images de nœud figées et signées, quel que soit votre installateur. |
| Une équipe unique disposant d'un cluster GPU | Conservez votre distribution actuelle. Empruntez à NVKR ses idées sur les builds reproductibles et les SBOM. |
| Pas encore d'exploitation de GPU | Apprenez d'abord le modèle d'exploitation sur un cluster GPU loué ou géré ; les compétences se transposent directement. |
Le démarrage rapide local ne nécessite qu'un hôte Linux ou une machine virtuelle disposant d'au moins 6 CPU, 12 GiB de mémoire libre et 100 GiB d'espace disque libre, ainsi que de Docker et de la prise en charge d'un TPM virtuel. Aucun GPU ni compte NVIDIA n'est requis ; une équipe plateforme n'a donc guère de raison de ne pas l'essayer.
Ce que fait Workstation
Nous concevons, fournissons et exploitons des infrastructures GPU pour des organisations britanniques, et Kubernetes est le moyen par lequel la plupart de nos clients les consomment.
- Clouds GPU privés. Nous planifions et construisons de A à Z des clouds GPU privés : serveurs, réseau, stockage et la couche Kubernetes par-dessus, dimensionnés avec nos outils de calcul de VRAM et d'évaluation de maturité.
- Plateformes Kubernetes pour l'IA. Nous mettons en place Kubernetes prêt pour les GPU, la livraison GitOps et les pipelines MLOps (voir nos articles sur l'exécution de vos propres LLM sur Kubernetes et sur Kubeflow et Argo CD), et nous pouvons vous aider à planifier une évaluation de NVKE et NVKR sur votre propre matériel.
- La location plutôt que l'achat. Si le capital est le frein, gpuleasing.co.uk compare la location et l'achat de serveurs GPU pour votre charge de travail.
Prochaines étapes
- Lisez la note technique sur NVKE et NVKR pour le workflow complet, la configuration, les versions figées et une liste de contrôle de durcissement pour la préversion.
- Essayez le démarrage rapide local du dépôt NVKE et parcourez le dépôt NVKR.
- Demandez à notre ingénieur commercial IA de dimensionner un cluster GPU pour vos charges de travail, ou contactez-nous au sujet d'une plateforme Kubernetes pour vos GPU.
Les informations sur NVKE et NVKR proviennent de l'annonce de NVIDIA et de la documentation publique des projets au 14 novembre 2026. Tous deux sont en préversion publique, et leurs API et leur comportement peuvent changer d'une version à l'autre.
Mention des droits : NVIDIA, le logo NVIDIA et DSX sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. Kubernetes est une marque déposée de The Linux Foundation. Les autres noms de produits et de sociétés mentionnés sont la propriété de leurs détenteurs respectifs. Tous ces droits sont reconnus et réservés à leurs titulaires.