Base de connaissances IA · Plateformes cloud d'IA
Tous les clouds d'IA, une seule équipe qui les connaît
Les hyperscalers pour les modèles gérés et les contrôles d'entreprise, les clouds GPU pour la capacité brute, les places de marché pour les heures les moins chères. L'équipe Workstation conçoit, sécurise et exploite l'IA sur chacun d'eux, en complément du matériel que vous possédez.
Hyperscalers
Amazon Web Services
Amazon Bedrock, SageMaker AI et la gamme la plus large de GPU et de puces sur mesure.
Lire le guide →
Google Cloud
Vertex AI, Gemini et des TPU aux côtés des GPU NVIDIA.
Lire le guide →
Microsoft Azure
Azure OpenAI et AI Foundry, intégrés à Microsoft 365 et Entra ID.
Lire le guide →
Oracle Cloud Infrastructure
Superclusters GPU bare metal et OCI Generative AI.
Lire le guide →Clouds GPU
CoreWeave
Un cloud natif Kubernetes conçu pour les grands clusters GPU.
Lire le guide →Lambda
Des instances et clusters GPU simples et rapides pour les équipes d'IA.
Lire le guide →Nebius
Un cloud d'IA complet avec clusters GPU et inférence gérée.
Lire le guide →
DigitalOcean
Des GPU Droplets pensés pour les développeurs et une plateforme d'agents.
Lire le guide →Places de marché GPU
Également pris en charge : Together AI, Fireworks AI, Groq, Hugging Face Inference Endpoints, Replicate, Crusoe, Hyperstack, Scaleway et OVHcloud.
Comment elles se comparent
La plupart des organisations en utilisent plusieurs : un hyperscaler pour les modèles gérés et la gouvernance, un cloud GPU pour l'entraînement ou l'inférence intensive, et leur propre matériel pour les workloads sensibles ou réguliers.
| Type | Points forts | Compromis | À utiliser pour |
|---|---|---|---|
| Hyperscalers (AWS, Google Cloud, Azure, Oracle) | Modèles gérés, identité, conformité, régions mondiales | Prix GPU plus élevés, quotas à gérer | API de production, données réglementées, agents gérés |
| Clouds GPU (CoreWeave, Lambda, Nebius, DigitalOcean) | GPU les plus récents, grands clusters, tarification plus simple | Moins de services gérés | Entraînement, fine-tuning, inférence à fort volume |
| Places de marché GPU (Vast.ai, RunPod) | Coût par heure GPU le plus bas, démarrage rapide | Fiabilité et confiance variables | Expériences, traitements par lots, points de terminaison qui descendent à zéro |
| Votre propre matériel Workstation | Coût fixe, contrôle total, les données restent dans vos locaux | Investissement initial, planification de capacité | Données sensibles, workloads réguliers, développement |
Faire passer l'IA à grande échelle avec Amazon Bedrock
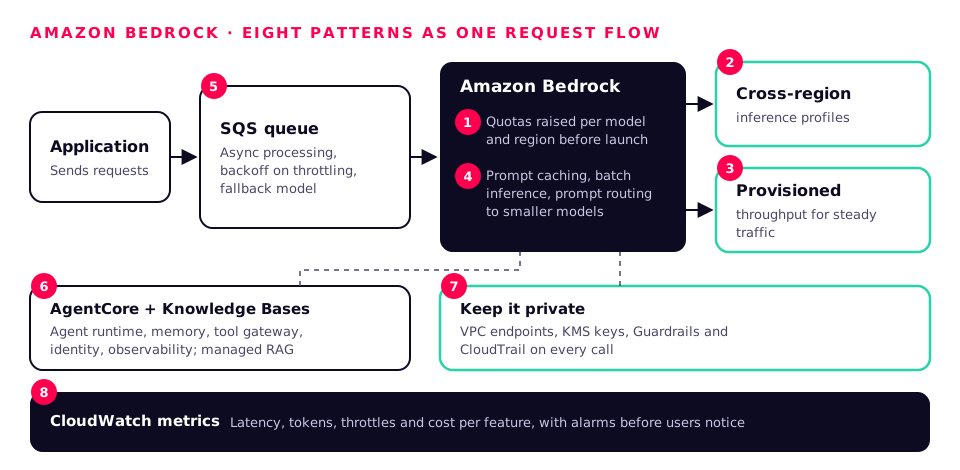
Bedrock élimine le problème des GPU, mais un trafic à grande échelle doit tout de même être conçu. Voici les modèles que nous utilisons pour les workloads Bedrock à fort volume.
- 1
Planifier d'abord les quotas
Modélisez les tokens par minute et les requêtes par minute face au trafic de pointe et relevez les quotas avant le lancement, par modèle et par région.
- 2
Répartir la charge
Les profils d'inférence interrégionaux répartissent automatiquement les requêtes entre régions quand l'une est saturée.
- 3
Garantir la capacité
Débit provisionné pour le trafic régulier et sensible à la latence ; à la demande pour le reste.
- 4
Réduire le coût par requête
Mise en cache des prompts pour le contexte répété, inférence par lots pour le travail hors ligne et routage des prompts pour envoyer les requêtes simples vers des modèles plus petits.
- 5
Absorber les pics
Mettez les requêtes en file (SQS) et traitez-les de façon asynchrone, avec backoff exponentiel en cas de limitation et un modèle de repli.
- 6
Exécuter correctement les agents
Bedrock AgentCore pour le runtime, la mémoire, la passerelle d'outils, l'identité et l'observabilité des agents ; Knowledge Bases pour le RAG géré.
- 7
Garder les données privées
Points de terminaison VPC, clés KMS, Guardrails et CloudTrail sur chaque appel.
- 8
Tout mesurer
Métriques CloudWatch pour la latence, les tokens, les limitations et le coût par fonctionnalité, avec des alarmes avant que les utilisateurs ne remarquent quoi que ce soit.
CI/CD pour les LLM, les agents et les données dans le cloud
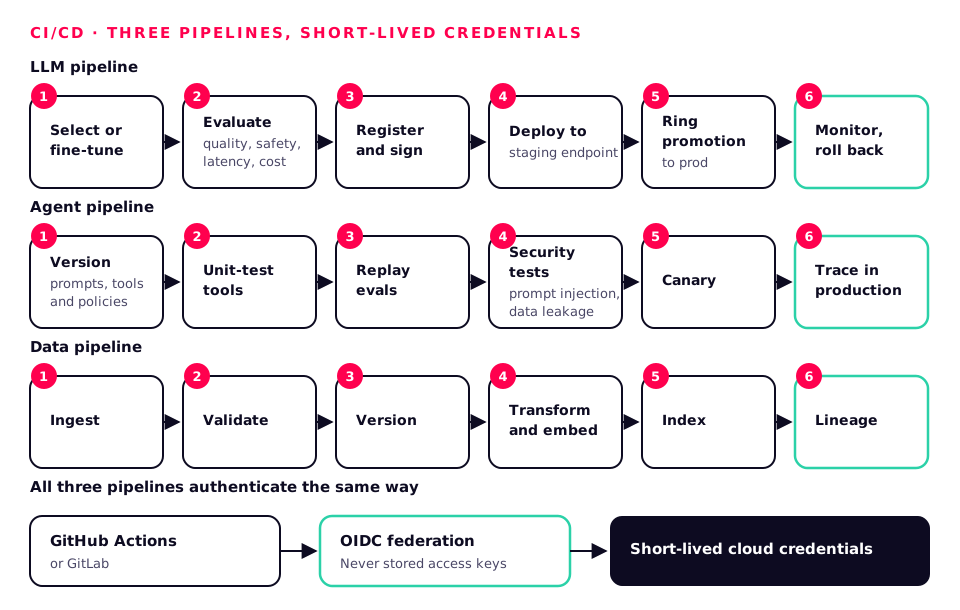
La même discipline que sur site : tout est versionné, testé, signé et promu par anneaux, avec l'infrastructure as code pour que chaque environnement soit reproductible.
Pipeline LLM
- Sélectionner ou fine-tuner
- Évaluer (qualité, sécurité, latence, coût)
- Enregistrer et signer
- Déployer sur un point de terminaison de préproduction
- Promotion par anneaux vers la production
- Superviser et revenir en arrière
Évaluation Bedrock, Vertex AI ou Azure AI Foundry ; pipelines SageMaker ou Vertex ; registre MLflow ; Terraform ou OpenTofu ; Ring Promoter pour des mises en production contrôlées par health checks.
Pipeline d'agents
- Versionner prompts, outils et politiques
- Tester unitairement les outils
- Rejouer les évaluations
- Tests de sécurité (injection de prompt, fuite de données)
- Canary
- Tracer en production
AgentCore, Agent Engine ou Foundry Agent Service ; traçage OpenTelemetry ; suites d'évaluation dans la CI.
Pipeline de données
- Ingérer
- Valider
- Versionner
- Transformer et vectoriser
- Indexer
- Lignage
AWS Glue, Dataflow ou Data Factory ; Airflow ou Dagster ; Bedrock Knowledge Bases, Vertex AI Search ou Azure AI Search ; OpenLineage.
Les pipelines s'exécutent avec des identifiants cloud éphémères via la fédération OIDC depuis GitHub Actions ou GitLab, jamais avec des clés d'accès stockées.
Sécuriser les API des LLM et des agents
Un point de terminaison LLM est une API que l'on peut convaincre de faire des choses. Nous le sécurisons comme toute API critique, puis ajoutons les contrôles propres à l'IA.
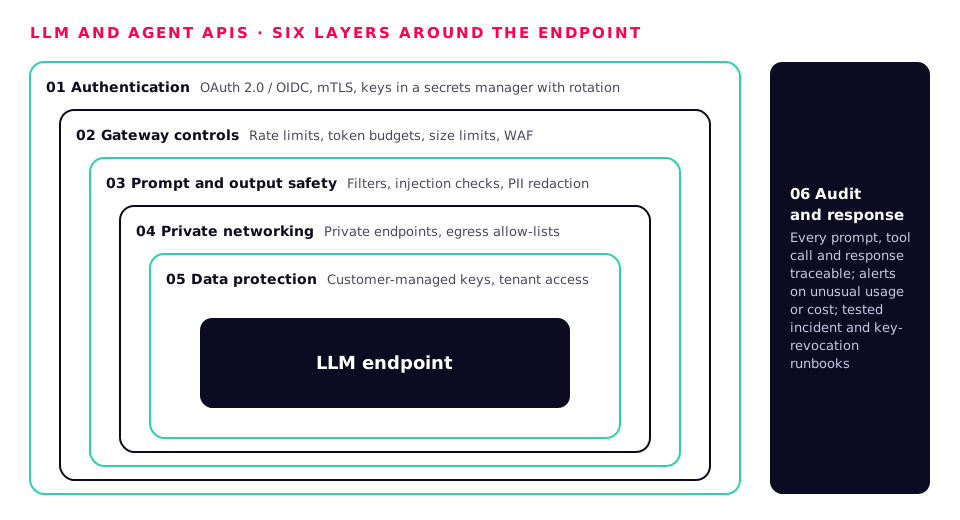
01
Authentification
- OAuth 2.0 / OIDC pour les utilisateurs et les services
- mTLS entre services
- Pas de clés API statiques dans le code ; clés dans un gestionnaire de secrets avec rotation
02
Contrôles de passerelle
- Limites de débit et budgets de tokens par utilisateur et par locataire
- Limites de taille des requêtes et de contexte
- WAF devant les points de terminaison publics
03
Sécurité des prompts et des sorties
- Guardrails, Model Armor ou Content Safety sur les entrées et les sorties
- Détection de l'injection de prompt dans les documents récupérés et les résultats d'outils
- Masquage des données personnelles avant journalisation
04
Réseau privé
- Points de terminaison privés pour les API de modèles
- Listes d'autorisation de sortie pour les agents et les outils
- Pas d'IP publiques sur les serveurs de modèles
05
Protection des données
- Clés gérées par le client
- Accès au niveau du locataire et du document lors de la recherche
- Résidence des données dans des régions Royaume-Uni ou UE si nécessaire
06
Audit et réponse aux incidents
- Chaque prompt, appel d'outil et réponse traçable
- Alertes en cas d'utilisation ou de coût inhabituels
- Runbooks d'incident et de révocation de clés testés
Le harnais d'agents IA
Un agent, c'est un modèle plus un harnais : le code qui décide de ce qu'il peut voir, des outils qu'il peut appeler et du moment où une personne doit approuver. C'est dans le harnais que résident la sécurité et la fiabilité.
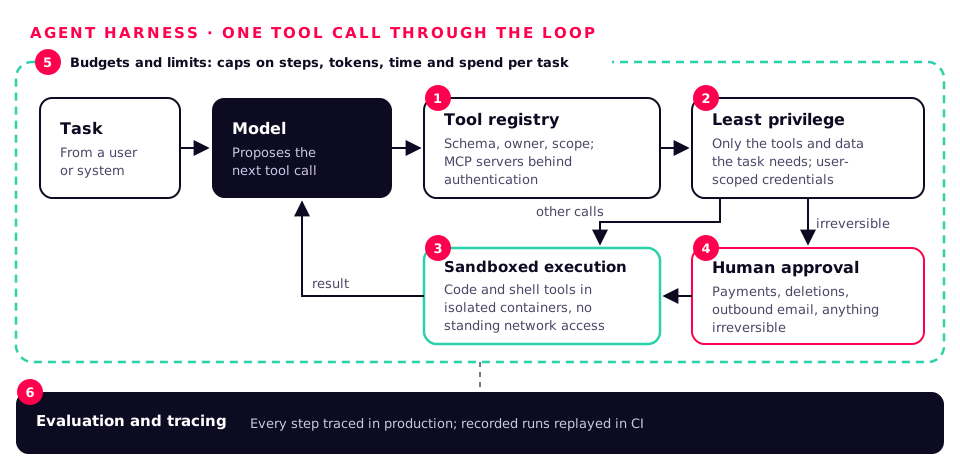
Registre d'outils
Chaque outil est déclaré avec un schéma, un responsable et une portée de permissions ; serveurs MCP derrière une authentification.
Moindre privilège
Chaque agent ne reçoit que les outils et données nécessaires à sa tâche, avec des identifiants limités à l'utilisateur pour lequel il agit.
Exécution en sandbox
Les outils de code et de shell s'exécutent dans des conteneurs isolés, sans accès réseau permanent.
Humain dans la boucle
Approbations pour les paiements, les suppressions, les e-mails sortants et tout ce qui est irréversible.
Budgets et limites
Plafonds d'étapes, de tokens, de temps et de dépenses par tâche, avec un échec propre lorsqu'ils sont atteints.
Évaluation et traçage
Exécutions enregistrées rejouées dans la CI, et chaque étape tracée en production pour le débogage et l'audit.
Identité et authentification pour l'IA
Les agents agissent pour le compte de personnes et de systèmes ; ils ont donc besoin de véritables identités, pas de clés partagées.
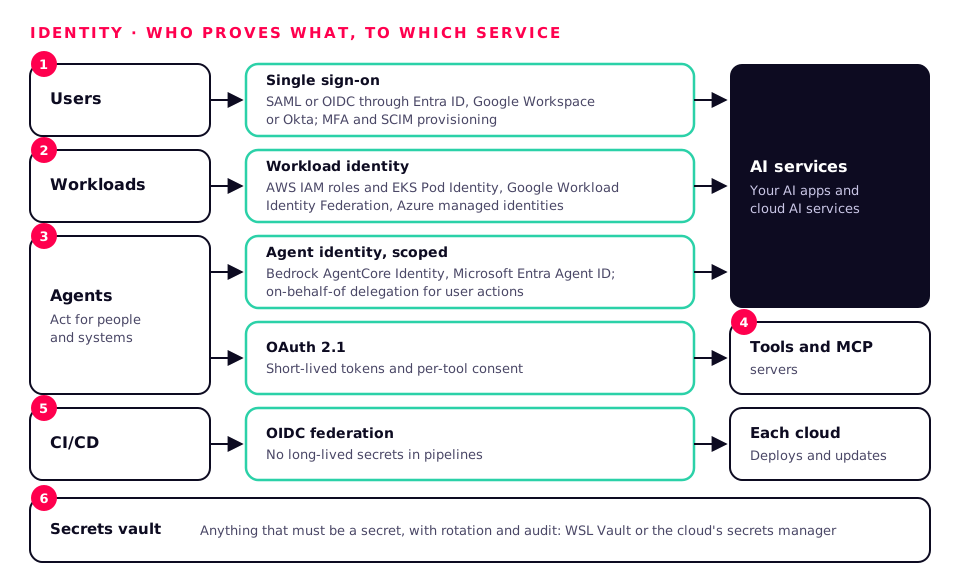
Utilisateurs
Authentification unique via votre fournisseur d'identité (Entra ID, Google Workspace, Okta) avec SAML ou OIDC, MFA et provisionnement SCIM.
Workloads
Workload identity native du cloud : rôles AWS IAM et EKS Pod Identity, Google Workload Identity Federation, identités managées Azure.
Agents
Des identités d'agents avec leurs propres permissions à portée limitée, comme Bedrock AgentCore Identity et Microsoft Entra Agent ID, avec délégation on-behalf-of pour les actions des utilisateurs.
Outils et MCP
OAuth 2.1 pour les serveurs MCP et les outils tiers, jetons éphémères et consentement par outil.
CI/CD
Fédération OIDC de votre CI vers chaque cloud, pour que les pipelines ne détiennent aucun secret de longue durée.
Secrets
Un coffre-fort pour tout ce qui doit rester secret, avec rotation et audit, comme notre WSL Vault ou le gestionnaire de secrets du cloud.
Optimiser les workloads d'IA dans le cloud
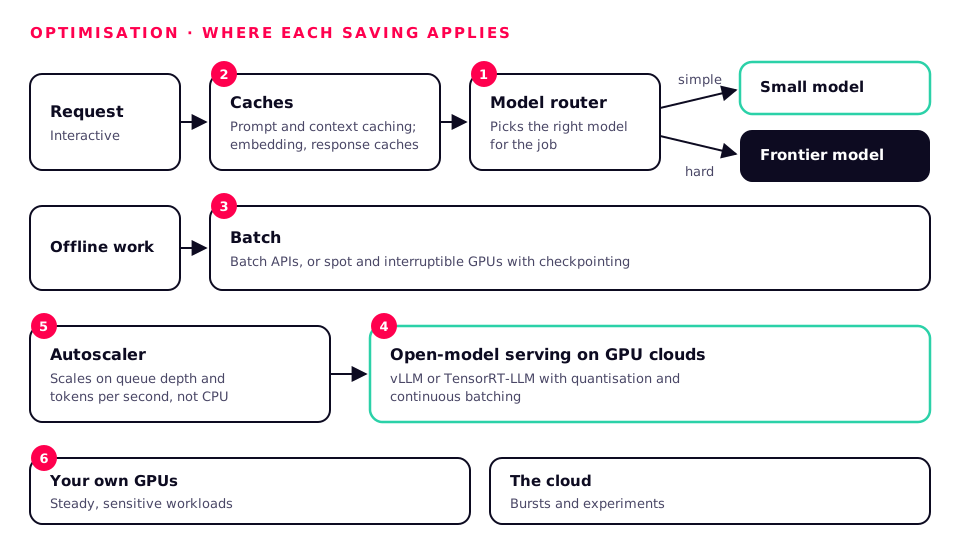
- Le bon modèle pour chaque tâche : orientez les requêtes simples vers de petits modèles et réservez les modèles de pointe aux plus difficiles.
- Mettez en cache tout ce qui peut l'être : cache des prompts et du contexte, caches d'embeddings et caches de réponses pour les questions répétées.
- Traitez le travail hors ligne par lots : API de traitement par lots et GPU spot ou interruptibles avec points de reprise.
- Servez efficacement les modèles ouverts : vLLM ou TensorRT-LLM avec quantification et batching continu sur des clouds GPU.
- Déclenchez l'autoscaling sur le bon signal : profondeur de file et tokens par seconde, pas le CPU.
- Hybride par conception : les workloads réguliers et sensibles sur vos propres GPU, les pics et les expériences dans le cloud.
Avec le support de l'équipe Workstation
Nous sommes neutres vis-à-vis des plateformes. Nous vous aidons à choisir, puis à concevoir, sécuriser, déployer et exploiter l'IA sur n'importe lequel de ces clouds, en complément de votre propre matériel.
- Architecture et choix de plateforme, modélisation des coûts comprise
- Landing zones avec identité, réseau et chiffrement
- Solutions et agents Bedrock, Vertex AI et Azure AI Foundry
- Construction de clusters GPU sur des clouds GPU
- CI/CD, évaluation et mises en production par anneaux
- Revues de sécurité des API de LLM et d'agents
- Configurations hybrides avec du matériel Workstation sur site
Les logos sont des marques de leurs propriétaires respectifs, utilisés uniquement pour identifier chaque plateforme, et proviennent de Wikimedia Commons. Schémas réalisés par l'équipe Workstation.