Base de connaissances IA · Plateformes cloud d'IA · Hyperscalers
Amazon Web Services
Amazon Bedrock, SageMaker AI et la gamme la plus large de GPU et de puces sur mesure.
Idéal pour: Les entreprises qui veulent un accès géré à de nombreux modèles de fondation, une gouvernance solide et la possibilité d'entraîner et d'héberger leurs propres modèles.
Services d'IA
- Amazon Bedrock : une seule API pour les modèles de fondation d'Anthropic (Claude), Meta (Llama), Mistral, Cohere, Amazon Nova et d'autres, avec Knowledge Bases pour le RAG, Guardrails, l'inférence par lots et l'évaluation des modèles.
- Bedrock AgentCore : runtime, mémoire, passerelle, identité et observabilité gérés pour des agents de production construits avec n'importe quel framework.
- Amazon SageMaker AI : entraînement, fine-tuning et hébergement, avec SageMaker HyperPod pour des clusters d'entraînement à grande échelle résilients.
- Amazon Q pour les développeurs et les utilisateurs métier.
GPU et accélérateurs
- EC2 P5 (H100), P5e/P5en (H200), P6 (Blackwell) et GB200 UltraServers.
- Instances AWS Trainium et Inferentia pour un entraînement et une inférence moins coûteux.
- EKS avec Karpenter pour l'autoscaling des GPU ; capacity blocks pour du temps GPU réservé.
Agents et identité
- AgentCore Identity pour les identifiants des agents et l'OAuth vers les outils tiers ; des rôles IAM pour chaque workload.
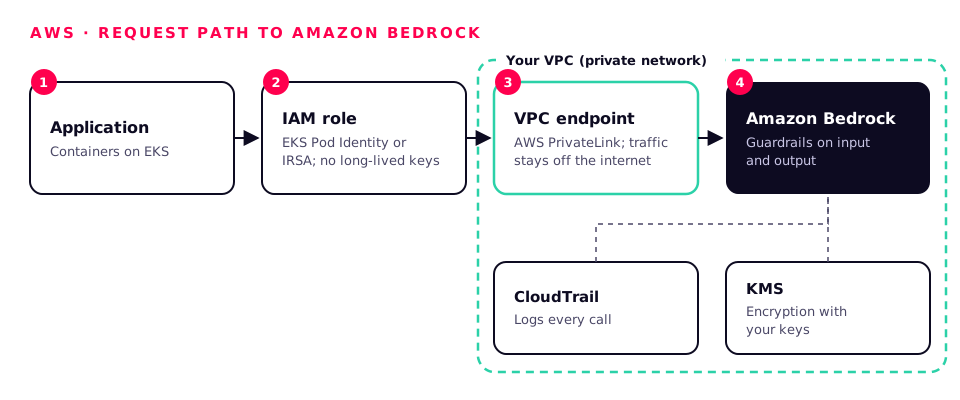
- EKS Pod Identity ou IRSA pour que les conteneurs ne détiennent jamais de clés de longue durée.
Sécurité et données
- Bedrock n'utilise ni vos prompts ni vos sorties pour entraîner les modèles de base.
- PrivateLink (points de terminaison VPC) maintient le trafic des modèles hors d'Internet ; chiffrement KMS ; CloudTrail journalise chaque appel.
- Guardrails pour le filtrage de contenu, les sujets interdits, le masquage des données personnelles et les contrôles d'ancrage.
Passage à l'échelle et optimisation
- Profils d'inférence interrégionaux pour absorber les pics de trafic ; débit provisionné pour une capacité garantie.
- Mise en cache des prompts, inférence par lots et routage intelligent des prompts pour réduire le coût par requête.
Régions Royaume-Uni et UE
Londres (eu-west-2) et régions de l'UE ; vérifiez la disponibilité des modèles par région.
Points de vigilance
Les quotas par modèle (tokens et requêtes par minute) doivent être relevés bien avant le lancement.
Comment Workstation vous aide: Nous concevons des architectures Bedrock, modélisons et relevons les quotas, construisons des agents sur AgentCore et connectons AWS à vos GPU sur site.
Faire passer l'IA à grande échelle avec Amazon Bedrock →CI/CD pour les LLM, les agents et les données dans le cloud →Sécuriser les API des LLM et des agents →Le harnais d'agents IA →Identité et authentification pour l'IA →
Autres fournisseurs avec lesquels nous travaillons
Les logos sont des marques de leurs propriétaires respectifs, utilisés uniquement pour identifier chaque plateforme, et proviennent de Wikimedia Commons. Schémas réalisés par l'équipe Workstation.