Le blog Workstation
AI Agents
Articles étiquetés AI Agents.
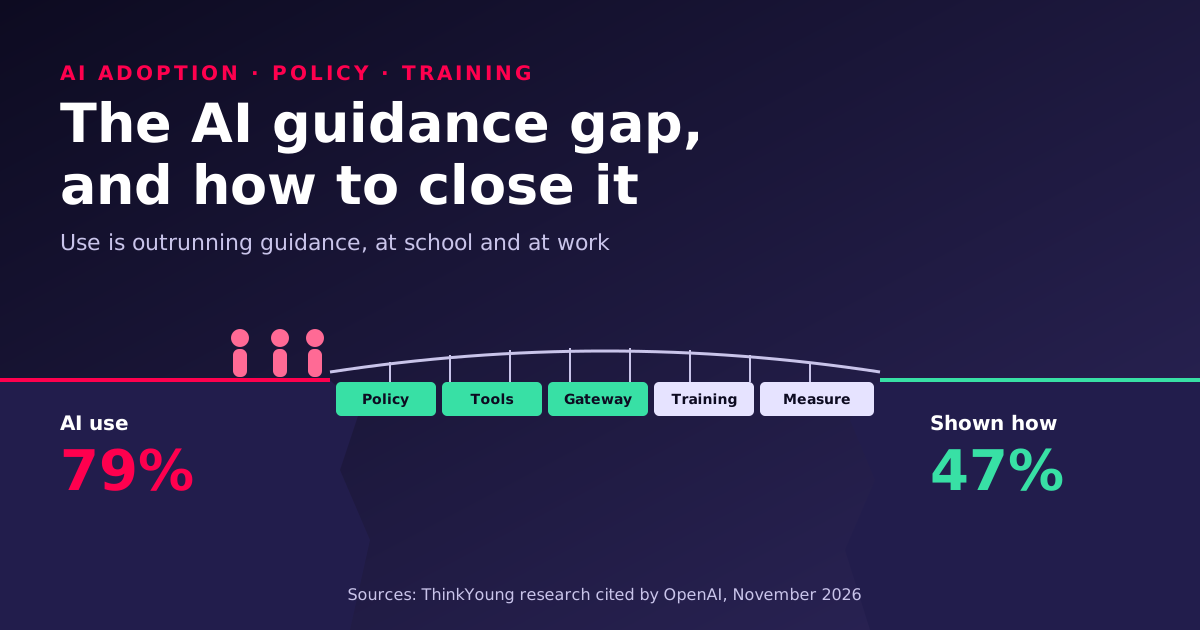
The AI Guidance Gap: Use Outpaces Training at School and at Work
79% of students use AI for homework but only 47% were shown how, according to ThinkYoung research cited by OpenAI. Workplaces show the same gap. A 90-day playbook for business leaders: policy by data class, approved tools, a gateway, role-based training and usage metrics.
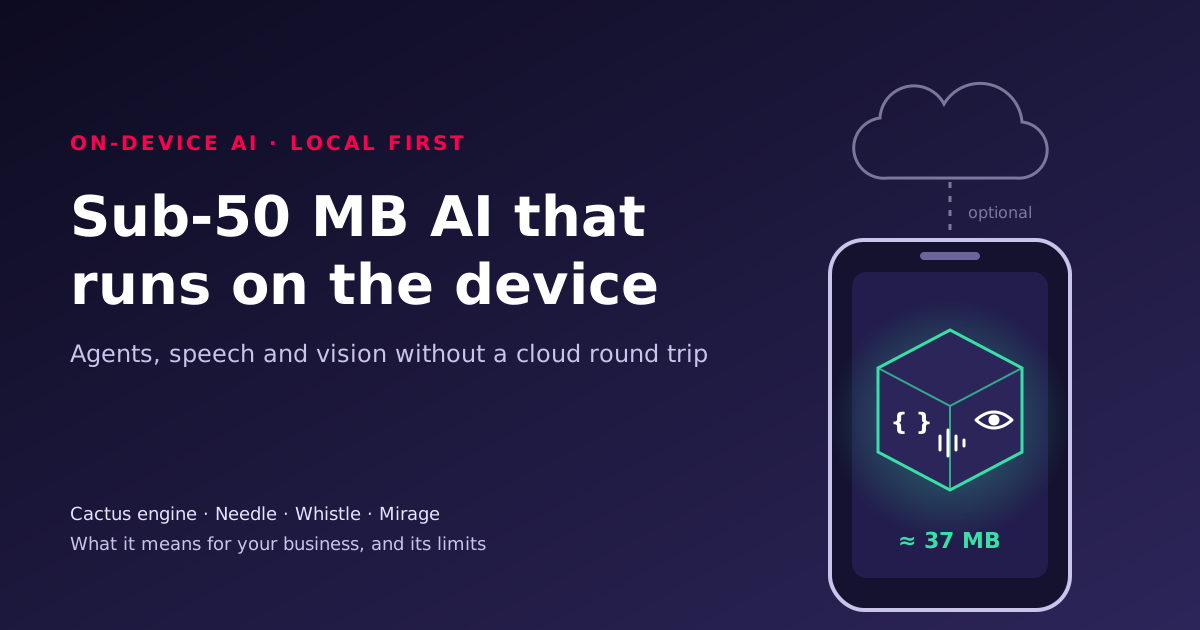
Sub-50 MB On-Device AI: What Cactus's Engine Means for Business
Cactus Compute's open-source engine (not NVIDIA's, as first reported) runs tool calling, speech and vision models under 50 MB each on phones and laptops. What it is, what we measured, its limits, and which AI tasks belong on the device.
Depuis la salle de la GTC Berlin : pour Huang, l'IA est désormais productive
Les ingénieurs de Workstation étaient à STATION-Berlin pour la keynote du 21 octobre 2026. Huang est passé des usines aux agents qui consomment des tokens.
 Balinder WaliaLire
OpenShell, annoncé à la GTC Berlin : la politique hors de l'agent
Le film de Huang sur la sécurité a rejeté le « s'il vous plaît, ne le faites pas » comme moyen de contrôle. OpenShell applique une politique aux appels système, aux fichiers et au réseau, avec Sentry sur BlueField-4.
Balinder WaliaLire 
La diapositive de Berlin qui sépare documents et bases de données
Nemotron Parse, Embed, cuVS et Rerank sur une ligne. Auto-Ontology, cuDF et Kumo sur l'autre. L'exemple de Huang sur le retard fournisseur utilise les deux.
Balinder WaliaLire 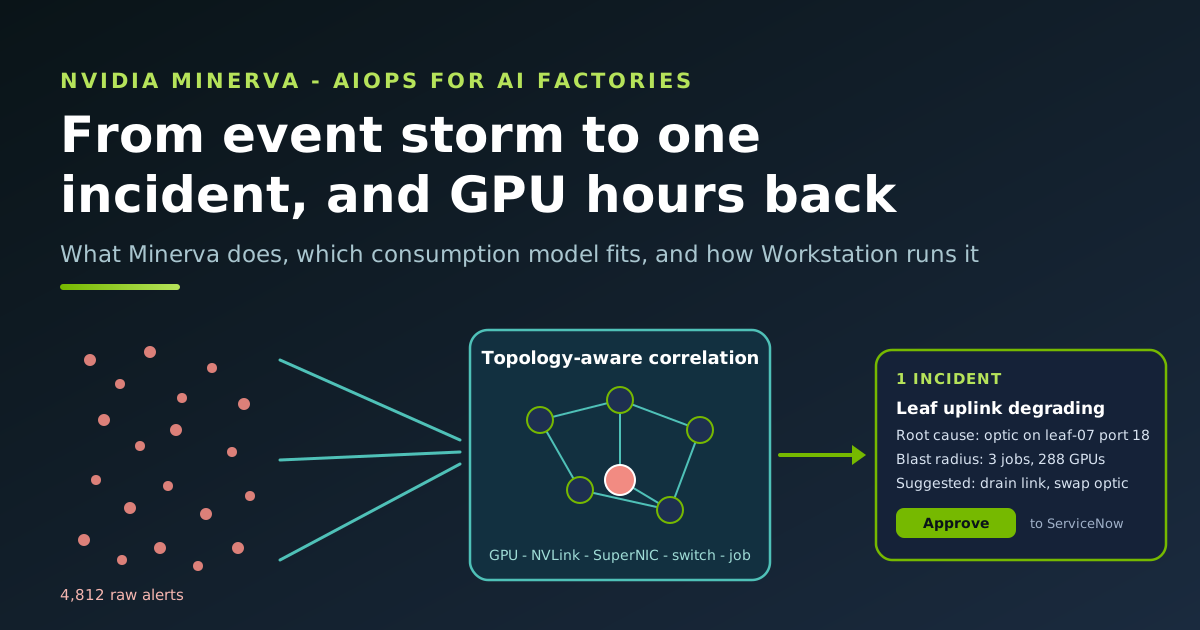
NVIDIA Minerva pour les usines d'IA : transformer les tempêtes d'alertes en heures GPU récupérées
Une seule optique qui se dégrade peut déclencher des milliers d'alertes et bloquer un millier de GPU. Ce que fait NVIDIA Minerva, ce qu'il vaut en heures GPU, goodput, MTBI, MTTR et tokens, lequel de ses trois modèles de consommation convient, des exemples chiffrés pour un néocloud Vera Rubin NVL72, un cluster Blackwell universitaire et une entreprise équipée de Grafana et ServiceNow, et son lien avec UFM.
Balinder WaliaLire 
Créer des agents IA avec NebulaDB : recherche sémantique, RAG et un agent IA pour les visas
Comment nous avons construit la recherche sémantique, le RAG et un agent IA pour les visas thaïlandais sur NebulaDB, avec de vraies requêtes, des plans de requête et des scores de récupération mesurés sur notre serveur de production de 8,3 millions de documents, ainsi que les garde-fous qui empêchent les données privées et les chiffres inventés d'apparaître dans les réponses.
Balinder WaliaLire 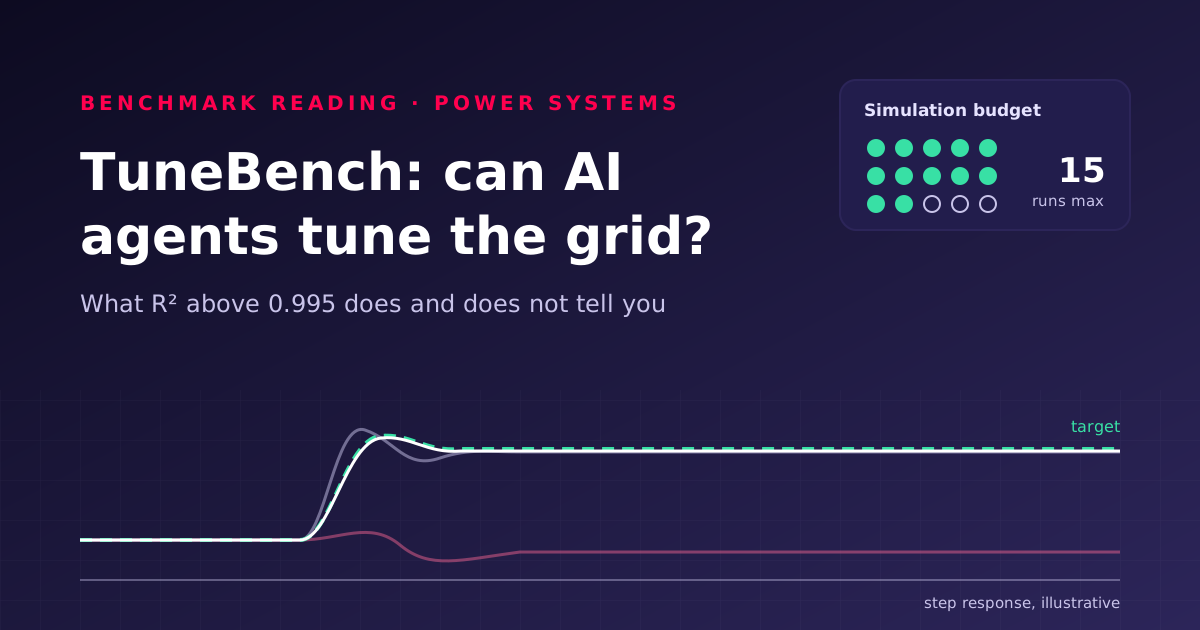
TuneBench: How Well Can AI Agents Calibrate Power System Models?
TuneBench tests LLM agents on calibrating generator and battery models within 15 simulations. Only Opus 5.5 and GPT-6 hit median R² above 0.995 in every test. What that figure means, its limits, and how to build the same kind of benchmark.
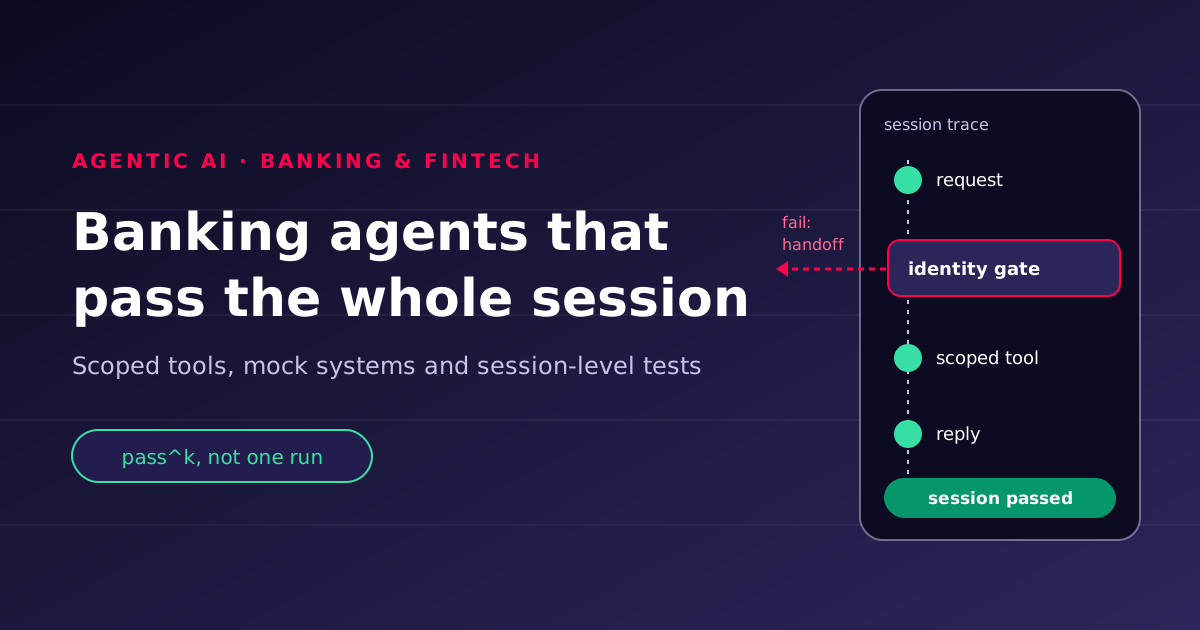
Agentic AI in banking: efficiency you can defend to a risk committee
Banking AI agents rarely fail on one bad reply; they fail across a session. How to scope tools, test whole conversations against mock systems and measure reliability with pass^k, so the time saved survives audit and production.
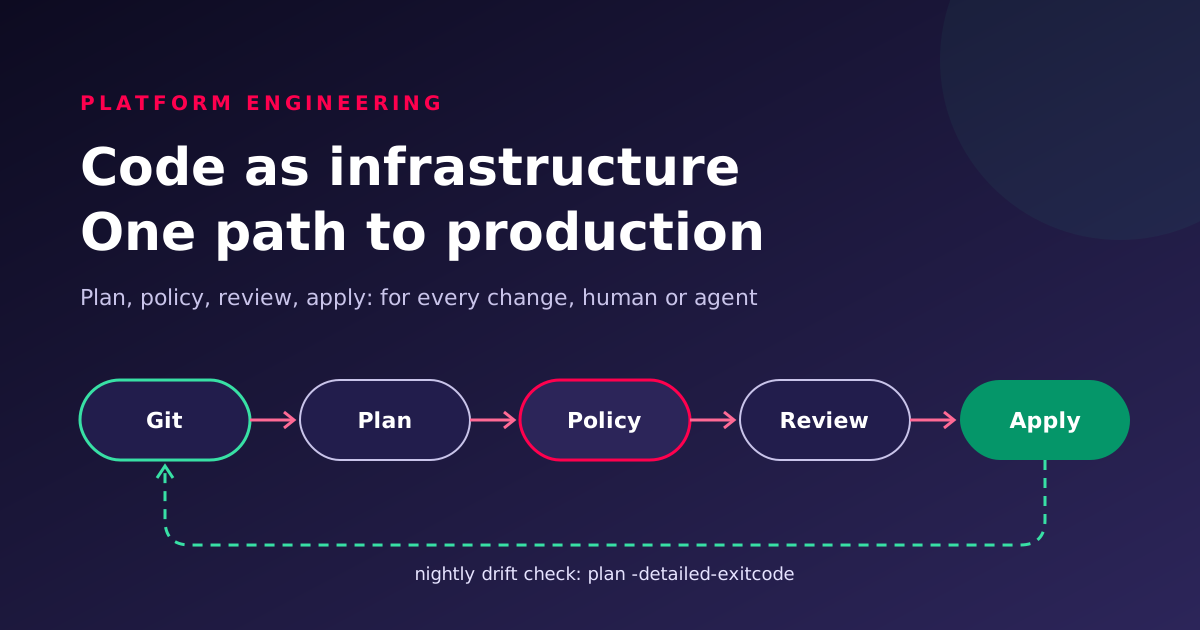
Code as infrastructure: one reviewed path for every production change
Infrastructure as code made servers into files. Code as infrastructure goes further: desired state, policy, pipelines and AI agent access all live in Git, are checked by policy, applied by automation and watched for drift. A practical playbook.