Base de connaissances IA · Système d'exploitation Linux
Linux, optimisé pour l'IA
Tous les systèmes d'IA que nous livrons tournent sous Linux. Ce guide présente les distributions prises en charge par l'équipe Workstation, la manière dont nous les durcissons, les réglages du noyau et des pilotes qui comptent pour les GPU, la façon dont nous les exécutons sous Kubernetes et Docker, la montée en charge des API LLM qui s'appuient dessus, et les pipelines CI/CD qui amènent modèles, agents et données en production en toute sécurité.
- Ubuntu
- Red Hat Enterprise Linux
- SUSE Linux
- Alpine Linux
- Debian
- Rocky et AlmaLinux
Choisir une distribution
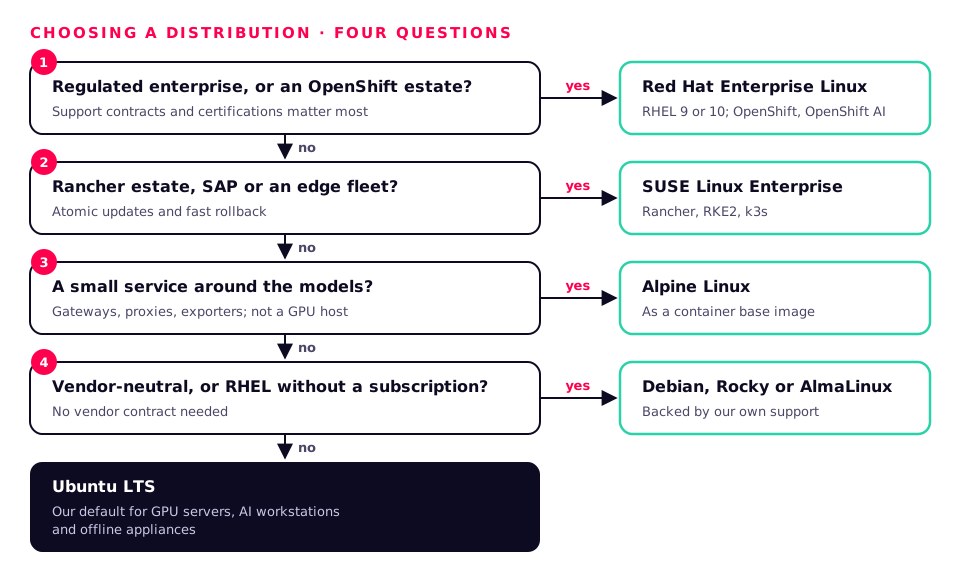
Il n'existe pas de meilleur Linux unique pour l'IA. Le bon choix dépend de l'endroit où il s'exécute, de qui le prend en charge et de ce dans quoi il doit s'intégrer. Voici comment nous décidons habituellement.
| Distribution | Idéal pour | GPU et CUDA | Kubernetes | Cycle de vie |
|---|---|---|---|---|
| Ubuntu LTS | Serveurs GPU, stations de travail, la plupart des équipes IA | Support de premier ordre : NVIDIA développe et teste ici en premier ; pilotes signés | Canonical Kubernetes, MicroK8s, k3s, RKE2 | 5 ans, plus de 10 avec Ubuntu Pro |
| Red Hat Enterprise Linux | Entreprises réglementées, parcs OpenShift | Dépôt NVIDIA CUDA et branches de pilotes ; RHEL AI | OpenShift, OpenShift AI | 10 ans, plus le support étendu |
| SUSE Linux Enterprise | Parcs Rancher, SAP et flottes edge | Paquets signés du pilote noyau open source NVIDIA ; SUSE AI | Rancher, RKE2, k3s | Cycle de vie long avec LTSS |
| Alpine Linux | Conteneurs minimaux, passerelles et services edge | Pas pour les hôtes GPU (musl, pas de CUDA) | Comme image de base de conteneur | Environ 2 ans par version |
| Debian | Serveurs et laboratoires stables, indépendants des fournisseurs | Pilotes NVIDIA dans non-free ; dépôt CUDA | k3s, kubeadm, RKE2 | Environ 5 ans avec LTS |
| Rocky et AlmaLinux | Compatible RHEL sans abonnement | Mêmes paquets que RHEL | kubeadm, RKE2, k3s, OKD | Environ 10 ans |
Les distributions que nous prenons en charge
Ubuntu
Le choix par défaut pour les serveurs GPU et les stations de travail IA.
L'essentiel de l'écosystème de l'IA est d'abord développé et testé sur Ubuntu. Les conteneurs NGC de NVIDIA, la documentation CUDA et de nombreux installateurs de frameworks le supposent, ce qui signifie moins de surprises à l'arrivée d'un nouveau GPU, d'un nouveau pilote ou d'un nouveau modèle.
Versions que nous déployons: Ubuntu 24.04 LTS (Server et Desktop), 22.04 LTS pour les parcs existants
GPU, CUDA et pile IA
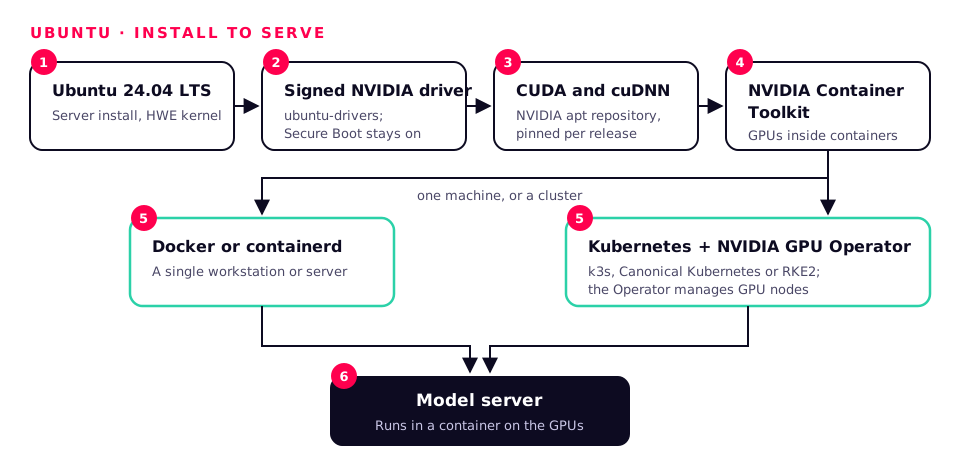
- ubuntu-drivers installe des modules noyau NVIDIA signés par Canonical, de sorte que l'UEFI Secure Boot reste activé sans avoir à enrôler votre propre clé.
- CUDA, cuDNN et le NVIDIA Container Toolkit depuis les dépôts apt de NVIDIA, avec des versions figées pour chaque release.
- Les noyaux HWE apportent la prise en charge des CPU, GPU et cartes réseau les plus récents à une version LTS.
Comment nous l'optimisons pour l'IA
- Installations Server, paquets minimaux, snaps gelés ou supprimés sur les appliances.
- Gouverneur CPU en mode performance, placement tenant compte du NUMA et mode persistance pour les GPU (voir la section sur le noyau).
- Mises à jour de sécurité automatiques planifiées dans une fenêtre de maintenance, ou paquets de mise à jour hors ligne pour les sites isolés.
Kubernetes et conteneurs
- Docker ou containerd avec le NVIDIA Container Toolkit.
- k3s pour le mono-nœud et l'edge, Canonical Kubernetes ou RKE2 pour les clusters, avec le NVIDIA GPU Operator par-dessus.
Sécurité
- Ubuntu Pro ajoute Livepatch, les modules FIPS 140, une maintenance de sécurité étendue et l'Ubuntu Security Guide pour le durcissement CIS et DISA-STIG.
- AppArmor en mode enforcing, avec des profils pour les services que nous exécutons.
Notre avis: Notre choix par défaut pour les serveurs GPU, les stations de travail IA et les appliances hors ligne, sauf si un parc est déjà standardisé sur autre chose.
Red Hat Enterprise Linux
Pour les entreprises réglementées et les parcs OpenShift.
RHEL apporte un cycle de vie de dix ans, du matériel certifié et un contrat de support que les services achats et les auditeurs reconnaissent. Le portefeuille IA de Red Hat — RHEL AI, OpenShift AI et Red Hat AI Inference Server, basé sur vLLM — s'appuie dessus.
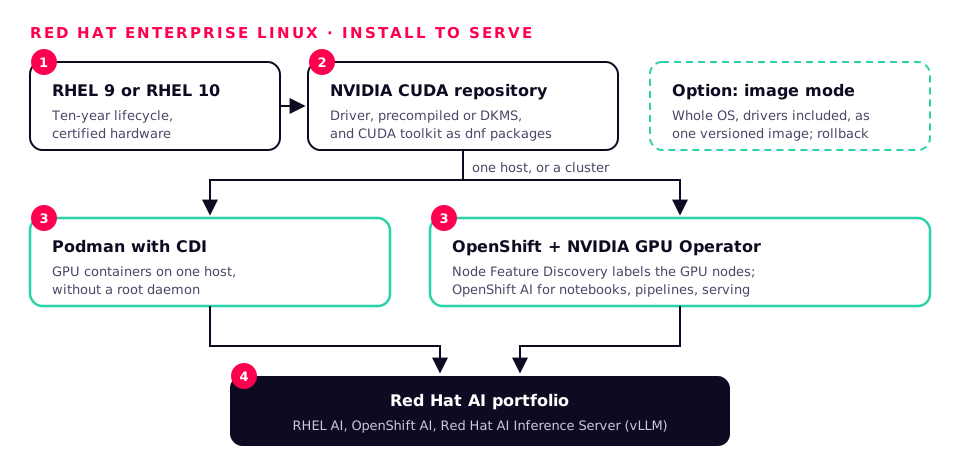
Versions que nous déployons: RHEL 9 et RHEL 10
GPU, CUDA et pile IA
- Le dépôt CUDA de NVIDIA pour RHEL fournit le pilote (précompilé ou DKMS) et le toolkit CUDA sous forme de paquets dnf.
- Podman avec CDI (Container Device Interface) pour des conteneurs GPU sans démon root.
- Le mode image (conteneurs amorçables) permet de livrer et de restaurer l'ensemble du système, pilotes compris, sous la forme d'une seule image versionnée.
Comment nous l'optimisons pour l'IA
- Des profils tuned comme throughput-performance ou accelerator-performance comme point de départ, puis des ajustements par workload.
- Paramètres NUMA, d'affinité des IRQ et de huge pages gérés sous forme de code.
Kubernetes et conteneurs
- OpenShift avec le NVIDIA GPU Operator et Node Feature Discovery ; OpenShift AI pour les notebooks, les pipelines et le service de modèles.
Sécurité
- SELinux en mode enforcing par défaut, mode FIPS et OpenSCAP avec le SCAP Security Guide pour les profils CIS et STIG.
- Correctifs du noyau à chaud avec kpatch pour des correctifs de sécurité sans interruption de service.
Notre avis: Le bon choix lorsque les contrats de support, les certifications ou une plateforme OpenShift existante comptent davantage que des paquets dernier cri.
SUSE Linux
Pour les flottes gérées par Rancher, SAP et l'edge.
SUSE associe un Linux d'entreprise à Rancher, l'un des moyens les plus répandus de gérer de nombreux clusters Kubernetes, et à SUSE AI pour exécuter une IA privée sur cette plateforme. Ses outils de snapshots et de mises à jour transactionnelles font des restaurations une opération de routine.
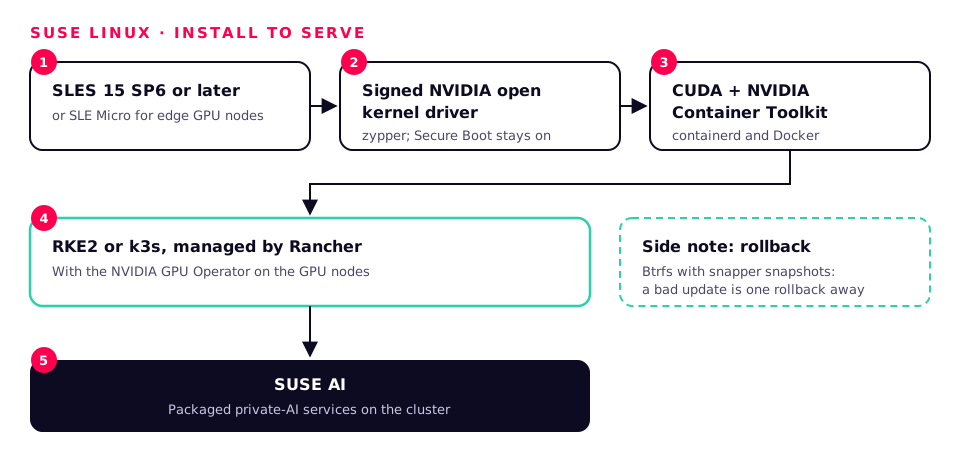
Versions que nous déployons: SUSE Linux Enterprise Server 15 SP6 et versions ultérieures, SLE Micro pour l'edge, openSUSE Leap pour les laboratoires
GPU, CUDA et pile IA
- SUSE fournit les modules noyau GPU open source de NVIDIA, signés pour Secure Boot et installables avec zypper.
- CUDA depuis le dépôt SUSE de NVIDIA ; le NVIDIA Container Toolkit pour containerd et Docker.
Comment nous l'optimisons pour l'IA
- Btrfs avec des snapshots snapper : une mauvaise mise à jour du pilote ou du noyau se corrige d'une simple restauration.
- Le système transactionnel en lecture seule de SLE Micro pour les nœuds GPU edge qui doivent se mettre à jour de manière atomique.
Kubernetes et conteneurs
- RKE2 ou k3s gérés par Rancher, avec le NVIDIA GPU Operator ; SUSE AI pour des services d'IA privée packagés.
Sécurité
- Contrôle d'accès obligatoire (AppArmor ou SELinux), modules certifiés FIPS, profils de durcissement OpenSCAP.
- SUSE Live Patching pour corriger le noyau sans redémarrage.
Notre avis: Idéal lorsque Rancher gère déjà les clusters, ou pour les flottes edge qui ont besoin de mises à jour atomiques et de restaurations rapides.

Alpine Linux
Minuscule, rapide et durci, pour les conteneurs plutôt que pour les hôtes GPU.
L'image de base d'Alpine pèse quelques mégaoctets ; elle repose sur musl libc et BusyBox avec une chaîne de compilation durcie. Elle est donc excellente pour les petits services qui entourent un système d'IA, mais peu adaptée au travail GPU lui-même.
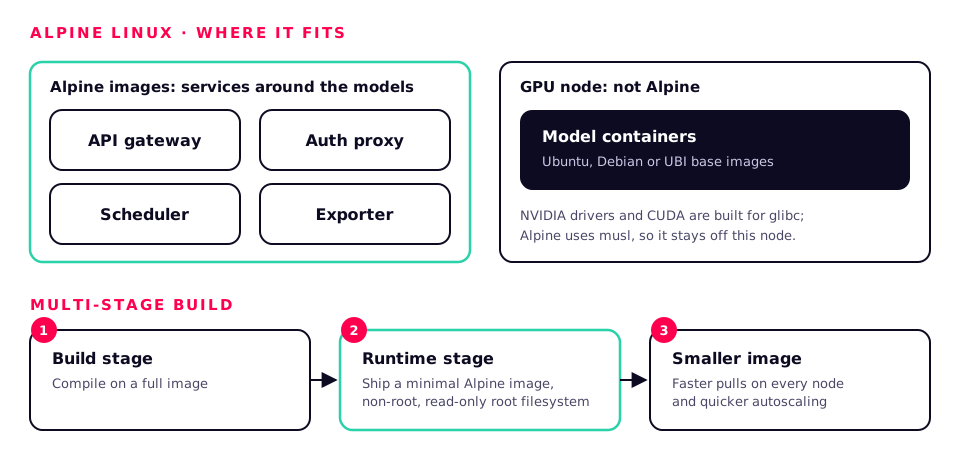
Versions que nous déployons: Versions stables actuelles d'Alpine, comme images de base de conteneurs
GPU, CUDA et pile IA
- Les pilotes NVIDIA et CUDA sont compilés pour glibc, et PyTorch ne publie aucun wheel musl : les images GPU et la plupart des images d'entraînement doivent donc reposer sur des bases Ubuntu, Debian ou UBI.
- Idéal pour les passerelles API, les proxys d'authentification, les ordonnanceurs, les exporteurs et l'inférence CPU légère avec des runtimes compilés.
Comment nous l'optimisons pour l'IA
- Des builds multi-étapes qui compilent sur une image complète et livrent un runtime Alpine minimal.
- Des images plus petites signifient des téléchargements plus rapides sur chaque nœud et un autoscaling plus réactif.
Kubernetes et conteneurs
- Une image de base pour les sidecars, les init containers et les services edge dans n'importe quelle distribution Kubernetes.
Sécurité
- Un ensemble de paquets réduit signifie une surface d'attaque réduite et des rapports d'analyse de vulnérabilités courts.
- Exécution sans root avec un système de fichiers racine en lecture seule.
Notre avis: Utilisez-le pour les services qui entourent vos modèles, pas pour les nœuds GPU ni pour les conteneurs de modèles eux-mêmes.

Debian, Rocky & AlmaLinux
Les distributions communautaires que nous prenons en charge en production.
Debian est la base stable et indépendante des fournisseurs sur laquelle reposent Ubuntu et de nombreuses appliances. Rocky Linux et AlmaLinux sont compatibles binaires avec RHEL, pour les équipes qui veulent l'écosystème RHEL sans abonnement.
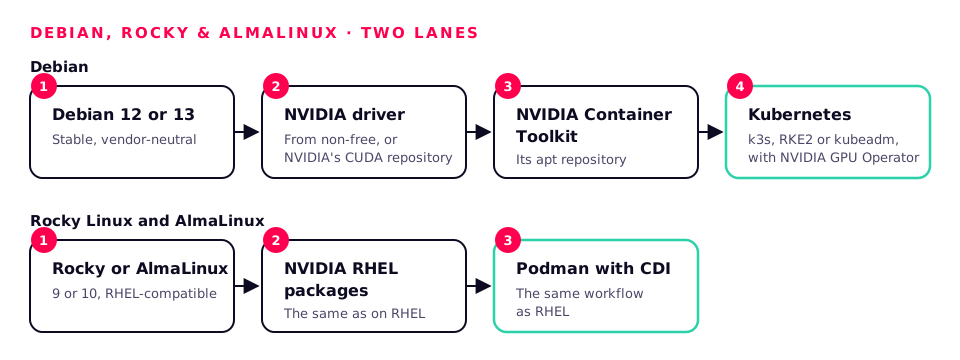
Versions que nous déployons: Debian 12 et 13 ; Rocky Linux et AlmaLinux 9 et 10
GPU, CUDA et pile IA
- Debian : pilotes NVIDIA depuis le dépôt non-free ou le dépôt CUDA de NVIDIA ; dépôt apt du NVIDIA Container Toolkit.
- Rocky et AlmaLinux : les mêmes paquets NVIDIA pour RHEL et le même workflow Podman CDI que RHEL.
Comment nous l'optimisons pour l'IA
- Les mêmes réglages de noyau, de NUMA et de stockage que leurs cousins commerciaux, appliqués avec Ansible.
- Debian sert aussi de base à Proxmox VE, que nous utilisons pour nos laboratoires de passthrough GPU.
Kubernetes et conteneurs
- Clusters k3s, RKE2 ou kubeadm avec le NVIDIA GPU Operator.
Sécurité
- Benchmarks CIS via OpenSCAP, AppArmor sur Debian et SELinux sur Rocky et AlmaLinux, avec des mises à jour de sécurité automatiques.
Notre avis: Des choix solides et économiques lorsque vous n'avez pas besoin d'un contrat fournisseur, soutenus par notre propre support.
Optimisations du noyau et du système pour les workloads d'IA
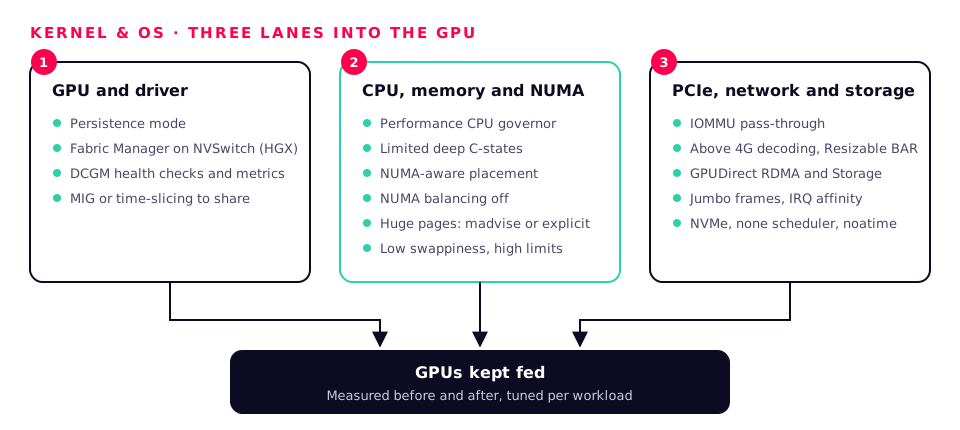
Les GPU ne sont rapides que si l'hôte les alimente en continu. Voici les réglages que nous vérifions sur chaque système d'IA, avant de les ajuster en fonction du workload propre au client. Aucun n'est universel : nous mesurons avant et après.
GPU et pilote
- Mode persistance (nvidia-persistenced) pour que le pilote reste chargé et que la première requête ne soit pas lente.
- NVIDIA Fabric Manager sur les systèmes NVSwitch (HGX) : sans lui, les GPU ne s'initialisent pas pour CUDA.
- DCGM pour les contrôles d'état, les diagnostics et les métriques par GPU.
- Partitions MIG ou time-slicing lorsque de nombreux petits modèles partagent un grand GPU.
CPU, mémoire et NUMA
- Gouverneur CPU en mode performance et C-states profonds limités sur les hôtes d'inférence sensibles à la latence.
- Placement tenant compte du NUMA : le travail de chaque GPU est épinglé au socket CPU et à la mémoire les plus proches (nvidia-smi topo -m affiche la topologie).
- Équilibrage NUMA automatique désactivé sur les hôtes GPU dédiés, pour que les pages ne migrent pas sous charge.
- Transparent huge pages sur madvise par défaut ; huge pages explicites pour les workloads RDMA et DPDK.
- Swappiness faible et limites memlock et de descripteurs de fichiers généreuses pour les data loaders et le RDMA.
PCIe, réseau et stockage
- IOMMU en mode pass-through et Above 4G decoding / Resizable BAR activés dans le firmware.
- GPUDirect RDMA (nvidia-peermem) et GPUDirect Storage (nvidia-fs) pour que les données contournent le CPU.
- Jumbo frames de bout en bout sur les fabrics de stockage et RoCE, avec une affinité des IRQ répartie entre les cœurs.
- NVMe avec l'ordonnanceur none, XFS ou ext4 avec noatime pour les jeux de données et les checkpoints.
Un point de départ (testé pour chaque workload, jamais copié à l'aveugle)
# /etc/sysctl.d/90-ai.conf
kernel.numa_balancing = 0
vm.swappiness = 10
vm.max_map_count = 1048576
net.core.rmem_max = 268435456
net.core.wmem_max = 268435456

# kernel command line (GRUB)
iommu=pt transparent_hugepage=madvise

# services
systemctl enable --now nvidia-persistenced
systemctl enable --now nvidia-fabricmanager   # NVSwitch (HGX) systems
cpupower frequency-set -g performance
Kubernetes et Docker pour l'IA
La plupart des systèmes d'IA que nous construisons s'exécutent dans des conteneurs, d'une simple station de travail sous Docker jusqu'aux clusters GPU multi-nœuds. Les briques de base sont les mêmes sur toutes les distributions.
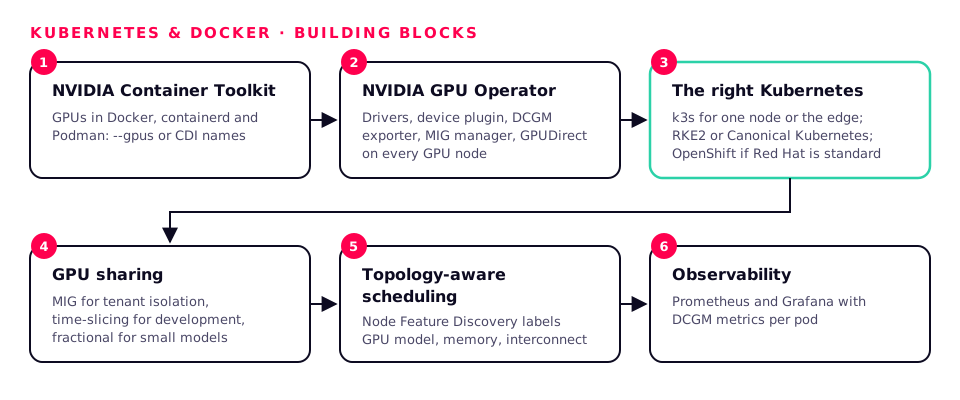
NVIDIA Container Toolkit
Donne à Docker, containerd et Podman l'accès aux GPU, via l'option --gpus ou les noms de périphériques CDI.
NVIDIA GPU Operator
Installe et gère les pilotes, le device plugin, l'exporteur DCGM, le gestionnaire MIG et les composants GPUDirect sur chaque nœud GPU Kubernetes.
Le bon Kubernetes
k3s pour un seul nœud ou l'edge, RKE2 ou Canonical Kubernetes pour les clusters, OpenShift là où Red Hat est la norme.
Partage des GPU
MIG pour une isolation stricte entre locataires, time-slicing pour le développement et ordonnancement fractionné pour de nombreux petits modèles.
Ordonnancement tenant compte de la topologie
Node Feature Discovery étiquette le modèle de GPU, la mémoire et l'interconnexion, pour que les gros jobs atterrissent sur les nœuds qui leur conviennent.
Observabilité
Prometheus et Grafana avec les métriques DCGM : utilisation des GPU, mémoire, température, consommation et erreurs par pod.
API LLM natives et montée en charge
Nous servons les modèles derrière des API compatibles OpenAI : les applications n'ont pas à se soucier du modèle ou du moteur qui se trouve derrière. La montée en charge s'opère alors dans quatre directions.
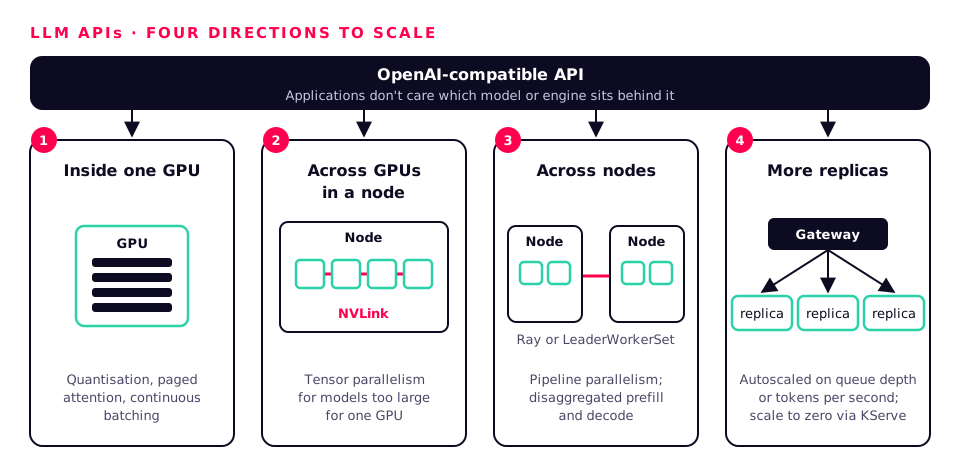
- 1
Au sein d'un GPU
La quantification (FP8, NVFP4 sur Blackwell, AWQ), la paged attention et le batching continu dans vLLM, SGLang ou TensorRT-LLM permettent de servir davantage d'utilisateurs sur chaque GPU.
- 2
Entre les GPU d'un nœud
Le parallélisme de tenseurs sur NVLink sert des modèles trop grands pour un seul GPU, avec la latence la plus faible.
- 3
Entre les nœuds
Le parallélisme de pipeline avec Ray ou Kubernetes LeaderWorkerSet pour les plus grands modèles, et le prefill et le décodage désagrégés (NVIDIA Dynamo, llm-d) à l'échelle du cluster.
- 4
Davantage de réplicas
Montée en charge horizontale derrière une passerelle, avec autoscaling sur la profondeur de file d'attente ou les tokens par seconde via KEDA ou le HPA, routage tenant compte du cache KV et mise à zéro via KServe.
Les moteurs que nous déployons : vLLM, SGLang, TensorRT-LLM avec Triton Inference Server, NVIDIA NIM, et Ollama ou llama.cpp pour les systèmes de bureau et edge. De nombreux adaptateurs LoRA peuvent partager un même modèle de base sur les mêmes GPU.
CI/CD pour les LLM, les agents et les pipelines de données
L'IA évolue plus souvent que les logiciels classiques : nouvelles versions de modèles, nouveaux prompts, nouvelles données. Nous donnons à chacun de ces trois éléments son propre pipeline, avec la même discipline : tout est versionné, testé, signé et promu par anneaux.
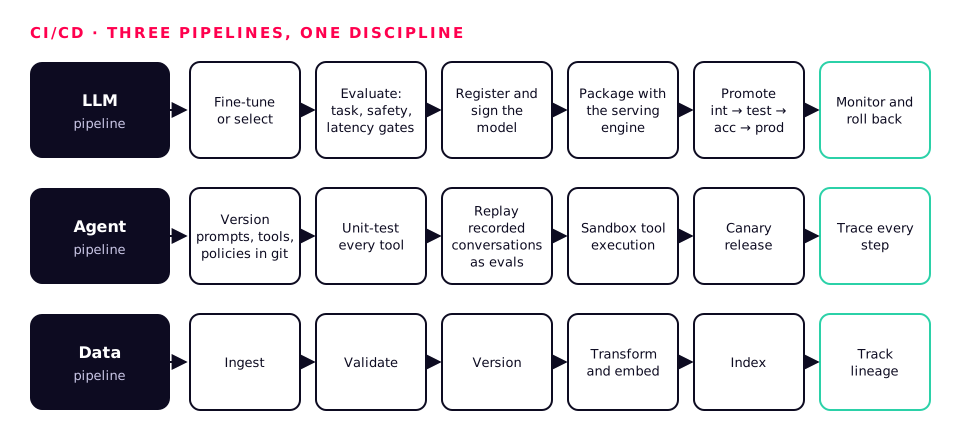
Pipeline LLM
- Fine-tuner ou sélectionner
- Évaluer selon des critères de tâche, de sécurité et de latence
- Enregistrer et signer le modèle
- Packager avec le moteur de service
- Promouvoir int → test → acc → prod
- Superviser et revenir en arrière
Kubeflow ou Ray pour l'entraînement, registre MLflow, signatures cosign, Argo CD pour le GitOps et Ring Promoter pour des releases anneau par anneau avec contrôle d'état.
Pipeline d'agents
- Versionner les prompts, les outils et les politiques dans git
- Tester unitairement chaque outil
- Rejouer des conversations enregistrées comme évaluations
- Exécuter les outils en sandbox
- Release canary
- Tracer chaque étape
Sandboxes d'outils conteneurisées, suites d'évaluation dans la CI, traçage OpenTelemetry, budgets de coût et de débit par agent.
Pipeline de données
- Ingérer
- Valider
- Versionner
- Transformer et vectoriser
- Indexer
- Suivre la lignée des données
Airflow, Dagster ou Argo Workflows ; Great Expectations pour la validation ; lakeFS ou DVC pour les versions ; Spark ou Ray pour la montée en charge ; pgvector, Qdrant ou Milvus pour la recherche ; OpenLineage pour la lignée.
La CI s'exécute sur des runners auto-hébergés au sein de votre réseau, y compris des runners GPU pour l'évaluation, de sorte que les modèles et les données ne le quittent jamais.
Comment nous sécurisons Linux pour l'IA
Un serveur d'IA détient vos données les plus précieuses et une partie de votre matériel le plus coûteux. Nous le sécurisons par couches, afin qu'aucune erreur isolée n'expose ni l'un ni l'autre.
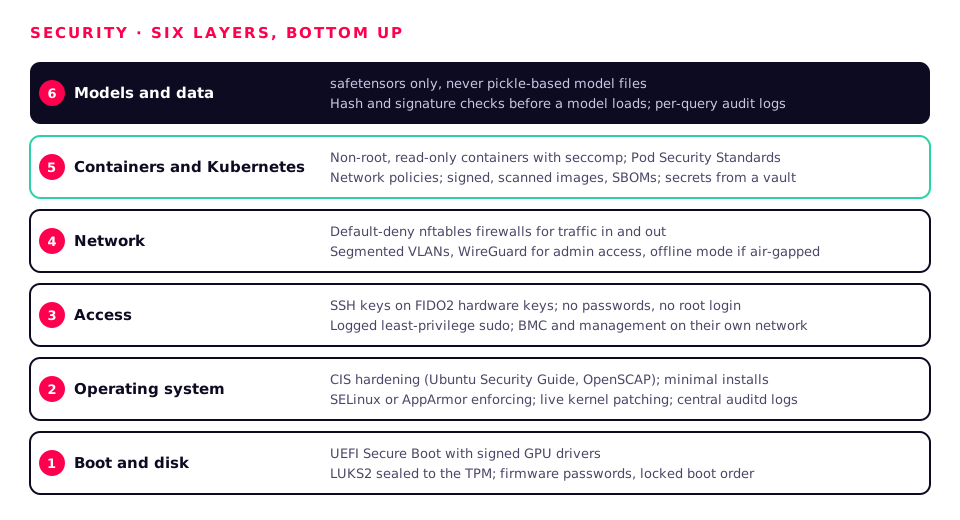
01
Démarrage et disque
- UEFI Secure Boot avec des pilotes GPU signés
- Chiffrement intégral du disque (LUKS2) scellé dans le TPM, avec redémarrage sans intervention
- Mots de passe firmware et ordre de démarrage verrouillé
02
Système d'exploitation
- Durcissement selon les benchmarks CIS (Ubuntu Security Guide, OpenSCAP)
- SELinux ou AppArmor en mode enforcing
- Installations minimales et correctifs du noyau à chaud
- Journalisation auditd vers un stockage centralisé
03
Accès
- Clés SSH stockées sur des clés matérielles FIDO2, aucun mot de passe, aucune connexion root
- sudo selon le principe du moindre privilège, avec journalisation
- BMC et administration sur un réseau dédié
04
Réseau
- Pare-feu en refus par défaut (nftables) pour le trafic entrant et sortant
- VLAN segmentés et WireGuard pour l'accès administrateur
- Mode entièrement hors ligne pour les sites isolés
05
Conteneurs et Kubernetes
- Conteneurs sans root, en lecture seule, avec des profils seccomp
- Pod Security Standards et politiques réseau
- Images signées, analyses de vulnérabilités et SBOM
- Secrets issus d'un coffre, jamais dans les images ni dans git
06
Modèles et données
- Uniquement des safetensors, jamais de fichiers de modèles basés sur pickle
- Vérification des empreintes et des signatures avant le chargement d'un modèle
- Journaux d'audit par requête et accès par dossier ou par locataire
Avec le support de l'équipe Workstation
Choisissez la distribution qui convient à votre organisation : nous la livrons prête pour l'IA, puis nous la maintenons ainsi.
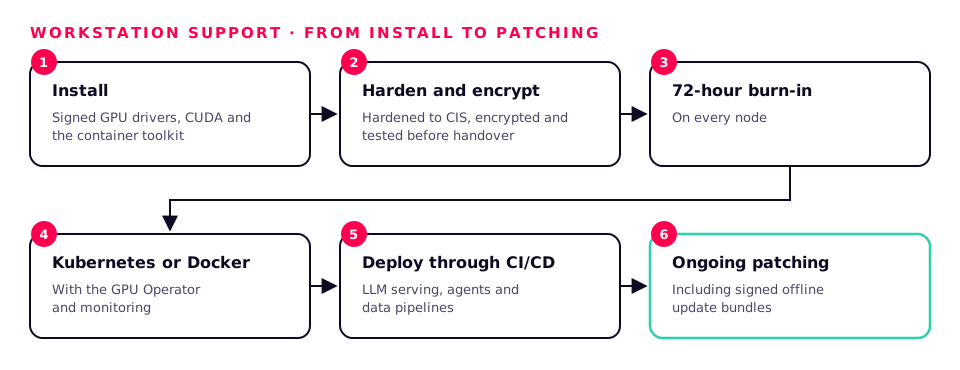
- Installée avec des pilotes GPU signés, CUDA et le container toolkit
- Durcie selon CIS, chiffrée et testée avant la remise
- Rodage de 72 heures sur chaque nœud
- Kubernetes ou Docker configuré, avec le GPU Operator et la supervision
- Service de LLM, agents et pipelines de données déployés via CI/CD
- Correctifs continus, y compris des paquets de mise à jour hors ligne signés
Les logos sont des marques de leurs propriétaires respectifs et ne sont utilisés que pour identifier les produits que nous prenons en charge. Les logos Debian, Rocky Linux et AlmaLinux sont utilisés sous licences CC BY-SA provenant de Wikimedia Commons.