Infrastructure d'entreprise pour l'entraînement et l'inférence IA à grande échelle
Les charges de travail d'IA modernes exigent une infrastructure conçue pour cet usage, capable d'évoluer d'une station de travail dotée d'un seul GPU jusqu'à des centaines de nœuds interconnectés. Workstation AI fournit les outils, les architectures et l'expertise pour concevoir, déployer et exploiter des clusters GPU orchestrés par Kubernetes, afin que vos équipes se concentrent sur le développement des modèles plutôt que sur la complexité de l'infrastructure.
Vue d'ensemble de l'architecture d'un cluster GPU
Un cluster GPU bien conçu associe des nœuds de calcul hautes performances, des interconnexions rapides, un stockage partagé et une orchestration intelligente. Comprendre l'architecture est la base de toute infrastructure d'IA fiable.
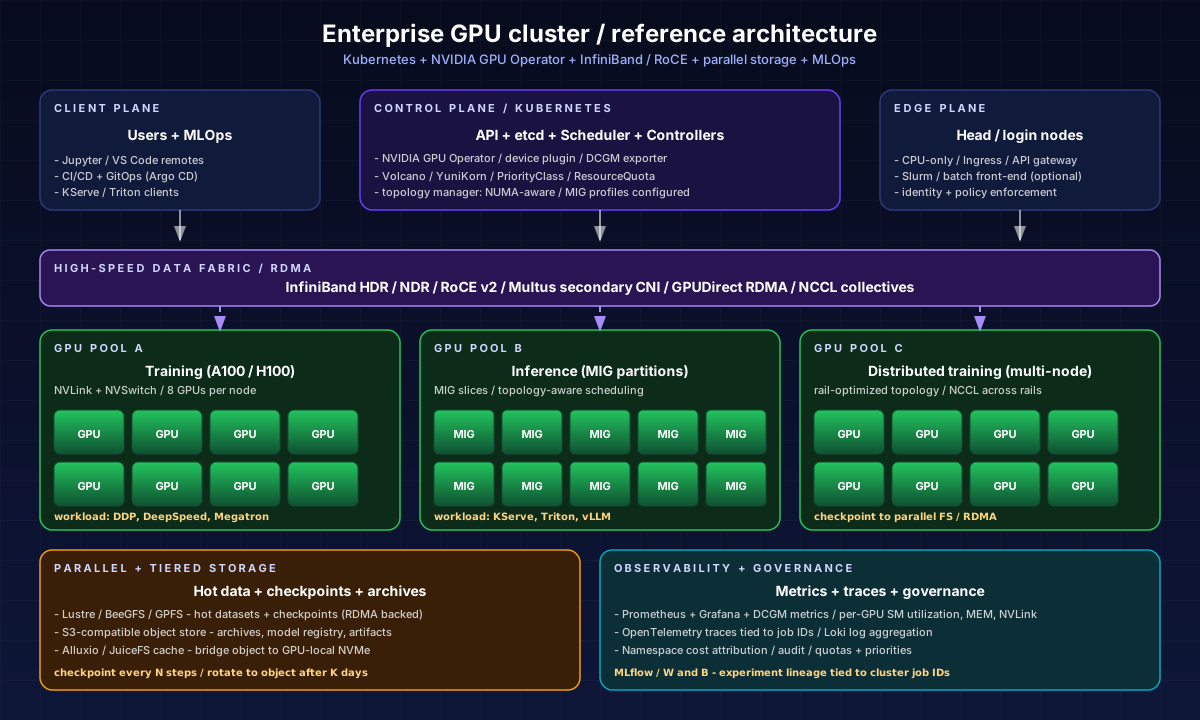
- Chaque nœud de calcul héberge généralement de 4 à 8 GPU (NVIDIA A100, H100 ou L40S) reliés par NVLink ou NVSwitch pour la communication au sein du nœud, avec une bande passante allant jusqu'à 900 GB/s.
- Un plan de gestion dédié prend en charge l'ordonnancement des tâches, l'allocation des ressources, la surveillance de l'état et le contrôle d'accès des utilisateurs, laissant le plan de données libre pour le trafic d'entraînement.
- Les nœuds de tête servent de passerelle aux utilisateurs pour soumettre des tâches, accéder aux environnements Jupyter et utiliser les outils MLOps sans consommer de ressources GPU.
- Des fabrics réseau à haut débit comme InfiniBand HDR (200 Gbps) ou RoCE v2 relient les nœuds pour l'entraînement distribué, en réduisant au minimum la latence de synchronisation des gradients.
- Des systèmes de fichiers parallèles partagés (Lustre, GPFS ou BeeGFS) fournissent le débit nécessaire aux E/S de jeux de données à grande échelle, sans créer de goulots d'étranglement de stockage.
Kubernetes pour les charges de travail d'IA
Kubernetes est devenu l'orchestrateur de fait des infrastructures d'IA, avec une gestion déclarative des ressources, une mise à l'échelle automatisée et un riche écosystème de composants compatibles GPU.
- ✓Le NVIDIA GPU Operator automatise le déploiement des pilotes GPU, du container toolkit, des device plugins et des exportateurs de supervision sur tous les nœuds, ce qui supprime la gestion manuelle des pilotes.
- ✓Les device plugins Kubernetes exposent les ressources GPU à l'ordonnanceur, ce qui permet une allocation fine : demander des modèles de GPU précis, des tranches MIG (Multi-Instance GPU) ou un accès en temps partagé.
- ✓Des politiques d'ordonnancement personnalisées, dont le bin-packing, le placement tenant compte de la topologie et le gang scheduling, garantissent que les tâches multi-GPU s'exécutent sur des nœuds à la topologie d'interconnexion optimale.
- ✓Les quotas de ressources par namespace et les classes de priorité permettent aux équipes de partager un cluster tout en garantissant les SLA des charges d'inférence en production par rapport aux entraînements expérimentaux.
- ✓L'intégration avec Volcano ou Apache YuniKorn apporte des capacités d'ordonnancement par lots conçues pour les charges d'IA et de HPC, avec files d'attente à partage équitable et préemption des tâches.
Pipelines MLOps sur clusters GPU
Un pipeline MLOps de bout en bout transforme des données brutes en modèles déployés, avec reproductibilité, gestion des versions et observabilité complètes à chaque étape.
- ✓Les pipelines d'ingestion et de prétraitement des données s'exécutent sur des nœuds CPU avec Apache Spark ou Dask et alimentent le stockage partagé en jeux de données nettoyés pour les étapes d'entraînement sur GPU.
- ✓Les plateformes de suivi d'expériences comme MLflow ou Weights & Biases enregistrent hyperparamètres, métriques et artefacts, ce qui permet des comparaisons reproductibles entre des centaines d'entraînements.
- ✓Les frameworks d'entraînement distribué (PyTorch DDP, DeepSpeed, Horovod) coordonnent les mises à jour des gradients sur plusieurs GPU et nœuds, tandis que Kubernetes gère le placement et le cycle de vie des pods.
- ✓Les registres de modèles versionnent les modèles entraînés avec leurs métadonnées et leur lignage, et s'intègrent aux pipelines CI/CD pour automatiser la validation, les tests A/B et les déploiements canary.
- ✓Le service d'inférence avec Triton Inference Server, vLLM ou KServe fournit des prédictions à faible latence grâce au batching dynamique, aux ensembles de modèles et à la mise à l'échelle automatique des GPU en fonction de la charge des requêtes.
Réseau pour l'IA distribuée
Les performances réseau sont souvent le goulot d'étranglement de l'entraînement distribué. Le choix de la bonne fabric et de la bonne configuration est déterminant pour l'efficacité de la mise à l'échelle.
- ✓InfiniBand HDR/NDR offre la latence la plus faible et la bande passante la plus élevée (200-400 Gbps par port) avec RDMA, ce qui en fait le choix idéal pour l'entraînement à grande échelle sur 64 nœuds ou plus.
- ✓RoCE v2 (RDMA over Converged Ethernet) constitue une alternative économique qui fonctionne sur des commutateurs Ethernet standard tout en prenant en charge RDMA pour réduire la charge CPU.
- ✓La topologie réseau compte : les architectures fat-tree et optimisées par rail réduisent la sursouscription, tandis que le protocole SHARP de NVIDIA décharge les opérations collectives sur les commutateurs réseau eux-mêmes.
- ✓Dans les environnements Kubernetes, Multus CNI permet aux pods de se connecter à la fois au réseau principal du cluster et à un réseau RDMA secondaire à haut débit pour le trafic d'entraînement.
- ✓L'isolation réseau par fonctions virtuelles SR-IOV donne à chaque pod d'entraînement un accès matériel direct à la carte réseau, en contournant la pile du noyau pour atteindre les performances maximales du lien.
Solutions de stockage pour les charges de travail d'IA
Les charges de travail d'IA ont des besoins de stockage variés : lectures parallèles à haut débit pour les données d'entraînement, accès à faible latence pour les checkpoints et stockage objet durable pour les jeux de données et les artefacts.
- ✓NFS reste un choix pratique pour les petits clusters et les répertoires personnels partagés, mais ses limites de débit le rendent inadapté comme stockage principal des données d'entraînement au-delà de quelques nœuds.
- ✓Ceph offre une plateforme de stockage unifiée avec des interfaces bloc (RBD), fichier (CephFS) et objet (RGW), et évolue horizontalement jusqu'au pétaoctet avec réplication et codage d'effacement intégrés.
- ✓Longhorn, une solution de stockage légère et native Kubernetes, fournit un stockage bloc répliqué idéal pour les checkpoints de modèles et les volumes persistants dans les petits clusters GPU.
- ✓Des couches de cache hautes performances basées sur Alluxio ou JuiceFS comblent l'écart entre un stockage objet lent (compatible S3) et les besoins en débit des chargeurs de données GPU.
- ✓Une stratégie de stockage hiérarchisé est indispensable : SSD NVMe rapides sur les nœuds de calcul pour l'espace temporaire et les checkpoints, systèmes de fichiers parallèles pour les jeux de données actifs et stockage objet à froid pour l'archivage.
Surveiller l'utilisation des GPU
Disposer d'une visibilité sur l'état et l'utilisation des GPU est essentiel pour maximiser le retour sur investissement de l'infrastructure et repérer les goulots d'étranglement avant qu'ils n'affectent les entraînements.
- ✓L'exportateur DCGM (Data Center GPU Manager) collecte plus de 50 métriques GPU, dont l'utilisation des SM, la bande passante mémoire, la température, la consommation électrique et le nombre d'erreurs ECC, pour la collecte par Prometheus.
- ✓Les tableaux de bord Grafana offrent des vues en temps réel et historiques de l'utilisation par GPU, par nœud et par tâche, ce qui permet aux équipes de repérer les ressources inactives et de dimensionner correctement les allocations.
- ✓Les alertes sur l'utilisation de la mémoire GPU, le bridage thermique et les erreurs Xid permettent une maintenance proactive et évitent que des pannes matérielles n'interrompent des entraînements de plusieurs jours.
- ✓L'intégration avec les métriques Kubernetes (kube-state-metrics) met en corrélation l'utilisation des GPU et les décisions d'ordonnancement des pods, ce qui aide les administrateurs à optimiser le bin-packing et le dimensionnement des pools de nœuds.
- ✓L'imputation des coûts par namespace ou par équipe à partir des heures GPU permet des modèles de refacturation qui encouragent une utilisation efficace des ressources et justifient l'extension de l'infrastructure.
De la station de travail au centre de données
Choisissez l'échelle adaptée à vos ambitions en IA. Chaque niveau s'appuie sur le précédent, et Workstation AI propose des chemins de migration entre eux.
| Niveau | GPU | Cas d'usage | Réseau | Stockage | Orchestration |
|---|---|---|---|---|---|
| Station de travail unique | 1-2 GPU | Prototypage, fine-tuning de petits modèles, développement de l'inférence | PCIe / NVLink | SSD NVMe local | Docker / Docker Compose |
| Petit cluster | 8-32 GPU (2-4 nœuds) | Entraînement de modèles jusqu'à 7B paramètres, service d'inférence multi-modèles | 25-100 GbE / RoCE v2 | NFS / Longhorn | K3s / MicroK8s |
| Cluster de taille moyenne | 32-128 GPU (4-16 nœuds) | Entraînement de modèles de 7B à 70B paramètres, inférence en production à grande échelle | InfiniBand HDR 200G | Ceph / BeeGFS | Kubernetes + GPU Operator |
| Cluster à grande échelle | 128-1000+ GPU (16-128 nœuds) | Entraînement de modèles de fondation, plateforme d'IA multi-locataire | InfiniBand NDR 400G | Lustre / GPFS + stockage objet | Kubernetes + Volcano + Slurm |
Pipeline MLOps de bout en bout
From data ingestion to model serving, a well-architected MLOps pipeline on Kubernetes automates every stage of the machine learning lifecycle.
Data Ingestion
Preprocessing
Distributed Training
Experiment Tracking
Model Registry
Inference Serving
Planifiez votre cluster GPU
Que vous partiez d'une seule station de travail ou que vous conceviez une plateforme d'entraînement IA à plusieurs nœuds, notre équipe peut vous aider à définir l'infrastructure adaptée à vos charges de travail et à votre budget.