La boutique est ouverte

Nous construisons les machines Workstation AI pour les sites web, les agents IA et l'entraînement de LLM — configurez-les et achetez-les en ligne.

Obtenir les prix pro
Produits IA
Labs IAAgents OpenAIAgents ClaudeGrok BotCRM natif Workstation AIMarketingTous les produits
Solutions IA
IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseStations de travail IAMatériel et logiciels NVIDIACalcul accéléré NVIDIAIA privéeCloud privé GPUClusters GPUIA en périphérieIA par secteur
Services IA
Modernisation des plateformesIngénierie numériqueFondations data et IAOpérations autonomesConseil IAAutomatisation DevOpsCybersécuritéDéveloppement logicielCréation d'agentsMise en place MLOpsLocation de GPUCloud privé GPU
À propos
EntrepriseNotre histoirePartenairesTémoignages clients
Centres de données IA
Centres de données IACloud privé GPUClusters GPULocation de GPU
Analyses IASérie JevLabo de benchmarksChoix de modèles
Notes techniques
Documentation
OS LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plateformes cloud d'IAAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryClouds et places de marché GPU
Centres de données IA privésPour les cabinets d'avocatsPour les cabinets comptablesPlateformes sur siteCloud entièrement sécurisé
OutilsRing PromoterJobshout
Actualités
Blog
Nous contacterSe connecter

Stations de travail IA, logiciels multi-agents IA, infrastructure GPU et solutions d'agents intelligents pour les entreprises modernes.

Nous contacter

Solutions IA

IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseIA par secteur

Produits

Tous les produitsCRM & ERP natifs Workstation AIMarketingAgents OpenAIRing PromoterJobshout

Entreprise

À proposEntrepriseCentres de données IAPourquoi WorkstationPartenairesTémoignages clientsTarifsContactTenthMatrix

Ressources

Analyses IANotes techniquesDocumentationOS LinuxPlateformes cloud d'IACentres de données IA privésBlogRechercherPlan du site
Bureau de Belgique
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Lun - Ven : 9h00 - 18h00 CET
+32 492 45 67 46
Siège social au Royaume-Uni
77-79 Marlowes, Hemel Hempstead HP1 1LFItinéraire : prenez la sortie 20 de la M25, Outer LondonN° d'entreprise: 11641870Lun - Ven : 9h00 - 18h00 GMT
+44 7515 356 146
Bureau de l'Inde
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Bureau de Taïwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Lun - Ven : 9 h 00 - 18 h 00, heure de Taïwan (GMT+8)
+886 926 892 701+32 492 45 67 46
Bureau en Estonie
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaLun - Ven : 9 h 00 - 18 h 00, heure d’Estonie (EET)
+32 492 45 67 46

© 2026 Workstation AI. Tous droits réservés.

ConfidentialitéSuppression des donnéesCookiesConditions d'utilisationPlan du site web

NVIDIA, le logo NVIDIA, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX et HGX sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. AMD, le logo AMD Arrow, EPYC, Instinct, Ryzen et Threadripper sont des marques commerciales d'Advanced Micro Devices, Inc. Dell et PowerEdge sont des marques commerciales de Dell Inc. ou de ses filiales. Intel et Xeon sont des marques commerciales d'Intel Corporation ou de ses filiales. AMAX, AceleMax et LiquidMax sont des marques commerciales d'AMAX Engineering Corporation. Tous les autres noms de produits, logos et marques appartiennent à leurs propriétaires respectifs. Nous les utilisons uniquement pour identifier les produits que nous décrivons, fournissons ou prenons en charge ; leur utilisation ne signifie pas que leurs propriétaires nous cautionnent.

Analyses et guides

Notes techniques

Analyses approfondies sur l'infrastructure IA, le MLOps, les clusters GPU et le développement avec des agents.

Portables pour développeurs IA : exécuter des LLM en local sous Linux avec des GPU de 16 GB et 24 GB (guide 2026)
AI•18 nov. 2026

Portables pour développeurs IA : exécuter des LLM en local sous Linux avec des GPU de 16 GB et 24 GB (guide 2026)

Ce qui tient sur un GPU RTX 5080 ou RTX 5090 Laptop, le calcul de mémoire, les modèles ouverts qui valent la peine, la configuration d'Ubuntu 26.04 a…

18 min readLire la suite

Tester des systèmes ML et LLM impossibles à prouver corrects : une boîte à outils Python d'éléments probants
AI•16 nov. 2026

Tester des systèmes ML et LLM impossibles à prouver corrects : une boîte à outils Python d'éléments probants

Des éléments probants à la place des preuves, en environ 400 lignes de Python avec une sortie réelle : métriques par segment avec intervalles bootstr…

30 min readLire la suite

TorchCurves en pratique : courbes B-spline et de Legendre apprenables dans PyTorch
AI•16 nov. 2026

TorchCurves en pratique : courbes B-spline et de Legendre apprenables dans PyTorch

Installer torchcurves, ajuster et dimensionner une courbe, choisir entre B-spline et Legendre ainsi que l’application d’entrée, construire une courbe…

28 min readLire la suite
Exécuter des modèles agentiques, vocaux et de vision sur l'appareil avec Cactus : guide pratique (2026)
AI•16 nov. 2026

Exécuter des modèles agentiques, vocaux et de vision sur l'appareil avec Cactus : guide pratique (2026)

Installer cactus-compute, effectuer des appels d'outils, filtrer par niveau de confiance avec repli vers un modèle plus grand, extraire des données s…

25 min readLire la suite
Politique d'utilisation de l'IA sous forme de code : construire une passerelle LLM avec caviardage des données personnelles, listes d'autorisation d'outils et télémétrie
AI•16 nov. 2026

Politique d'utilisation de l'IA sous forme de code : construire une passerelle LLM avec caviardage des données personnelles, listes d'autorisation d'outils et télémétrie

Combler le fossé des consignes sur l'IA dans le code : un fichier de politique versionné, une passerelle FastAPI compatible OpenAI, le caviardage ave…

32 min readLire la suite
AMD Instinct ou NVIDIA pour l'infrastructure d'IA : évaluer, porter et exploiter les deux (2026)
AI•14 nov. 2026

AMD Instinct ou NVIDIA pour l'infrastructure d'IA : évaluer, porter et exploiter les deux (2026)

De l'entretien de Lisa Su en 2024 à Helios : les plateformes 2026 couche par couche, les gammes Instinct, le calcul de mémoire, la correspondance log…

14 min readLire la suite
IA privée pour les données financières : résidence, routage et coût sur AWS Bedrock, Microsoft Azure et vos propres GPU
AI•14 nov. 2026

IA privée pour les données financières : résidence, routage et coût sur AWS Bedrock, Microsoft Azure et vos propres GPU

Modes de facturation et coût à l'arrêt, coût par appel à trois niveaux de volume, Bedrock dans la région ou profils EU, API Converse avec mise en cac…

20 min readLire la suite
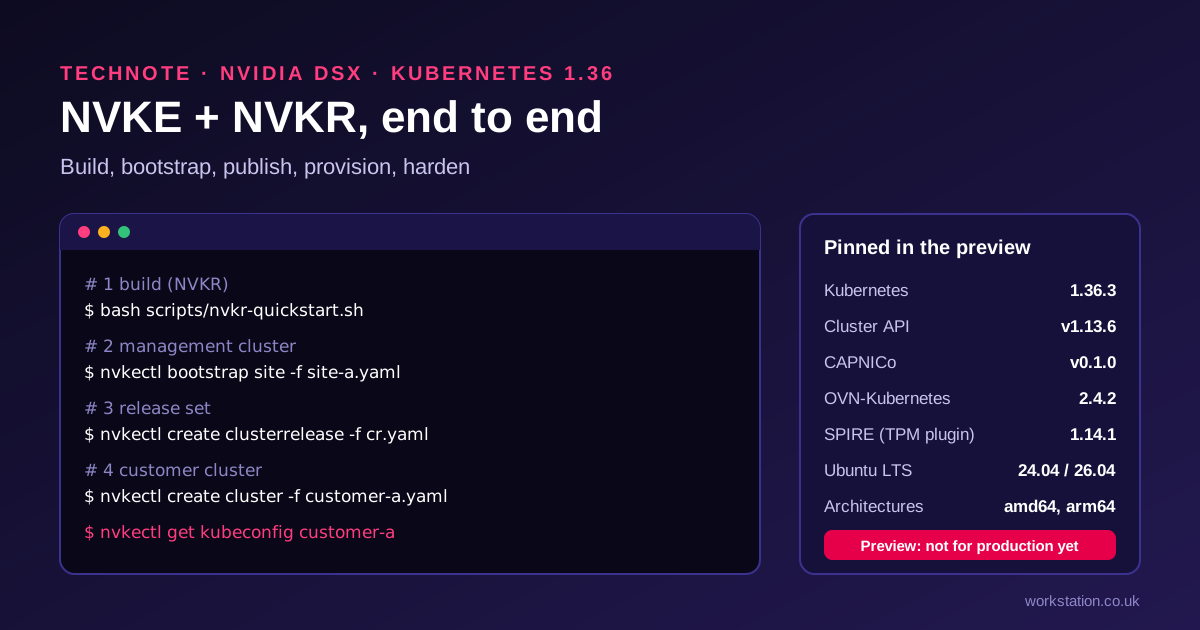
Note technique NVKE et NVKR : construire un service Kubernetes GPU géré à partir du bare metal, avec des builds reproductibles et vérifiables
AI•14 nov. 2026

Note technique NVKE et NVKR : construire un service Kubernetes GPU géré à partir du bare metal, avec des builds reproductibles et vérifiables

Architecture, composants et versions figées, le cycle Definition-Run-Release-Verify de NVKR, le workflow nvkectl complet des serveurs en rack jusqu'a…

26 min readLire la suite
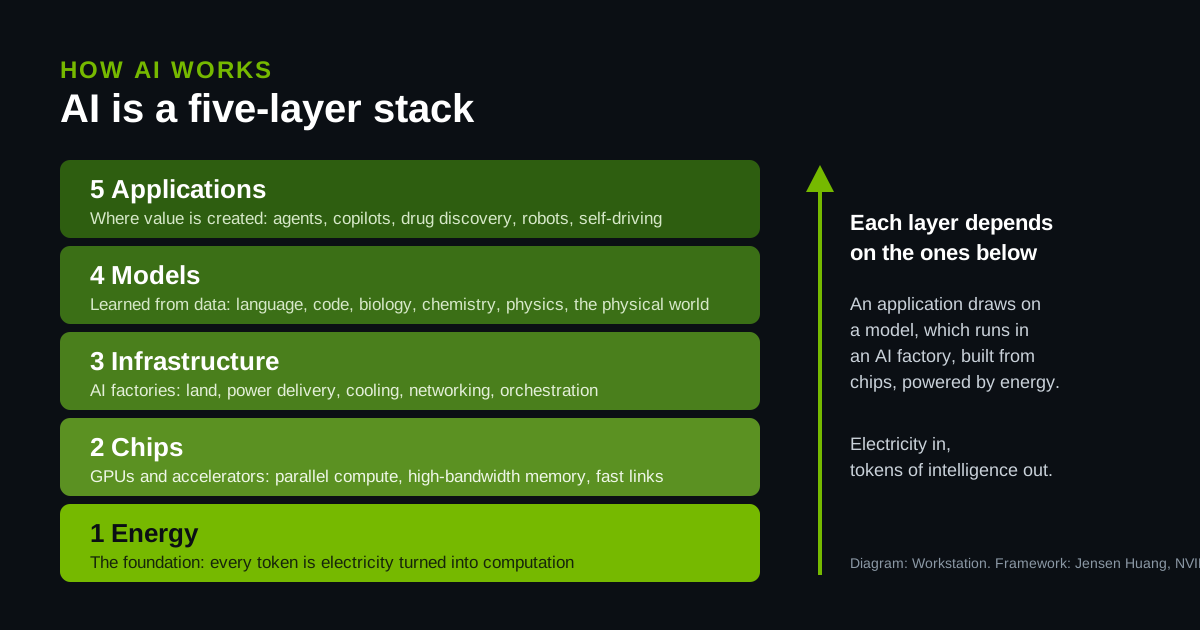
L'IA est un gâteau à cinq étages : ce qu'est l'IA, comment elle fonctionne et pourquoi chaque étage compte
AI•13 nov. 2026

L'IA est un gâteau à cinq étages : ce qu'est l'IA, comment elle fonctionne et pourquoi chaque étage compte

Le cadre de Jensen Huang expliqué : énergie, puces, infrastructure, modèles et applications, comment chaque étage dépend de ceux du dessous, et ce qu…

10 min readLire la suite
1