 Workstation team
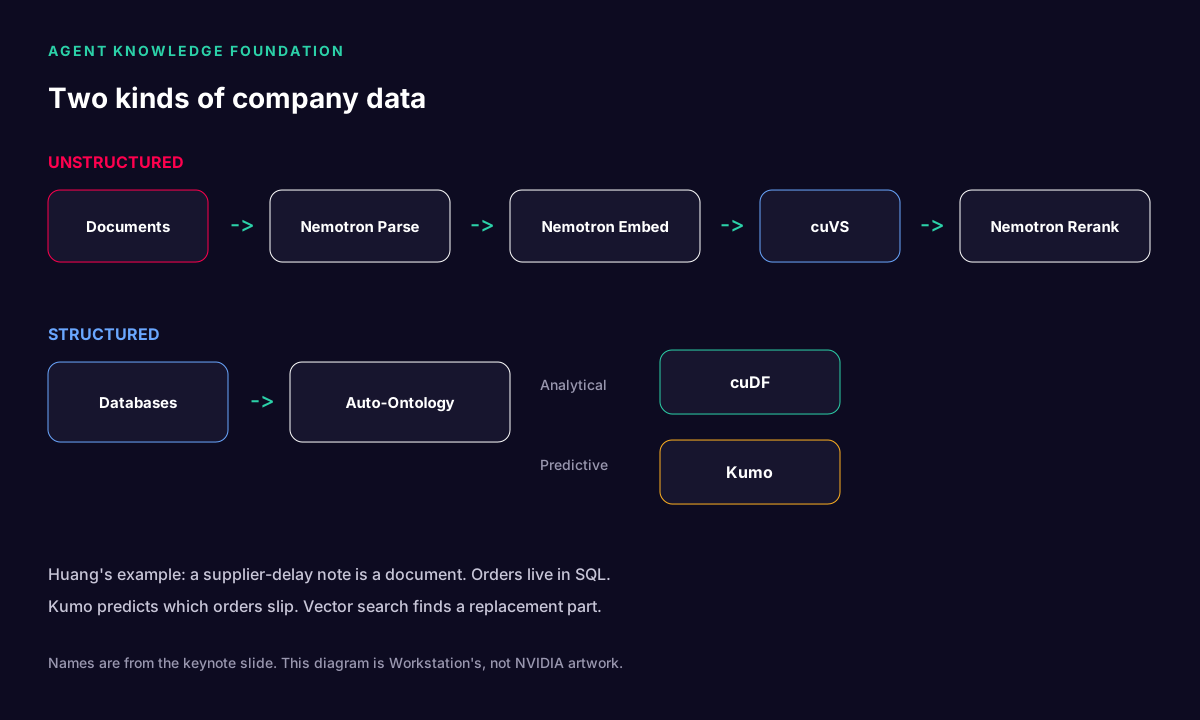
La diapositive Agent Knowledge Foundation présentée à la GTC Berlin sépare les données d'entreprise en deux. Les documents passent par Nemotron Parse, Nemotron Embed, cuVS et Nemotron Rerank. Les bases de données passent par Auto-Ontology, puis par cuDF pour l'analyse et par Kumo pour la prédiction. Cet article explique chaque bloc, cite les frameworks open source qui accomplissent les mêmes tâches et applique ce schéma à deux domaines où les deux types de données se rencontrent chaque jour : la santé et la recherche scientifique. Cela inclut les assistants conversationnels et les robots qui y travaillent déjà.
Ce qu'a dit Huang
Un retard fournisseur arrive sous forme de document. Les commandes que ce fournisseur alimente se trouvent dans SQL. Huang a expliqué que l'on utilise Kumo pour prédire quelles commandes vont prendre du retard, et la recherche vectorielle pour trouver une pièce de rechange dans les fichiers d'ingénierie. La transcription de la keynote déforme Kumo en « QMO » et « CUMA ». La diapositive écrit Kumo. Nous suivons la diapositive.
Il a également indiqué que Nemotron est livré avec ses poids, ses données et les scripts permettant de le reconstruire, et qu'il ne devient pas automatiquement un modèle de langage de pointe tant que quelqu'un ne l'a pas post-entraîné. L'un des exemples de partenaires qu'il a cités sur scène concernait la santé : Palantir travaillant avec le Tampa General Hospital. La liste complète, telle qu'il l'a énoncée, figure dans l'article détaillé. Ce sont ses exemples, pas les nôtres, et nous n'avons pas vérifié ces collaborations.
Le couloir des documents, bloc par bloc
Il s'agit de la génération augmentée par récupération (RAG), représentée comme quatre tâches distinctes plutôt qu'un seul bloc. Cette séparation est importante, car chaque étape échoue à sa manière et nécessite son propre test.
- Analyser (Parse). Transformer un PDF, une numérisation ou une présentation en texte propre, en tables et en légendes de figures, en conservant la page et la position. Les courriers cliniques et les comptes rendus de laboratoire regorgent de tables, d'en-têtes et d'écriture manuscrite. Un analyseur qui aplatit un tableau de résultats en une suite de nombres contaminera toute la suite de la chaîne. Nemotron Parse est le modèle de NVIDIA pour cette tâche. Parmi les alternatives ouvertes figurent Docling (d'IBM), Unstructured et Marker. Les services cloud incluent Azure Document Intelligence et AWS Textract.
- Vectoriser (Embed). Transformer chaque passage et chaque question en vecteur, afin que « essoufflement » et « dyspnée » se retrouvent proches l'un de l'autre. Nemotron Embed s'en charge. Parmi les modèles ouverts largement utilisés figurent BGE-M3, E5 et Nomic Embed. Testez tout modèle d'embedding sur votre propre vocabulaire avant de vous y fier, car les modèles généralistes traitent souvent mal les noms de médicaments et les symboles de gènes.
- Rechercher (Search). Trouver rapidement les vecteurs les plus proches parmi des millions de passages. cuVS est la bibliothèque GPU de NVIDIA pour cette tâche, et son index de graphe CAGRA est également utilisé dans Milvus et FAISS. Pour des collections plus petites, pgvector dans une base PostgreSQL existante suffit souvent. Qdrant et Weaviate sont d'autres choix courants. Combinez la recherche vectorielle avec une recherche par mots-clés classique (BM25), car des identifiants tels que les numéros NHS, les codes de lot et les noms de gènes exigent une correspondance exacte.
- Reclasser (Rerank). La recherche renvoie cinquante passages plausibles. Un reranker confronte chacun d'eux à la question et place en tête les cinq qui y répondent réellement. Nemotron Rerank s'en charge. Parmi les alternatives ouvertes figurent les rerankers BGE et les modèles à interaction tardive de type ColBERT. D'après notre expérience, le reclassement est le gain de précision le moins coûteux de toute la chaîne.
Ce couloir doit toujours produire des passages accompagnés de leurs sources, et non une réponse finie. C'est l'agent qui rédige la réponse. La citation permet à une personne de la vérifier.
Le couloir des tables, bloc par bloc
- Auto-Ontology. Avant qu'un modèle puisse raisonner sur une base de données, il faut que quelque chose indique la signification des colonnes et la manière dont les tables se joignent. « obs_cd 8867-4 » ne signifie rien pour un agent tant qu'il ne sait pas qu'il s'agit d'un code LOINC pour la fréquence cardiaque. La diapositive de Huang place ici une étape automatique. Dans le domaine de la santé, l'essentiel de l'ontologie existe déjà : SNOMED CT pour les termes cliniques (utilisé dans l'ensemble des soins primaires du NHS), LOINC pour les observations, dm+d pour les médicaments au Royaume-Uni, CIM-10 (ICD-10) et OPCS-4 pour les diagnostics et les actes. En sciences, il existe ChEBI pour les substances chimiques, la Gene Ontology et UniProt. Effectuez la correspondance avec ces référentiels plutôt que d'inventer les vôtres. La couche sémantique de dbt et les outils de graphe de connaissances tels que Neo4j sont des moyens courants de consigner cette correspondance.
- Analytique : cuDF. cuDF est la bibliothèque de dataframes sur GPU du projet RAPIDS de NVIDIA. Son mode
cudf.pandasaccélère le code pandas existant sans le réécrire, et Polars peut utiliser cuDF comme moteur GPU. C'est le versant « combien, quel montant, par rapport au mois dernier ». Pour la plupart des questions, le premier outil honnête reste SQL. Un modèle de langage qui écrit du SQL sur un schéma bien décrit (text-to-SQL) et montre la requête est bien plus facile à auditer qu'un modèle qui devine des chiffres. - Prédictif : Kumo. Kumo construit des prédictions directement sur de nombreuses tables liées à l'aide de réseaux de neurones sur graphes, au lieu qu'un data scientist conçoive les variables à la main. L'entreprise a publié un modèle de fondation relationnel pré-entraîné, KumoRFM. Le benchmark académique de référence pour ce type de travail est RelBench, de Stanford. L'alternative classique reste les arbres à gradient boosting tels que XGBoost sur des variables construites. Utilisez celui que vous êtes en mesure de valider, et validez-le sur des données d'une période que le modèle n'a jamais vue.
Les frameworks qui relient l'ensemble
Les deux couloirs sont des bibliothèques. Il faut quelque chose pour décider quand les appeler, conserver l'état et faire respecter les limites. C'est le harnais de l'agent, et la keynote de Berlin l'a d'abord placé dans un sandbox (voir notre article sur OpenShell).
| Tâche | Pile NVIDIA | Options open source ou fournisseurs courants |
|---|---|---|
| Analyser les documents | Nemotron Parse, extraction NeMo Retriever | Docling, Unstructured, Marker, LlamaParse |
| Vectoriser et reclasser | Nemotron Embed, Nemotron Rerank | BGE-M3, E5, Nomic Embed, BGE reranker, ColBERT |
| Recherche vectorielle | cuVS (CAGRA) | Milvus, FAISS, pgvector, Qdrant, Weaviate |
| Analyser les tables | cuDF, RAPIDS | SQL, DuckDB, Polars, pandas, dbt |
| Prédire sur les tables | Kumo (partenaire) | XGBoost, LightGBM, PyTorch Geometric |
| Graphe de connaissances | Étape Auto-Ontology | Neo4j, Microsoft GraphRAG, outils RDF et OWL |
| Orchestration d'agents | NeMo Agent Toolkit, blueprint AI-Q | LangGraph, LlamaIndex, Haystack, CrewAI, Microsoft Agent Framework (AutoGen), DSPy |
| Connexions aux outils | Microservices NIM | Model Context Protocol (MCP), Agent2Agent (A2A) |
| Modèle de langage | Nemotron | Llama, Qwen, Mistral, Gemma et MedGemma, ou un modèle de pointe hébergé |
| Robots | Isaac Sim, Isaac Lab, Cosmos, GR00T, Holoscan | ROS 2, MoveIt, Hugging Face LeRobot, openpi |
Aucun de ces éléments n'est obligatoire. Une petite équipe peut construire une première version solide avec Docling, pgvector, un reranker, PostgreSQL et LangGraph ou LlamaIndex sur une seule station de travail GPU. Les composants NVIDIA prennent tout leur sens lorsque le corpus atteint des dizaines de millions de passages ou que les tables atteignent des milliards de lignes.
Santé : pourquoi les deux couloirs sont nécessaires
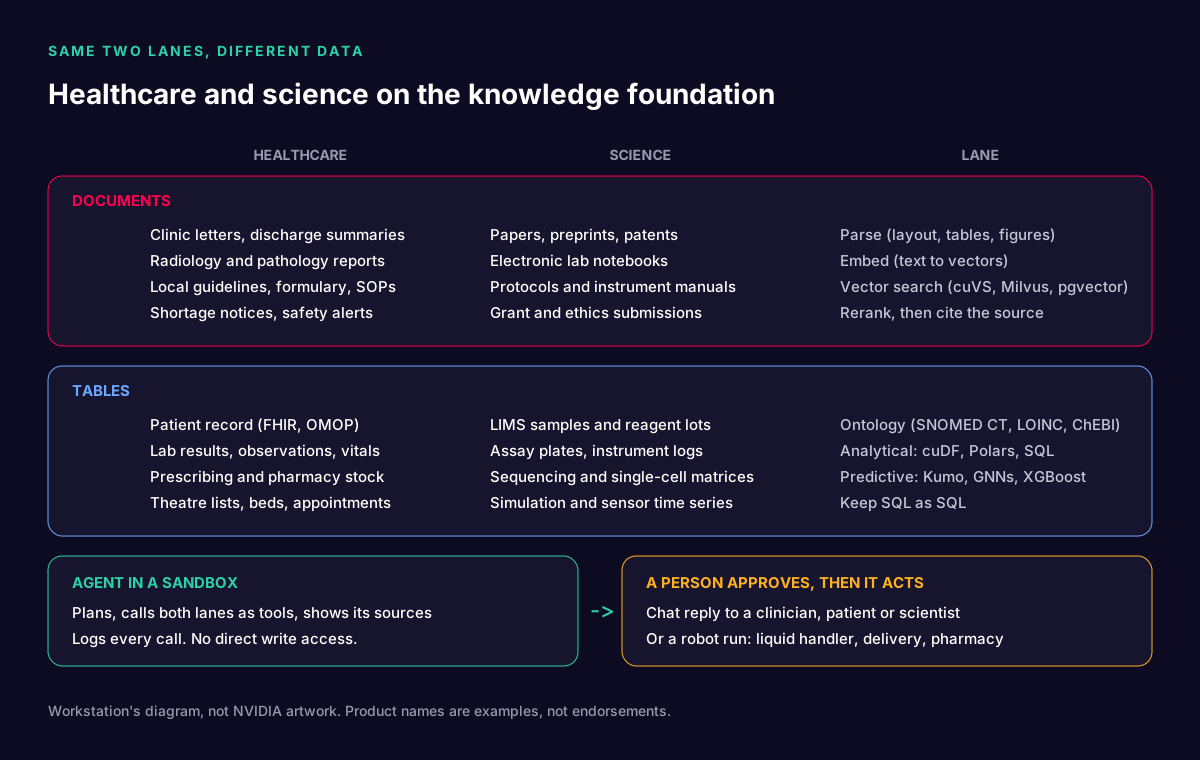
Un hôpital est l'exemple le plus clair de la séparation proposée par Huang. L'essentiel de ce que les cliniciens savent d'un patient est écrit : lettres d'adressage, notes de consultation, comptes rendus de sortie, comptes rendus de radiologie et d'anatomopathologie. Ce qui est compté, comme les résultats, les prescriptions, l'occupation des lits et les rendez-vous, se trouve dans le dossier patient informatisé et son entrepôt de données. Les questions cliniques nécessitent presque toujours les deux.
L'exemple du fournisseur de Huang, transposé
Remplacez le fournisseur en retard par une pénurie de médicament.
- Un avis de pénurie ou un Serious Shortage Protocol arrive sous forme de PDF ou d'e-mail. Le couloir des documents l'analyse et en extrait le produit, les dosages et les dates.
- Le couloir des tables associe le produit aux codes dm+d et interroge les prescriptions : quels patients en prennent, quel stock chaque pharmacie détient et à quelle date chaque patient doit être réapprovisionné.
- Un modèle prédictif classe les patients selon le risque de manquer en premier, à partir de l'historique de dispensation et des plannings de consultation.
- La recherche vectorielle dans le formulaire local, les recommandations et l'avis de pénurie trouve les alternatives approuvées, avec leurs sources.
- L'agent prépare une liste de travail pour un pharmacien : patient, risque, alternative suggérée et source. C'est le pharmacien qui décide. L'agent ne modifie rien dans le dossier.
C'est la même structure que l'exemple du fournisseur : un document, plusieurs tables, une prédiction, une recherche, une décision humaine.
Des assistants conversationnels déjà en service
Il s'agit de produits et de systèmes de recherche réels. Nous les citons pour illustrer les schémas, pas pour recommander l'un d'entre eux.
- Documentation clinique ambiante. Microsoft Dragon Copilot (issu de Nuance DAX) et Abridge écoutent une consultation et rédigent un brouillon de note que le clinicien corrige. NHS England a publié en 2025 des recommandations sur la technologie vocale ambiante, couvrant la sécurité clinique, la protection des données et la nécessité pour le clinicien de relire chaque note. C'est le couloir des documents à l'envers : l'IA rédige le document.
- Triage et auto-orientation des patients. Limbic Access est utilisé par les services NHS Talking Therapies pour l'auto-orientation et est certifié comme dispositif médical de classe IIa au Royaume-Uni. C'est un bon exemple de chatbot dont le périmètre est volontairement étroit et réglementé.
- Agents de soins non diagnostiques. Hippocratic AI développe des agents vocaux pour des tâches telles que les rappels préopératoires et les appels de suivi après la sortie, et a annoncé un partenariat avec NVIDIA en 2024. Le choix de conception déterminant est le caractère « non diagnostique » : l'agent assure le suivi et fait remonter les cas, il ne pose pas de diagnostic.
- Recherche de preuves pour les cliniciens. OpenEvidence répond aux questions cliniques à partir de la littérature publiée, avec citations. C'est le couloir des documents appliqué aux revues scientifiques plutôt qu'aux fichiers propres d'un hôpital.
- Modèles médicaux. MedGemma de Google est une famille de modèles à poids ouverts pour le texte et les images médicales, et son système de recherche AMIE étudie le dialogue diagnostique. Des poids ouverts signifient qu'un hôpital peut les exécuter sur son propre matériel et les tester sur ses propres données.
- Une mise en garde tirée de l'histoire. Le vérificateur de symptômes de Babylon Health a fait l'objet d'une large promotion, et l'entreprise s'est effondrée en 2023. Des promesses diagnostiques ambitieuses sans preuves à la hauteur sont le moyen le plus rapide de perdre la confiance des cliniciens.
Les robots à l'hôpital
- Les systèmes chirurgicaux tels que le da Vinci d'Intuitive et le Versius de CMR Surgical (conçu à Cambridge) sont téléopérés : c'est le chirurgien qui a le contrôle. La recherche progresse vers l'autonomie pour certaines parties d'une intervention. En 2025, une équipe de Johns Hopkins a fait état d'un robot réalisant de manière autonome les étapes d'une ablation de la vésicule biliaire sur des tissus ex vivo, et non sur des patients.
- Les robots logistiques tels que Moxi de Diligent Robotics vont chercher et livrent fournitures et échantillons, afin que le personnel infirmier passe moins de temps à se déplacer. Les robots de dispensation sont déjà courants dans les pharmacies hospitalières du NHS.
- La pile NVIDIA pour ces travaux comprend Holoscan pour le traitement en temps réel des capteurs et de la vidéo dans les dispositifs médicaux, Isaac for Healthcare pour la simulation et l'entraînement de robots médicaux, et MONAI, le framework open source d'imagerie médicale lancé par NVIDIA avec le King's College London.
Les robots sont le point où la base de connaissances rencontre le monde physique. Un robot de livraison a bien plus besoin du couloir des tables (quel service, quel lit, quel échantillon est urgent) que d'un chatbot.
Les règles britanniques qui façonnent la conception
- Sécurité clinique : DCB0129 pour le fabricant et DCB0160 pour l'organisation qui déploie le système, chacune avec un responsable de la sécurité clinique désigné et un registre des dangers.
- Droit des dispositifs médicaux : un logiciel qui pose un diagnostic ou recommande un traitement peut être un dispositif médical au sens des règles de la MHRA. L'AI Airlock de la MHRA est un bac à sable réglementaire destiné précisément à ces produits. Dans l'UE, l'AI Act considère l'IA intégrée aux dispositifs médicaux comme à haut risque.
- Protection des données : les données de santé sont des données de catégorie particulière au sens du UK GDPR. Attendez-vous à une analyse d'impact relative à la protection des données, et tenez les données identifiantes à l'écart des prompts, des journaux et de l'entraînement des modèles, sauf base légale.
- Achats : les organisations du NHS évaluent les fournisseurs à l'aide des Digital Technology Assessment Criteria (DTAC) et du Data Security and Protection Toolkit (DSPT).
- Accès pour la recherche : les environnements de données sécurisés du NHS et les environnements de recherche de confiance tels qu'OpenSAFELY amènent le code aux données plutôt que l'inverse. Un agent qui s'exécute à l'intérieur de ce périmètre, sur du matériel que l'organisation contrôle, s'inscrit bien mieux dans ce modèle qu'un agent qui envoie les dossiers à une API externe.
Recherche scientifique : les deux mêmes couloirs
Les laboratoires connaissent la même séparation. Les connaissances se trouvent dans les articles, les prépublications, les cahiers de laboratoire électroniques, les protocoles et les manuels d'instruments. Les mesures se trouvent dans le système de gestion de l'information de laboratoire (LIMS), les lecteurs de plaques, les séquenceurs et les résultats de simulation, souvent dans des volumes que seuls les GPU traitent confortablement.
L'exemple du fournisseur, en laboratoire
- Un fournisseur de réactifs émet un rappel de lot. L'avis est analysé.
- Le LIMS indique chaque échantillon et chaque plaque ayant utilisé ce lot.
- Une requête analytique (cuDF ou SQL) vérifie si les résultats issus de ce lot ont dérivé par rapport aux contrôles. Un modèle prédictif signale les expériences en aval les plus susceptibles d'être affectées.
- La recherche vectorielle dans les SOP et les cahiers du laboratoire trouve le réactif alternatif validé et toute étude de transition antérieure.
- L'agent prépare un plan de réexécution. Un scientifique l'approuve, et un robot de manipulation de liquides exécute le protocole.
Frameworks et modèles déjà utilisés par les scientifiques
- Modèles pour la biologie et la chimie. NVIDIA BioNeMo regroupe des modèles et des recettes d'entraînement pour les protéines, l'ADN et les petites molécules, dont Evo 2, développé avec l'Arc Institute. AlphaFold 3, de Google DeepMind et Isomorphic Labs, prédit les structures et les interactions, et ses créateurs ont partagé le prix Nobel de chimie 2024. Parmi les alternatives ouvertes figurent OpenFold et Boltz, et ESM3 d'EvolutionaryScale génère des protéines.
- Données à grande échelle. RAPIDS et cuDF accélèrent le travail sur les données tabulaires. rapids-singlecell, du projet scverse, exécute l'analyse single-cell sur GPU. NVIDIA Parabricks accélère les chaînes de séquençage génomique. Earth-2 et PhysicsNeMo couvrent la simulation climatique et physique.
- Agents de recherche. Coscientist (Carnegie Mellon, 2023) et ChemCrow ont montré des agents fondés sur des modèles de langage qui planifient et mènent des expériences de chimie à l'aide d'outils. PaperQA2 de FutureHouse répond aux questions à partir de la littérature, avec citations. L'AI co-scientist de Google (2025) génère et classe des hypothèses. Le blueprint AI-Q de NVIDIA est une conception de référence pour des assistants de recherche construits à partir des composants de la diapositive.
Robots de laboratoire et laboratoires autonomes
- Manipulateurs de liquides. Les robots Opentrons se programment au moyen d'une API de protocole Python ouverte, ce qui en fait un outil naturel à appeler pour un agent : l'agent rédige ou sélectionne un protocole, un scientifique le relit, le robot l'exécute.
- Chimistes robotiques mobiles. Le robot chimiste mobile de l'Université de Liverpool, présenté dans Nature en 2020, a mené des centaines d'expériences sur plusieurs jours et choisi lui-même les suivantes. L'A-Lab du Berkeley Lab a automatisé la synthèse de matériaux. Certaines de ses revendications de découverte ont été contestées, ce qui rappelle utilement que les laboratoires autonomes ont besoin de vérifications indépendantes.
- Les laboratoires cloud tels qu'Emerald Cloud Lab permettent aux scientifiques de mener des expériences à distance, en code.
- Apprentissage robotique. Isaac Sim et Isaac Lab simulent les robots avant qu'ils ne touchent une vraie paillasse. Cosmos génère des vidéos d'entraînement synthétiques. GR00T est le modèle de fondation de NVIDIA pour les robots humanoïdes. Côté open source, ROS 2 et MoveIt restent l'infrastructure standard, et LeRobot de Hugging Face et openpi de Physical Intelligence publient des politiques robotiques que chacun peut affiner.
Cinq règles de conception valables dans les deux domaines
- Orienter selon la forme des données. Les documents vont vers la récupération. Les tables vont vers SQL, l'analyse ou la prédiction. Demandez à l'agent d'indiquer quel couloir il a utilisé.
- Citer ou se taire. Chaque réponse concernant un patient ou une expérience doit renvoyer au passage ou à la requête qui la fonde. Si la récupération ne trouve rien, la bonne réponse est « je n'ai pas trouvé cette information ».
- Lecture seule par défaut. L'agent propose. Un clinicien, un pharmacien ou un scientifique approuve. Les écritures dans le dossier, les commandes et les exécutions de robots passent par une étape distincte et journalisée.
- Évaluer sur vos propres données. Constituez un jeu de test de vraies questions dont les réponses sont connues, à partir de vos propres documents et tables, et exécutez-le chaque fois qu'un modèle, un analyseur ou un prompt change. Les classements publics ne connaissent ni votre formulaire ni votre essai.
- Garder les données sensibles là où elles sont. Les modèles à poids ouverts tels que Nemotron, Llama, Qwen et MedGemma peuvent s'exécuter sur du matériel situé à l'intérieur de l'hôpital ou du laboratoire. Les discussions sur la protection des données, l'audit et la gouvernance de la recherche s'en trouvent considérablement raccourcies.
À quoi ressemble un premier projet raisonnable
Choisissez une question à laquelle on répond déjà à la main, qui nécessite à la fois un document et une table, et pour laquelle une mauvaise réponse est repérée par une personne avant d'avoir des conséquences. Les listes de travail liées aux pénuries, la rédaction de comptes rendus de sortie relus par le clinicien, le tri de la littérature pour un groupe de recherche ou les rapports d'impact des rappels de réactifs sont de bons candidats. Exécutez-le sur une seule station de travail GPU au sein de votre réseau, mesurez la précision sur votre jeu de test pendant un mois, et seulement ensuite parlez de montée en charge.
Si vous souhaitez de l'aide pour dimensionner cette machine, ou pour exécuter les modèles ouverts sur du matériel qui vous appartient, contactez-nous. Notre guide des stations de travail d'IA privée présente la méthode de dimensionnement pour une autre profession réglementée.
Les noms de produits et de projets de recherche sont cités comme exemples de systèmes réels et sont des marques de leurs propriétaires. Rien dans cet article ne constitue un conseil clinique, réglementaire ou juridique. Vérifiez vos propres obligations en matière de sécurité clinique, de dispositifs médicaux et de protection des données avant de déployer l'IA auprès de patients ou sur des données de patients.