La boutique est ouverte

Nous construisons les machines Workstation AI pour les sites web, les agents IA et l'entraînement de LLM — configurez-les et achetez-les en ligne.

Obtenir les prix pro
Produits IA
Labs IAAgents OpenAIAgents ClaudeGrok BotCRM natif Workstation AIMarketingTous les produits
Solutions IA
IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseStations de travail IAMatériel et logiciels NVIDIACalcul accéléré NVIDIAIA privéeCloud privé GPUClusters GPUIA en périphérieIA par secteur
Services IA
Modernisation des plateformesIngénierie numériqueFondations data et IAOpérations autonomesConseil IAAutomatisation DevOpsCybersécuritéDéveloppement logicielCréation d'agentsMise en place MLOpsLocation de GPUCloud privé GPU
À propos
EntrepriseNotre histoirePartenairesTémoignages clients
Centres de données IA
Centres de données IACloud privé GPUClusters GPULocation de GPU
Analyses IASérie JevLabo de benchmarksChoix de modèles
Notes techniques
Documentation
OS LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plateformes cloud d'IAAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryClouds et places de marché GPU
Centres de données IA privésPour les cabinets d'avocatsPour les cabinets comptablesPlateformes sur siteCloud entièrement sécurisé
OutilsRing PromoterJobshout
Actualités
Blog
Nous contacterSe connecter

Stations de travail IA, logiciels multi-agents IA, infrastructure GPU et solutions d'agents intelligents pour les entreprises modernes.

Nous contacter

Solutions IA

IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseIA par secteur

Produits

Tous les produitsCRM & ERP natifs Workstation AIMarketingAgents OpenAIRing PromoterJobshout

Entreprise

À proposEntrepriseCentres de données IAPourquoi WorkstationPartenairesTémoignages clientsTarifsContactTenthMatrix

Ressources

Analyses IANotes techniquesDocumentationOS LinuxPlateformes cloud d'IACentres de données IA privésBlogRechercherPlan du site
Bureau de Belgique
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Lun - Ven : 9h00 - 18h00 CET
+32 492 45 67 46
Siège social au Royaume-Uni
77-79 Marlowes, Hemel Hempstead HP1 1LFItinéraire : prenez la sortie 20 de la M25, Outer LondonN° d'entreprise: 11641870Lun - Ven : 9h00 - 18h00 GMT
+44 7515 356 146
Bureau de l'Inde
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Bureau de Taïwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Lun - Ven : 9 h 00 - 18 h 00, heure de Taïwan (GMT+8)
+886 926 892 701+32 492 45 67 46
Bureau en Estonie
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaLun - Ven : 9 h 00 - 18 h 00, heure d’Estonie (EET)
+32 492 45 67 46

© 2026 Workstation AI. Tous droits réservés.

ConfidentialitéSuppression des donnéesCookiesConditions d'utilisationPlan du site web

NVIDIA, le logo NVIDIA, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX et HGX sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. AMD, le logo AMD Arrow, EPYC, Instinct, Ryzen et Threadripper sont des marques commerciales d'Advanced Micro Devices, Inc. Dell et PowerEdge sont des marques commerciales de Dell Inc. ou de ses filiales. Intel et Xeon sont des marques commerciales d'Intel Corporation ou de ses filiales. AMAX, AceleMax et LiquidMax sont des marques commerciales d'AMAX Engineering Corporation. Tous les autres noms de produits, logos et marques appartiennent à leurs propriétaires respectifs. Nous les utilisons uniquement pour identifier les produits que nous décrivons, fournissons ou prenons en charge ; leur utilisation ne signifie pas que leurs propriétaires nous cautionnent.

Cloud privé GPU

Votre propre cloud IA : GPU, stockage et logiciels dans un centre de données que vous contrôlez

Faites tourner assistants IA, agents, recherche et entraînement de modèles sur des GPU qui vous sont dédiés, à côté de vos données, pour un coût prévisible. Nous concevons, construisons et exploitons des clouds privés GPU, du serveur unique aux racks complets, dans vos locaux ou dans un centre de données au Royaume-Uni.

Sur cette page

  1. Ce qu'est un cloud privé GPU
  2. Pourquoi les organisations construisent leur propre cloud GPU
  3. Découvrez le matériel : vidéos officielles de NVIDIA, Dell et AMD
  4. GPU, VRAM et serveurs
  5. De combien de VRAM avez-vous besoin ?
  6. Un stockage qui occupe les GPU
  7. Le réseau entre les GPU
  8. Tout ce que comprend un cloud privé GPU complet
  9. Privé, public ou hybride : comparatif
  10. Construire un cloud privé GPU de A à Z
  11. Essayez : le laboratoire du cloud IA privé
  12. FAQ sur le cloud privé GPU

Essayez : le laboratoire du cloud IA privé

Ce qu'est un cloud privé GPU

Un cloud privé GPU offre à vos équipes l'expérience en libre-service d'un cloud public (choisir un modèle, lancer un notebook, déployer un assistant) sur des serveurs GPU que vous êtes seul à utiliser. Le matériel se trouve dans vos locaux ou dans un centre de données de colocation, et les logiciels de plateforme, les politiques de sécurité et les données restent tous sous votre contrôle.

Le cloud public est excellent pour tester des idées et absorber de courts pics. Mais les assistants et agents IA tournent toute la journée, chaque interaction est facturée, et les données dont ils ont besoin sont souvent celles que vous pouvez le moins vous permettre de déplacer. Dès que l'usage est régulier, un cloud privé rend généralement les coûts prévisibles, garde les données sensibles en un seul endroit et réduit la latence entre vos modèles et vos systèmes.

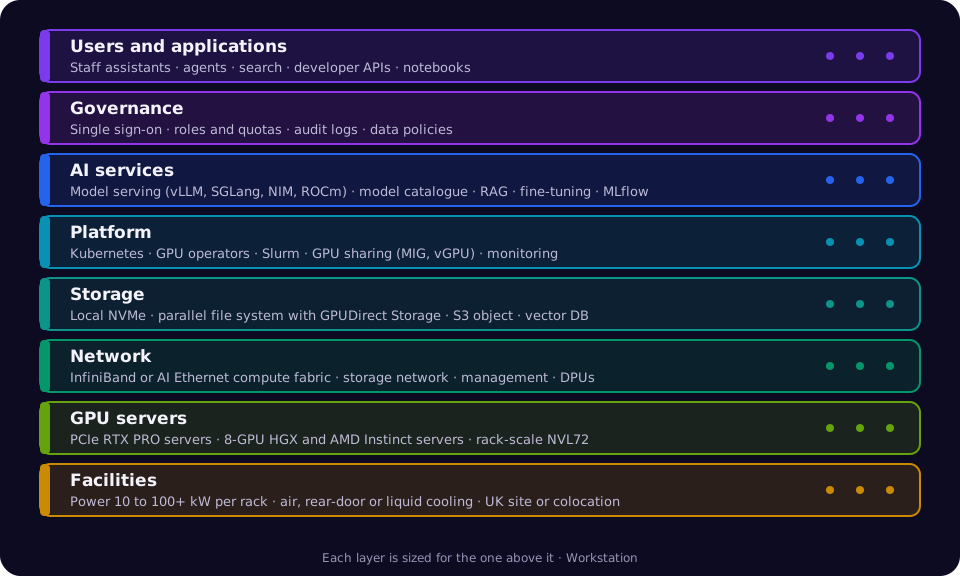
Ce n'est pas un produit unique. Un cloud IA privé est une pile : alimentation et refroidissement, serveurs GPU, réseau rapide, stockage capable d'occuper les GPU, plateforme de conteneurs et d'ordonnancement, service de modèles et outils de données, et la gouvernance qui les entoure. La suite de cette page passe en revue chaque couche, puis vous permet d'essayer les options pour vos propres charges de travail.

Schéma de la pile d'un cloud privé GPU, des installations en bas, en passant par les serveurs GPU, le réseau et le stockage, jusqu'à la plateforme, aux services d'IA et à la gouvernance en haut, avec les utilisateurs et les applications au-dessus.
Les huit couches d'un cloud privé GPU. Chacune doit être dimensionnée pour la couche supérieure.

Retour au sommaire

Pourquoi les organisations construisent leur propre cloud GPU

Les raisons que nous entendons le plus souvent, et ce que chacune implique concrètement.

Un coût prévisible pour une IA toujours active

Assistants, agents et API qui tournent 24 h/24, 7 j/7 coûtent la même chose chaque mois sur du matériel que vous possédez ou louez, au lieu d'une facture qui augmente à chaque token et à chaque utilisateur.

Les données restent là où vous le décidez

Conservez les données clients, patients, juridiques ou financières au Royaume-Uni, sur votre propre site ou entièrement hors ligne, et prouvez-le aux auditeurs et aux régulateurs.

Une faible latence au plus près de vos données

Les modèles tournent à côté de vos bases de données, documents et applications : la recherche et les appels d'outils des agents ne traversent pas Internet à chaque étape.

Liberté de choix des modèles et des outils

Faites tourner côte à côte des modèles open-weight, vos modèles affinés et des modèles commerciaux, et changez-en sans migrer de plateforme. Aucune dépendance au catalogue d'un seul fournisseur.

Une gouvernance intégrée

Authentification unique, accès basé sur les rôles, quotas par équipe, journaux d'audit de chaque appel de modèle et politiques définissant les données accessibles à chaque assistant.

Le libre-service pour chaque équipe

Les data scientists lancent des notebooks et des tâches de fine-tuning, les développeurs déploient des endpoints de modèles, et l'informatique dispose d'une console unique pour la capacité, l'état et les coûts.

Une capacité GPU garantie

Vos GPU sont là au démarrage d'un projet, pas épuisés dans la région dont vous avez besoin. C'est l'ordonnancement qui décide quelle équipe les obtient, pas une file d'attente chez un fournisseur.

Un matériel qui reste rentable

Les anciens GPU passent à l'inférence, au développement et à l'enseignement à l'arrivée des nouveaux : chaque génération reste productive pendant des années.

Retour au sommaire

Découvrez le matériel : vidéos officielles de NVIDIA, Dell et AMD

Lues depuis la chaîne YouTube de chaque fabricant. Chaque vidéo ne se charge que lorsque vous appuyez sur lecture.

The AI Factory. Lue depuis la chaîne YouTube officielle de NVIDIA. Regarder sur YouTubeNVIDIA, Blackwell, DGX, Grace et RTX PRO sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation. Elles sont citées pour décrire les produits que nous fournissons ; aucune approbation de NVIDIA n'est sous-entendue.
How Dell Technologies Is Building the Engines of AI Factories With NVIDIA Blackwell. Lue depuis la chaîne YouTube officielle de NVIDIA. Regarder sur YouTubeLes noms de produits cités sont des marques commerciales ou des marques déposées de NVIDIA and Dell Technologies. Ils servent à décrire les produits que nous fournissons ; aucune approbation n'est sous-entendue.
AMD Helios Rackscale Solution: Open AI Infrastructure for the AI Factory Era. Lue depuis la chaîne YouTube officielle de AMD. Regarder sur YouTubeLes noms de produits cités sont des marques commerciales ou des marques déposées de AMD. Ils servent à décrire les produits que nous fournissons ; aucune approbation n'est sous-entendue.

Retour au sommaire

GPU, VRAM et serveurs

La mémoire GPU (VRAM) détermine quels modèles tiennent et combien d'utilisateurs chaque GPU peut servir ; la bande passante mémoire détermine la vitesse de réponse. Voici les GPU de centre de données avec lesquels nous construisons le plus souvent des clouds privés.

Comparatif des GPU de centre de données

GPUFabricantMémoire par GPUBande passante mémoireFormatIdéal pour
RTX PRO 6000 Blackwell Server EditionNVIDIA96 GB GDDR71,6 TB/sCarte PCIe, refroidissement par airInférence, RAG, fine-tuning de modèles petits et moyens, graphisme et simulation
L40SNVIDIA48 GB GDDR6864 GB/sCarte PCIe, refroidissement par airInférence de petits modèles, vision, rendu
H200NVIDIA141 GB HBM3e4,8 TB/sCarte HGX à 8 GPUInférence et fine-tuning de grands modèles
B200NVIDIA180 GB HBM3e8 TB/sCarte HGX à 8 GPUEntraînement et inférence à haut débit
B300 (Blackwell Ultra)NVIDIA288 GB HBM3e8 TB/sCarte HGX à 8 GPU, refroidissement par air ou liquideModèles de raisonnement, très grands modèles, entraînement
GB300 NVL72NVIDIA288 GB HBM3e par GPU, 72 GPU par rack8 TB/s par GPURack à refroidissement liquideEntraînement de pointe et les plus grands services d'inférence
Instinct MI325XAMD256 GB HBM3E6 TB/sPlateforme OAM à 8 GPUInférence de grands modèles avec beaucoup de mémoire par GPU
Instinct MI355XAMD288 GB HBM3E8 TB/sPlateforme OAM à 8 GPU, refroidissement liquideEntraînement et inférence de très grands modèles
DGX Spark (GB10)NVIDIA128 GB unifiée273 GB/sSystème de bureauDéveloppement, prototypage et pilotes avant le cluster

Les chiffres correspondent aux spécifications publiées par les fabricants. Les serveurs des partenaires peuvent faire fonctionner les GPU à des limites de puissance différentes.

Les serveurs qui les accueillent

Serveurs GPU PCIe

De deux à huit GPU PCIe comme les RTX PRO 6000 ou L40S dans un serveur standard refroidi par air, par exemple le Dell PowerEdge XE7745 ou R760xa. La porte d'entrée la plus simple vers un cloud privé : compatible avec la plupart des racks et des budgets électriques.

Serveurs HGX et OAM à 8 GPU

Huit GPU reliés par NVLink ou AMD Infinity Fabric, par exemple les Dell PowerEdge XE9680 (H200 ou AMD Instinct MI300X), XE9780 (B300) et XE9785 (AMD Instinct MI355X), ou les NVIDIA DGX B200 et DGX B300.

Systèmes à l'échelle du rack

Des racks entiers à refroidissement liquide qui fonctionnent comme un seul GPU géant, comme NVIDIA GB300 NVL72 ou AMD Helios. Pour les organisations qui entraînent ou servent les plus grands modèles, dans un centre de données conçu pour eux.

Systèmes IA de bureau

DGX Spark et stations de travail IA pour les développeurs et les pilotes. La même pile logicielle que le cluster, pour que le travail passe de l'un à l'autre sans modification.

Retour au sommaire

De combien de VRAM avez-vous besoin ?

Une façon rapide de dimensionner la mémoire GPU avant d'en parler à qui que ce soit. Utilisez l'outil de dimensionnement plus bas pour vos propres chiffres.

  • Poids du modèle : environ 2 GB par milliard de paramètres en 16 bits, 1 GB en 8 bits (FP8) et 0,5 GB en 4 bits.
  • Cache KV : la conversation de chaque utilisateur nécessite aussi de la mémoire, qui augmente avec la longueur du contexte et le nombre d'utilisateurs servis simultanément. Pour les services très sollicités, il peut égaler les poids.
  • Marge : prévoyez environ 10 à 20 % pour l'environnement d'exécution, les activations et les pics.
  • Le fine-tuning demande davantage : un fine-tuning complet peut nécessiter trois à quatre fois la mémoire de l'inférence ; LoRA et QLoRA en demandent beaucoup moins.
  • Les modèles à mélange d'experts (MoE) doivent tenir tous leurs experts en mémoire, même si seuls certains sont utilisés pour chaque mot.
Taille du modèlePrécisionMémoire pour les poidsTient sur (avec de la marge pour les utilisateurs)
8 milliards de paramètres16 bitsenviron 16 GBUn L40S ou RTX PRO 6000 ; DGX Spark
32 milliards de paramètres8 bitsenviron 32 GBUn RTX PRO 6000
70 milliards de paramètres8 bitsenviron 70 GBUn H200, ou deux RTX PRO 6000
120 milliards de paramètres (MoE)4 bitsenviron 60 à 65 GBUn RTX PRO 6000 ou H200
405 milliards de paramètres8 bitsenviron 405 GBUn serveur à 8 GPU H200, B200 ou MI325X
670 milliards de paramètres et plus (MoE)8 bitsenviron 670 GB ou plusUn serveur à 8 GPU B300 ou MI355X, ou plusieurs serveurs

Calcul de la VRAM

Retour au sommaire

Un stockage qui occupe les GPU

Des GPU qui attendent des données gaspillent de l'argent. Le stockage pour l'IA comprend généralement trois niveaux, dimensionnés pour les vitesses de lecture nécessaires à l'entraînement et la capacité requise par vos données.

NVMe local dans chaque serveur

Un espace temporaire rapide pour les jeux de données, les checkpoints et les caches de modèles, au plus près des GPU. En général plusieurs disques NVMe par serveur GPU.

SSD NVMe dans chaque serveur GPU

Système de fichiers partagé hautes performances

Un espace de noms unique que tous les serveurs lisent en parallèle, assez rapide pour alimenter l'entraînement et charger les modèles en quelques secondes. Privilégiez la prise en charge de GPUDirect Storage, qui transfère les données directement dans la mémoire GPU.

Dell PowerScale, VAST Data, WEKA, DDN, IBM Storage Scale, Lustre

Stockage objet et sauvegarde

Une grande capacité à faible coût pour les données brutes, les jeux de données, les versions de modèles et les sauvegardes, via l'interface S3 que la plupart des outils d'IA utilisent déjà.

Dell ECS ou ObjectScale, Ceph, appliances compatibles S3, bande ou cloud pour les copies hors site

Bases vectorielles et documentaires pour le RAG

Les assistants qui répondent à partir de vos documents ont besoin d'une base de données vectorielle et des fichiers d'origine, avec les mêmes contrôles d'accès que les systèmes sources. Par exemple pgvector, Milvus, Qdrant ou Elasticsearch.

Retour au sommaire

Le réseau entre les GPU

Au sein d'un serveur, les GPU communiquent via NVLink ou Infinity Fabric. Entre les serveurs, c'est le réseau qui détermine si de nombreux GPU peuvent fonctionner comme un seul.

Fabric de calcul

Pour l'entraînement ou le service réparti sur plusieurs serveurs : NVIDIA Quantum InfiniBand (400 à 800 Gb/s par port), NVIDIA Spectrum-X Ethernet ou Ethernet avec les cartes réseau IA AMD Pensando Pollara. Généralement un port à 400 ou 800 Gb/s par GPU.

Réseau de stockage et front-end

Un réseau Ethernet distinct pour le trafic de stockage, les utilisateurs et les applications, généralement de 100 à 400 Gb/s par serveur, afin qu'il n'entre jamais en concurrence avec la fabric de calcul.

Gestion et sécurité

Une gestion hors bande pour chaque serveur, des DPU comme NVIDIA BlueField pour isoler les locataires et décharger la sécurité, et des pare-feu entre le cloud IA et le reste de l'entreprise.

Retour au sommaire

Tout ce que comprend un cloud privé GPU complet

Notre liste de contrôle pour un cloud IA privé que les équipes utilisent réellement. Nous la cochons à la conception, à la construction et à la remise.

Installations

  • Puissance par rack dimensionnée pour les serveurs GPU (de 10 kW à plus de 100 kW)
  • Refroidissement par air, porte arrière ou liquide direct en conséquence
  • Alimentations redondantes et onduleur
  • Charge au sol, contrôle d'accès et extinction d'incendie vérifiés
  • Centre de données au Royaume-Uni ou étude du site sur place

Calcul

  • Serveurs GPU adaptés à la taille des modèles et aux utilisateurs
  • Nœuds CPU uniquement pour la préparation des données et les services
  • Capacité de réserve ou pièces de rechange en cas de panne
  • Versions de firmware et de pilotes testées ensemble
  • Rodage et benchmark avant la remise

Réseau

  • Fabric de calcul InfiniBand ou Ethernet pour l'IA
  • Réseaux de stockage et front-end séparés
  • Réseau de gestion hors bande
  • Segmentation par rapport au réseau de l'entreprise
  • DPU en option pour l'isolation des locataires

Stockage

  • Espace temporaire NVMe local dans chaque serveur
  • Système de fichiers parallèle partagé avec GPUDirect Storage
  • Stockage objet compatible S3
  • Instantanés, sauvegarde et copies hors site
  • Base de données vectorielle pour le RAG

Plateforme

  • Kubernetes avec le GPU Operator NVIDIA ou AMD
  • Slurm ou un ordonnanceur par lots Kubernetes pour les tâches d'entraînement
  • Partage de GPU : MIG, time-slicing ou vGPU
  • Quotas et priorités par équipe
  • Registre d'images et infrastructure as code

Services d'IA

  • Service de modèles : vLLM, SGLang, NVIDIA Dynamo et NIM, ou images AMD ROCm
  • Un catalogue de modèles ouverts et commerciaux approuvés
  • Interface de chat et d'assistant pour le personnel
  • Pipelines RAG connectés à vos référentiels documentaires
  • Notebooks, fine-tuning et suivi des expériences (MLflow)

Sécurité et gouvernance

  • Authentification unique et accès basé sur les rôles
  • Gestion des secrets et chiffrement au repos et en transit
  • Journaux d'audit de chaque appel de modèle et de chaque accès aux données
  • Politiques définissant les données que chaque assistant peut utiliser
  • Option isolée (air-gapped) pour les travaux classifiés ou réglementés

Exploitation

  • Surveillance de l'état et de l'utilisation des GPU (DCGM, Prometheus, Grafana)
  • Rapports de coûts et d'utilisation par équipe
  • Processus de mise à jour des correctifs, des pilotes et des modèles
  • Planification de la capacité pour la prochaine génération de GPU
  • Service managé et astreinte en option

Retour au sommaire

Privé, public ou hybride : comparatif

Les compromis habituels. La plupart des organisations finissent en hybride : une base privée pour le travail régulier et le cloud public ou de la capacité louée pour les pics.

Services d'IA du cloud publicCloud privé GPU dans un centre de données de colocationCloud privé GPU dans vos locauxHybride
Mode de paiementAu token, à l'heure ou par utilisateur, chaque moisMatériel acheté, financé ou loué, plus l'espace en rack et l'électricitéMatériel acheté, financé ou loué ; votre propre alimentation et refroidissementUne base privée plus un cloud facturé à l'usage pour les pics
Idéal lorsqueTester des idées, charges de travail irrégulières ou courtesUsage régulier de l'IA sans salle serveur adaptéeUsage régulier, règles strictes sur les données et site doté d'alimentation et de refroidissementCharge de base régulière avec de grands pics occasionnels
Emplacement des donnéesLes régions du fournisseurUn centre de données au Royaume-Uni de votre choixVotre propre bâtiment, isolable du réseau (air-gapped)Données sensibles en privé, le reste là où c'est le moins cher
Délai de démarrageQuelques minutesDe quelques semaines à quelques mois : délais de livraison du matériel et installationDe quelques semaines à quelques mois, davantage si le site nécessite des travaux d'alimentation ou de refroidissementDémarrer dans le cloud, rapatrier le travail régulier à mesure que le matériel arrive
Coût à mesure que l'usage augmenteAugmente à chaque utilisateur et à chaque appelStable jusqu'à ce qu'il vous faille plus de GPUStable jusqu'à ce qu'il vous faille plus de GPUBase stable, pics facturés à l'usage
Latence vers vos systèmesVia Internet ou une liaison privéeFaible, avec une connexion privée vers vos sitesLa plus faible, sur votre propre réseauFaible pour les charges de travail privées
Choix des modèles et des outilsLe catalogue et les limites du fournisseurTout ce que vous pouvez faire tournerTout ce que vous pouvez faire tournerLes deux
Compétences nécessairesCompétences cloud et applicativesExploitation de la plateforme et des GPU, ou un service managéExploitation de la plateforme, des GPU et des installations, ou un service managéLes deux, plus le placement des charges de travail
Disponibilité des GPULes GPU les plus récents sont souvent épuisés ou rationnésGarantie une fois installésGarantie une fois installésBase garantie, pics au mieux
Renouvellement du matérielAu choix du fournisseurÀ votre choix, tous les 3 à 5 ans ; les anciens GPU passent à des tâches plus légèresÀ votre choix, tous les 3 à 5 ansÀ votre choix pour la base

Retour au sommaire

Construire un cloud privé GPU de A à Z

Les huit étapes par lesquelles nous faisons passer chaque cloud privé, du premier atelier à une plateforme que vos équipes utilisent au quotidien.

  1. 1

    Charges de travail et dimensionnement

    Listez les assistants, agents, recherches et tâches d'entraînement que vous voulez faire tourner, les modèles, les utilisateurs et les données. Nous traduisons cela en GPU, VRAM, stockage et réseau.

    Ce que vous décidez: Quelles charges de travail passent en premier, et à quoi ressemble la réussite

  2. 2

    Site

    Votre propre salle serveur, votre centre de données ou une salle de colocation au Royaume-Uni. Nous étudions l'alimentation, le refroidissement, la charge au sol et la connectivité, ou trouvons un espace de colocation conçu pour les racks GPU.

    Ce que vous décidez: Sur site ou en colocation

  3. 3

    Conception matérielle

    Serveurs GPU (NVIDIA ou AMD, Dell ou NVIDIA DGX), nœuds CPU, niveaux de stockage, fabric de calcul et réseau de gestion, avec des pièces de rechange et de la marge pour évoluer.

    Ce que vous décidez: Famille de GPU, fournisseur et marge de croissance à prévoir

  4. 4

    Financement

    Achetez comptant, étalez le coût avec un crédit-bail ou une location avec option d'achat, ou louez de la capacité en attendant l'arrivée de votre propre matériel.

    Ce que vous décidez: Investissement, crédit-bail ou capacité louée

  5. 5

    Assemblage et tests en charge prolongée

    Livraison, mise en rack, câblage et mise sous tension, puis versions de firmware de référence, tests de la fabric, benchmarks du stockage et rodage de plusieurs jours de chaque GPU.

    Ce que vous décidez: Tests de réception et calendrier

  6. 6

    Plateforme

    Kubernetes et les GPU operators, ordonnanceurs, partage de GPU, registre d'images, identité, secrets et supervision, le tout sous forme de code pour pouvoir être reconstruit.

    Ce que vous décidez: Kubernetes, Slurm ou les deux

  7. 7

    Services d'IA

    Service de modèles, catalogue de modèles, assistant pour le personnel, RAG sur vos documents, notebooks et fine-tuning, connectés à vos systèmes.

    Ce que vous décidez: Les modèles approuvés et les données que chaque service peut utiliser

  8. 8

    Remise et exploitation

    Procédures d'exploitation, formation de votre équipe, reporting des coûts et de l'utilisation, et exploitation par vos soins ou par notre service managé.

    Ce que vous décidez: Qui l'exploite au quotidien

Retour au sommaire

Essayez : le laboratoire du cloud IA privé

Quatre façons d'explorer les options pour vos propres charges de travail d'IA. Rien de ce que vous saisissez ne quitte votre navigateur, sauf si vous choisissez de nous l'envoyer.

Six questions, une par étape. À la fin, vous obtenez une conception de départ : matériel, VRAM, stockage, réseau, alimentation et plateforme, ainsi que les prochaines étapes.

1Charge de travail2Échelle3Modèles4Données5Site6Paiement

1 of 6

Qu'est-ce qui tournera dessus en premier ?

Retour au sommaire

FAQ sur le cloud privé GPU

Quelle peut être la taille minimale d'un cloud privé GPU ?
Un seul serveur PCIe avec quelques GPU RTX PRO 6000, exécutant la même plateforme qu'un grand cluster, est un véritable cloud privé. Beaucoup de clients commencent ainsi, ou avec DGX Spark pour le développement, puis ajoutent des serveurs à mesure que l'usage augmente.
NVIDIA ou AMD ?
Les deux conviennent. NVIDIA bénéficie du support logiciel le plus large et du plus grand nombre de services d'IA prêts à l'emploi. AMD Instinct offre beaucoup de mémoire par GPU, ce qui convient à l'inférence de grands modèles, et exécute les principaux frameworks open source sur ROCm. Nous dimensionnons les deux et recommandons celui qui correspond à vos modèles et à votre équipe.
Peut-on utiliser des modèles open source ?
Oui. Les modèles open-weight tournent sur vLLM, SGLang et des serveurs similaires, aux côtés de modèles commerciaux et de vos propres modèles affinés. Nous vous aidons à choisir les modèles et à mettre en place un catalogue approuvé.
Doit-il obligatoirement se trouver dans nos locaux ?
Non. De nombreux clouds privés fonctionnent dans un centre de données de colocation au Royaume-Uni offrant l'alimentation et le refroidissement nécessaires aux racks GPU, avec une connexion privée vers vos sites. Le matériel vous reste dédié.
Combien de temps cela prend-il ?
Un cloud privé d'entrée peut être opérationnel quelques semaines après l'arrivée du matériel. Les clusters plus grands dépendent des délais de livraison des GPU et des travaux sur site ; nous vous remettons un plan daté dès la phase de conception et pouvons louer de la capacité en attendant.
Pouvez-vous l'exploiter pour nous ?
Oui. Nous pouvons exploiter toute la plateforme en service managé, ou la construire, former votre équipe et l'accompagner.
Comment le financer ?
Achetez comptant, étalez le coût avec un crédit-bail ou une location avec option d'achat, ou louez de la capacité au mois. Consultez la location de GPU pour découvrir les options.

Pages associées

Centres de données IA · Clusters GPU · Location de GPU · IA privée · Usine d'IA · Mise en place MLOps

Retour au sommaire

Planifiez votre cloud privé GPU

Indiquez-nous les charges de travail, les utilisateurs et les règles sur les données, ou envoyez vos réponses au parcours de construction, et nous reviendrons vers vous avec une conception, un plan daté et le coût d'un achat, d'un financement ou d'une location.

Parlez-nous d'un cloud privéParcourir les serveurs GPU