Après le bac à sable, la keynote de Jensen Huang à la GTC Berlin s'est tournée vers ce qui rend un agent propre à une entreprise : ses connaissances. La diapositive derrière lui présentait l'Agent Knowledge Foundation. Les documents non structurés suivent un chemin. Les bases de données structurées en suivent un autre. Cet article suit cette diapositive, puis les exemples de partenaires qu'il a cités pour le post-entraînement de Nemotron, sans présenter aucun d'entre eux comme une étude de cas de Workstation.
Pourquoi un modèle de base n'est pas la mémoire de l'agent
L'ordre des éléments choisi par Huang était délibéré. D'abord le harnais, exécuté dans un bac à sable OpenShell. Ensuite, Nemotron comme modèle de langage. Ces deux éléments, a-t-il dit, ne sont qu'un début. Ce qui transforme un agent en ce qu'il a appelé un super-agent, c'est l'accès aux propres connaissances de l'entreprise. Les bibliothèques et les modèles dédiés à cette tâche sont ceux que NVIDIA a réunis sur une seule diapositive sous le nom d'Agent Knowledge Foundation.
Les données d'une entreprise se présentent sous deux formes. Les documents, PDF et autres fichiers qu'une IA doit lire. Et les lignes d'une base de données. La fondation est l'ensemble des bibliothèques qui extraient le sens des deux.
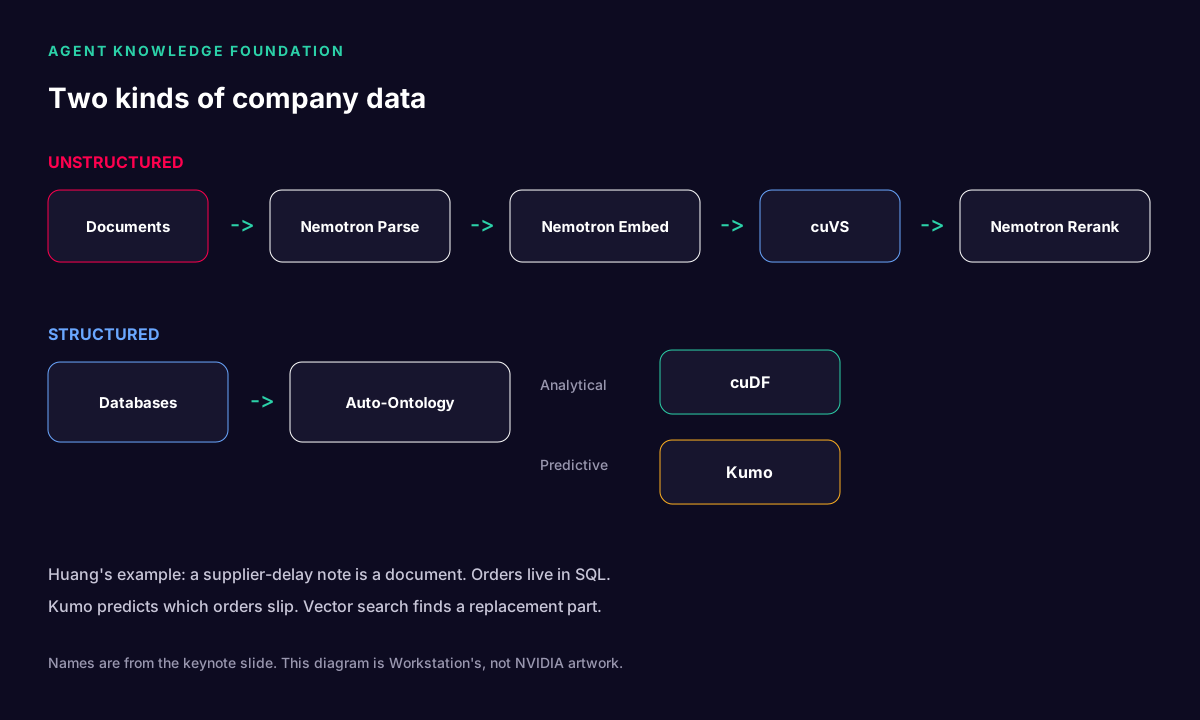
Le chemin des documents
De gauche à droite, sur la ligne non structurée de la diapositive :
- Nemotron Parse lit les documents. Huang l'a qualifié de premier plan mondial et de « top of leaderboard ». Il n'a pas précisé de quel classement il s'agissait. Nous n'en inventerons pas un.
- Nemotron Embed transforme une requête et les connaissances analysées en vecteurs afin de pouvoir les associer. Il a employé la même expression « top of leaderboard ».
- cuVS assure la recherche vectorielle. La diapositive le place entre Embed et Rerank. cuVS est la bibliothèque de NVIDIA pour la recherche de similarité sur GPU.
- Nemotron Rerank prend les nombreux passages renvoyés par la recherche et les classe selon leur pertinence par rapport à la question.
Il s'agit d'un pipeline de récupération, représenté par des noms de produits plutôt que par une boîte « RAG » générique. Analyser, vectoriser, rechercher, reclasser. L'agent doit encore être autorisé à l'appeler. Dans le schéma à cinq éléments, toute cette ligne correspond à l'élément connaissances, accessible par un outil que la politique du bac à sable autorise.
Le chemin des bases de données
La ligne structurée commence par Auto-Ontology, puis se divise.
- Le travail analytique va vers cuDF, la bibliothèque de dataframes sur GPU.
- Le travail prédictif va vers Kumo. La transcription de la keynote orthographie ce nom « QMO » et « CUMA ». La diapositive dans la salle l'écrit Kumo. Nous suivons la diapositive.
L'exemple de Huang est celui à retenir, car il utilise les deux lignes. Une note indiquant qu'un fournisseur sera en rupture, ou en retard, arrive sous forme de document. Les commandes que ce fournisseur alimente sont en SQL. Kumo est, selon lui, le moyen de prédire quelles commandes prendront du retard, et de combien. Trouver un composant de remplacement est une recherche vectorielle dans les documents d'ingénierie. Une décision, deux formes de données, deux outils.
Des poids ouverts, puis vos données
Avant la diapositive, Huang a plaidé pour des modèles ouverts que l'on peut inspecter. Nemotron pour le langage. Cosmos comme modèle de fondation du monde. GR00T pour la robotique humanoïde. Alpamayo pour la conduite autonome. Earth-2 pour la physique. Il a déclaré que NVIDIA publie les poids, les données utilisées pour construire le modèle et les scripts permettant de le reproduire, afin qu'un laboratoire puisse en voir la provenance. Le mot « Providence » dans la transcription brute signifie provenance.
Il a aussi été franc sur le classement. Ces modèles de langage ne sont pas automatiquement à la pointe de la pointe. La personnalisation, avec des partenaires, est selon lui le moyen d'en faire un modèle de pointe pour une tâche donnée, et de transformer des données propriétaires en ce qu'il a appelé une intelligence souveraine. L'expression « super intelligence », plus loin dans le même passage, est sa formule pour le résultat de ce post-entraînement. C'est une affirmation sur l'adéquation à une tâche, pas un QI mesuré.
Les exemples qu'il a cités sur scène, dans la transcription publiée, sont les suivants. Nous n'avons pas vérifié ces collaborations avec des clients au-delà du fait qu'il les a mentionnées :
- A21 aidant Alice, en transformant Nemotron en un modèle qui, selon lui, dépasse les capacités de pointe sur leur tâche.
- Base10 aidant CodeRabbit, en affinant Nemotron sur les données de ce client.
- Trajectory et Harvey, avec le post-entraînement de Nemotron.
- Scale travaillant avec Skydance, selon le même schéma.
- Palantir avec le Tampa General Hospital.
La roue des néoclouds présentée plus tard dans la keynote orthographie le nom d'une entreprise Baseten. La transcription de ce passage indique Base10. Nous ne fusionnons pas les deux en une seule société. Si vous êtes CodeRabbit, Harvey, Skydance ou Tampa General, la phrase ci-dessus est celle de Huang, et non un résultat que nous avons reproduit.
Les outils sont le dernier élément
Des connaissances sans outils laissent l'agent dans le rôle de lecteur. Le dernier temps fort de Huang portait sur CUDA-X : des bibliothèques métier utilisées dans la science, l'ingénierie, la recherche et le travail créatif. Il les a appelées les joyaux de la couronne, car un assistant qui conçoit ou calcule doit appeler un algorithme, et pas seulement une API de chat. La démonstration RTX Spark, plus tard dans la keynote, l'a résumé d'un trait : Hermes comme harnais, Nemotron et un modèle que la transcription appelle « OpenAI's GPT-6 Astra », et des outils CUDA-X dont FreeCAD, Blender, Isaac Sim, le moteur physique Newton et Isaac Lab. Cette démonstration était celle de NVIDIA, sur scène, pour un robot Hugging Face appelé Microduck. Ce n'est pas un benchmark de Workstation.
Par quoi commencer
Si vous équipez un agent de vos propres fichiers, la diapositive de Berlin est une liste de contrôle plutôt qu'un bon de commande.
- Placez le harnais dans un bac à sable avant de le connecter au stockage de fichiers. L'article sur OpenShell couvre cette moitié.
- Déterminez quelles connaissances sont des documents et lesquelles sont des tables. N'envoyez pas les deux dans le même pipeline en espérant que cela fonctionne.
- Analysez et vectorisez les documents. Effectuez la recherche avec une bibliothèque vectorielle. Reclassez avant que le modèle ne voie l'ensemble.
- Gardez le SQL en SQL. Utilisez une bibliothèque de dataframes pour l'analyse et un modèle prédictif uniquement lorsque vous avez une question comme l'exemple du fournisseur de Huang.
- Ne post-entraînez un modèle ouvert que lorsque le modèle générique se trompe d'une manière que vos données peuvent corriger. Il a dit que la technologie existe. Il n'a pas dit qu'elle est bon marché ni que chaque affinage est gagnant.
Dérouler l'exemple du fournisseur
Reprenez l'histoire de Huang dans l'ordre où un système l'exécuterait réellement.
- Un PDF ou un e-mail indique qu'un fournisseur sera en retard. Ce fichier arrive dans Nemotron Parse.
- Nemotron Embed transforme la note de retard, ainsi que la requête « quelles commandes cela affecte-t-il ? », en vecteurs.
- cuVS interroge la base vectorielle. Nemotron Rerank conserve les passages qui concernent réellement ce fournisseur.
- Le carnet de commandes ne se trouve pas dans cette base. Il est en SQL. Auto-Ontology est le nom donné sur la diapositive au fait de rendre ce monde structuré lisible pour l'agent. cuDF est l'étape analytique sur ces lignes. Kumo est l'étape prédictive : qui est en rupture, et pour combien de temps.
- Une pièce de remplacement relève à nouveau du non structuré : un plan ou une spécification. La recherche la renvoie. Le harnais propose une action. Le bac à sable décide si cette action est autorisée.
Sautez l'étape 5 et vous obtenez un modèle très cultivé doté d'un shell. C'est précisément l'échec qu'OpenShell vise à éviter.
Quand ne pas post-entraîner
La liste de partenaires de Huang est une liste d'équipes qui avaient déjà une tâche et des données. Ce n'est pas une raison d'affiner dès le premier jour. Si le modèle générique se trompe parce qu'il ne voit pas vos fichiers, corrigez d'abord la récupération. S'il voit les fichiers et utilise malgré tout les mauvais termes, les mauvaises unités ou la mauvaise politique, alors le post-entraînement est l'étape qu'il a décrite : partir de Nemotron, conserver la recette pour savoir ce que vous avez modifié, et tester sur vos propres traces. Il a dit que le résultat peut atteindre la pointe pour cette tâche. Il n'a pas publié les scores. Nous non plus.
CUDA-X est l'étagère d'outils sous-jacente. Il a déclaré qu'un seul ordinateur exécute de la dynamique des fluides, de la physique des particules, de la chimie quantique, du traitement de données et du ray tracing, et que le chemin GPU est de l'ordre de 10, 50 ou 100 fois plus rapide qu'une exécution native sur CPU. Cette fourchette a été énoncée sur scène. Ce n'est pas un benchmark unique avec un jeu de données nommé. Utilisez-la comme son argument expliquant pourquoi les outils ont leur place sur un GPU, puis mesurez la bibliothèque que vous appelez réellement.
Sources
- Transcription de la keynote, y compris le passage sur la fondation de connaissances et les noms des partenaires : SB61112
- Diapositive photographiée pendant la keynote : chemin non structuré Nemotron Parse, Nemotron Embed, cuVS, Nemotron Rerank ; chemin structuré Auto-Ontology, cuDF, Kumo.
- Article associé : la vue d'ensemble de la keynote


