Ce guide s’adresse aux ingénieurs qui vont spécifier, installer en baie et exploiter des systèmes RTX PRO 6000 Blackwell Server Edition : responsables d’infrastructure, équipes MLOps et plateforme, et les personnes qui valident le budget électrique. Il explique ce qu’est la carte, comment dimensionner la mémoire GPU pour de vrais modèles, MIG, la topologie PCIe et le réseau, l’alimentation et le refroidissement au Royaume-Uni, la pile logicielle, la validation d’un nouveau serveur et un plan de déploiement. Les spécifications proviennent de la page produit et de la fiche technique de NVIDIA ; la conception à l’échelle de la baie provient de la documentation RackScale 32 publiée par AMAX. Tout le reste relève de notre propre expérience d’ingénierie, et nous le précisons lorsqu’un chiffre est une estimation.

1. La carte en un tableau
| Élément | RTX PRO 6000 Blackwell Server Edition |
|---|---|
| Architecture | NVIDIA Blackwell |
| Cœurs CUDA | 24 064 |
| Tensor Cores | 752, cinquième génération, avec FP4, FP6, FP8, FP16, BF16 et TF32 et le Transformer Engine de deuxième génération |
| RT Cores | 188, quatrième génération ; 355 TFLOPS de performance RT de crête |
| Débit Tensor de crête (NVIDIA) | FP4 4 PFLOPS · FP8 2 PFLOPS · FP16/BF16 1 PFLOPS · TF32 234 TFLOPS |
| FP32 | 120 TFLOPS |
| Mémoire | 96 GB GDDR7 avec ECC, 512 bits, 1 597 GB/s |
| Partitionnement | MIG, jusqu’à 4 instances isolées |
| Médias | 4 × NVENC (9e génération, ajoute l’encodage H.264 et HEVC 4:2:2), 4 × NVDEC (6e génération) |
| Affichage | 4 × DisplayPort 2.1 |
| Interface hôte | PCIe Gen 5 x16 ; pas de NVLink |
| Alimentation | Jusqu’à 600 W, configurable |
| Format | Air : double emplacement, pleine hauteur, pleine longueur, passive. Liquide : simple emplacement |
| Sécurité | Démarrage sécurisé avec racine de confiance matérielle |
Deux lignes de ce tableau déterminent la plupart des choix de conception : 96 GB à 1,6 TB/s, qui fixe la taille du modèle, la concurrence et la vitesse de décodage, et 600 W sur PCIe sans NVLink, qui fixe l’alimentation, le refroidissement et la manière de répartir le travail entre les GPU.
Une remarque sur les chiffres Tensor. NVIDIA publie des valeurs de crête ; le comparatif d’AMAX indique 3,7 PFLOPS en FP4 et 117 TFLOPS en FP32, ce qui reflète une hypothèse de fréquence ou de puissance différente. Considérez-les tous comme des plafonds. Pour l’inférence LLM avec de petites tailles de lot, c’est généralement la bande passante mémoire, et non le débit Tensor, qui limite le nombre de tokens par seconde.
2. Sa place dans la gamme NVIDIA
- Face à la L40S : 96 GB de GDDR7 au lieu de 48 GB de GDDR6, 1 597 GB/s au lieu de 864 GB/s, PCIe Gen 5 au lieu de Gen 4, FP4 et MIG en plus, et 600 W au lieu de 350 W. D’après notre expérience, un modèle qui nécessitait deux cartes L40S pour la mémoire tient généralement sur une seule RTX PRO 6000.
- Face aux HGX B200/B300 : les cartes HGX relient huit GPU par NVLink et embarquent de la HBM3E. Elles sont l’outil adapté à l’entraînement et aux très grands modèles qui exigent un parallélisme tensoriel sur huit GPU. La RTX PRO 6000 est l’outil adapté à l’inférence, au fine-tuning de modèles petits et moyens, au graphisme et à la simulation, dans des baies ordinaires refroidies par air.
- Face aux Workstation Editions : la Workstation Edition possède ses propres ventilateurs pour une tour de bureau, et la Max-Q Workstation Edition fonctionne à 300 W. La Server Edition est passive : elle ne fonctionne donc que dans un serveur qui fait circuler l’air à travers elle, ou dans sa version à refroidissement liquide.
3. Dimensionner la mémoire GPU pour les LLM
C’est généralement la mémoire, et non la puissance de calcul, qui vient à manquer en premier. Dimensionnez-la en trois parties : poids, cache KV et surcharge.
3.1 Poids
Les poids occupent parameters × bytes per parameter :
| Taille du modèle | BF16 (2 octets) | FP8 (1 octet) | FP4 (environ 0,5 octet plus les facteurs d’échelle) |
|---|---|---|---|
| 8B | 16 GB | 8 GB | environ 5 GB |
| 32B | 64 GB | 32 GB | environ 18 GB |
| 70B | 140 GB | 70 GB | environ 38 GB |
| 120B | 240 GB | 120 GB | environ 65 GB |
Les chiffres FP4 incluent une marge pour les facteurs d’échelle par bloc que stockent les formats 4 bits ; la surcharge exacte dépend du format et de l’outil qui a quantifié le modèle. Vérifiez toujours la précision sur votre propre jeu d’évaluation avant de passer un modèle de production en FP8 ou en FP4.
3.2 Cache KV
Chaque token de chaque conversation active conserve des clés et des valeurs pour chaque couche. Par token :
KV bytes per token = 2 × layers × kv_heads × head_dim × bytes per elementPour un modèle de la classe Llama 3.3 70B (80 couches, 8 têtes KV avec attention à requêtes groupées, dimension de tête 128) avec un cache BF16 :
2 × 80 × 8 × 128 × 2 bytes = 327,680 bytes ≈ 320 KiB per token
× 32,768 tokens of context   ≈ 10 GiB per full-length conversation
FP8 KV cache                 ≈ 5 GiB per full-length conversation
3.3 Exemples chiffrés
Supposons que le serveur d’inférence puisse utiliser 90 % de chaque GPU (valeur par défaut de vLLM --gpu-memory-utilization) et que quelques GB par GPU servent aux activations et aux graphes CUDA. Ce sont des estimations pour la planification, pas des garanties :
| Configuration | Mémoire utilisable | Poids | Reste pour le cache KV | Conversations complètes de 32k simultanées |
|---|---|---|---|---|
| 70B FP8 sur 1 GPU | ≈ 86 GB | ≈ 70 GB | ≈ 12 GB | environ 1 (KV BF16) ou 2 (KV FP8) |
| 70B FP4 sur 1 GPU | ≈ 86 GB | ≈ 38 GB | ≈ 44 GB | environ 4 (KV BF16) ou 8 (KV FP8) |
| 70B FP8 sur 2 GPU, parallélisme tensoriel 2 | ≈ 173 GB | ≈ 70 GB | ≈ 95 GB | environ 9 (KV BF16) ou 18 (KV FP8) |
| 70B FP8, quatre répliques sur un serveur 4U à huit GPU | ≈ 691 GB | ≈ 280 GB | ≈ 380 GB | environ 35 (KV BF16) ou 70 (KV FP8) |
La plupart des conversations sont bien plus courtes que 32k tokens, et les caches KV paginés ne conservent que ce qui est utilisé : la concurrence réelle est donc généralement plusieurs fois plus élevée. La méthode reste importante : dimensionnez à partir de vos longueurs de contexte réelles et de votre pic d’utilisateurs simultanés, et pas uniquement à partir du nombre de paramètres du modèle.
3.4 Débit, approximativement
Avec de petites tailles de lot, chaque token généré lit tous les poids une fois. Un plafond approximatif pour un flux unique est memory bandwidth ÷ weight bytes : 1 597 GB/s ÷ 70 GB ≈ 23 tokens/s pour un modèle 70B FP8 sur un GPU, et environ le double en FP4. Regrouper de nombreux utilisateurs dans un même lot porte le débit total bien au-delà du chiffre en flux unique, car les poids sont lus une fois par étape pour tout le lot. Mesurez vos propres prompts avec votre serveur d’inférence avant de vous engager sur un nombre de GPU.
4. MIG : une carte, jusqu’à quatre GPU
Le Multi-Instance GPU divise une carte en instances isolées, chacune avec sa propre mémoire, son propre cache et sa propre puissance de calcul, et une part garantie de la carte. Sur la RTX PRO 6000, cela signifie jusqu’à quatre instances d’environ 24 GB chacune. Usages typiques :
- Plusieurs petits modèles (embeddings, rerankers, modèles de chat 7B–8B) sur une seule carte, chacun dans sa propre instance.
- Des environnements de développement et de test pour plusieurs équipes sans qu’une équipe en prive une autre.
- Des clusters Kubernetes où chaque pod doit recevoir une tranche fixe de GPU.
Les profils disponibles dépendent de la version du pilote : listez-les donc sur votre serveur plutôt que de copier des noms trouvés ailleurs :
# Enable MIG mode on GPU 0 (needs the GPU to be idle; may need a GPU reset)
sudo nvidia-smi -i 0 -mig 1

# List the GPU instance profiles this card and driver support
nvidia-smi mig -i 0 -lgip

# Create instances from a profile ID shown above, with their compute instances (-C)
sudo nvidia-smi mig -i 0 -cgi <profile-id>,<profile-id> -C

# Check what you created
nvidia-smi -L
Sur Kubernetes, le gestionnaire MIG du NVIDIA GPU Operator applique une disposition MIG à partir d’une étiquette de nœud, puis le device plugin annonce chaque instance comme une ressource planifiable. Choisissez la stratégie single lorsque tous les GPU d’un nœud utilisent la même disposition, et mixed lorsqu’elles diffèrent.
MIG a un coût : un modèle qui a besoin de toute la mémoire de la carte ne peut pas tourner dans un quart de celle-ci, et vous ne pouvez pas exécuter en même temps des tâches MIG et des tâches sur la carte entière sur le même GPU. Planifiez quels GPU sont partitionnés et lesquels ne le sont pas.
5. Serveurs et topologie PCIe
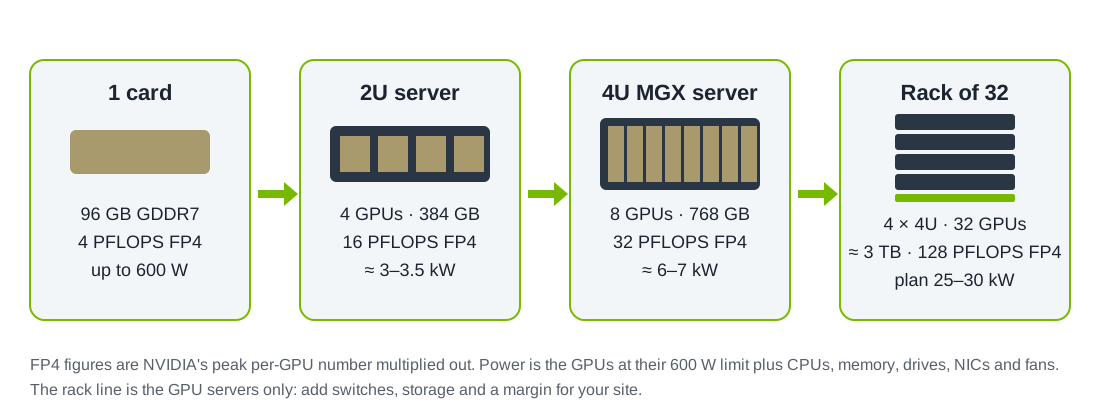
5.1 Les trois configurations courantes
- 2U, quatre GPU. Généralement un ou deux processeurs, avec les GPU sur des lignes directes du processeur ou un seul commutateur PCIe. Convient à un modèle avec un parallélisme tensoriel de 2 ou 4, ou à plusieurs répliques.
- 4U, huit GPU sur NVIDIA MGX. MGX est la conception de référence modulaire de serveur de NVIDIA. L’AceleMax AXG-428AG d’AMAX en est un exemple : deux processeurs AMD EPYC 9005, huit GPU double emplacement, jusqu’à cinq emplacements PCIe Gen 5 x16 pour les cartes réseau et jusqu’à huit disques NVMe E1.S.
- Une baie de 32 GPU. Quatre serveurs à huit GPU plus les commutateurs qui les relient. AMAX la publie sous le nom de RackScale 32 : 32 GPU RTX PRO 6000 Server Edition, EPYC 9005 bi-socket par serveur, jusqu’à environ 3 TB de GDDR7 (32 × 96 GB) et 128 PFLOPS en FP4 au total, avec Ethernet Spectrum-X ou Quantum InfiniBand. Elle est conçue pour être répétée baie après baie.
5.2 Pourquoi la topologie compte sans NVLink
Sans NVLink, les GPU échangent leurs données via PCIe. Deux GPU placés sous le même commutateur PCIe communiquent directement et rapidement ; deux GPU situés sur des sockets de processeur différents doivent traverser la liaison entre les sockets, ce qui est plus lent. Vérifiez la disposition sur n’importe quel serveur :
nvidia-smi topo -mDans la matrice, PIX ou PXB entre deux GPU signifie qu’ils partagent un chemin de commutateur PCIe ; NODE signifie qu’ils sont sur le même socket de processeur mais sur des ports racine différents ; SYS signifie que le trafic passe d’un socket à l’autre. Règles pratiques :
- Placez les GPU d’un même groupe de parallélisme tensoriel sur le même commutateur, ou au moins sur le même socket. Un parallélisme tensoriel de 2 ou 4 est généralement l’optimum sur PCIe.
- Pour davantage de GPU par modèle, préférez le parallélisme en pipeline entre groupes, ou exécutez plusieurs répliques derrière un répartiteur de charge. Les répliques évoluent de manière presque linéaire ; un parallélisme tensoriel large sur PCIe, non.
- Placez chaque carte réseau sous le même commutateur PCIe que les GPU qu’elle dessert, afin que GPUDirect RDMA puisse transférer les données entre la mémoire GPU et le réseau sans passer par le processeur. Certaines conceptions récentes de serveurs RTX PRO intègrent cela en utilisant des SuperNIC NVIDIA ConnectX-8, qui comportent un commutateur PCIe.
6. Réseau entre serveurs
Un serveur isolé n’a besoin que d’un réseau de centre de données ordinaire. Dès qu’une charge de travail s’étend sur plusieurs serveurs, comme pour le fine-tuning distribué, les très grands modèles répartis entre nœuds ou un parc d’inférence partagé avec chargement rapide des modèles, le réseau devient déterminant.
- Bande passante : prévoyez un port 400 Gb/s pour un ou deux GPU sur les serveurs qui exécutent des tâches multi-nœuds. Un serveur MGX à huit GPU équipé de quatre ou cinq cartes 400 Gb/s est une configuration courante.
- Fabric : NVIDIA Spectrum-X Ethernet (commutateurs Spectrum-4 avec cartes réseau ConnectX ou BlueField, en RoCE) ou Quantum InfiniBand. Spectrum-X convient aux équipes qui exploitent déjà Ethernet ; InfiniBand convient aux équipes HPC qui en ont l’habitude.
- Réseaux séparés : séparez la fabric GPU du réseau de stockage et du réseau d’administration (BMC et hors bande). Les mélanger est la cause habituelle de durées de tâches imprévisibles.
- Stockage : NVMe E1.S ou U.2 local pour les poids des modèles et les données temporaires, et un système de fichiers parallèle ou NVMe-over-fabrics si de nombreux serveurs chargent les mêmes grands modèles.
Pour les parcs d’inférence où chaque requête s’exécute sur un seul serveur, 100 ou 200 Gb/s par serveur suffisent généralement.
7. Alimentation et refroidissement dans les salles au Royaume-Uni
7.1 Budget électrique
| Système | Puissance GPU à 600 W | Système complet, estimation |
|---|---|---|
| 2U, 4 GPU | 2,4 kW | environ 3 à 3,5 kW |
| 4U, 8 GPU | 4,8 kW | environ 6 à 7 kW |
| Baie, 32 GPU | 19,2 kW | environ 25 à 30 kW, hors commutateurs réseau et stockage |
« Système complet » ajoute les processeurs, la mémoire, les disques, les cartes réseau, les ventilateurs et les pertes des alimentations. Utilisez le calculateur de puissance du constructeur pour la configuration exacte avant de finaliser un devis.
Au Royaume-Uni, une alimentation monophasée de 32 A en 230 V fournit environ 7,4 kW, assez pour un serveur à huit GPU avec peu de marge. Une baie de 32 GPU nécessite du triphasé : une alimentation triphasée de 32 A en 400 V fournit environ 22 kW ; prévoyez donc deux alimentations par baie, avec des voies A et B pour les blocs d’alimentation redondants. De nombreuses salles techniques existantes au Royaume-Uni sont conçues pour 5 à 10 kW par baie : la conception à 32 GPU implique donc généralement un site de colocation ou une mise à niveau de la salle.
7.2 Limites de puissance
La limite de puissance de la carte est configurable. L’abaisser sacrifie une partie des performances de crête, en échange de la possibilité de loger davantage de GPU avec la même alimentation et le même refroidissement. Le décodage LLM, limité par la bande passante mémoire, perd souvent moins que la puissance économisée, mais mesurez-le sur votre charge de travail.
# Show the allowed range and the current limit
nvidia-smi -q -d POWER

# Set GPU 0 to 450 W (must be inside the allowed range; resets at reboot)
sudo nvidia-smi -i 0 -pl 450
Appliquez la limite au démarrage avec une unité systemd ou votre outil de gestion de configuration, et consignez-la dans le registre des actifs afin que le personnel du support sache pourquoi un GPU fonctionne en dessous de son maximum.
7.3 Refroidissement
- Chaque kilowatt devient environ 3 412 BTU/h de chaleur. Une baie de 30 kW dépasse ce que la plupart des salles refroidies par air évacuent par baie sans confinement ni échangeurs de chaleur en porte arrière.
- La carte refroidie par air est passive : elle dépend des ventilateurs du serveur et d’un air d’entrée frais. Maintenez les températures d’entrée dans les limites du constructeur du serveur, utilisez des panneaux d’obturation et confinez les allées chaudes et froides.
- La version simple emplacement à refroidissement liquide convient aux configurations denses lorsque le site dispose déjà d’un refroidissement liquide. Ce n’est pas une solution de mise à niveau pour une salle refroidie par air.
8. La pile logicielle
- Système d’exploitation : une distribution LTS actuelle prise en charge par le constructeur du serveur et par NVIDIA, comme Ubuntu Server 22.04 ou 24.04 LTS, ou Red Hat Enterprise Linux 9.
- Pilote : une branche de pilote NVIDIA pour centre de données qui prend en charge Blackwell. Les GPU Blackwell nécessitent les modules noyau GPU ouverts de NVIDIA, et CUDA 12.8 ou ultérieur.
- Conteneurs : le NVIDIA Container Toolkit, configuré pour votre runtime.
- Orchestration : le NVIDIA GPU Operator sur Kubernetes, ou Slurm pour le traitement par lots.
- Service des modèles : vLLM, SGLang, TensorRT-LLM ou les microservices NVIDIA NIM pour les LLM ; Omniverse et votre moteur de rendu pour le graphisme ; RAPIDS pour la science des données.
- Supervision : NVIDIA DCGM avec dcgm-exporter vers Prometheus et Grafana.
# Container runtime (Docker shown)
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker

# Kubernetes: the GPU Operator from NVIDIA's Helm repository
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia && helm repo update
helm install --wait gpu-operator -n gpu-operator --create-namespace nvidia/gpu-operator
Un endpoint compatible OpenAI pour un modèle 70B sur deux GPU, avec des poids FP8 et un cache KV FP8 :
docker run --gpus '"device=0,1"' --ipc=host -p 8000:8000 \
  -v /models/hf:/root/.cache/huggingface \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2 \
  --quantization fp8 \
  --kv-cache-dtype fp8 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90
En production, épinglez l’image sur une version testée plutôt que latest, et conservez les poids du modèle sur un NVMe local pour que les redémarrages soient rapides.
9. Valider un nouveau serveur
Nous effectuons ces vérifications sur chaque système avant qu’il ne quitte l’atelier, puis à nouveau sur site :
# 1. Every GPU present, at the expected memory, power limit and PCIe link
nvidia-smi --query-gpu=index,name,memory.total,power.limit,pcie.link.gen.current,pcie.link.width.current --format=csv

# 2. ECC enabled and no uncorrectable errors
nvidia-smi -q -d ECC

# 3. Topology as designed (GPU and NIC pairs under the same switch)
nvidia-smi topo -m

# 4. NVIDIA's diagnostics, long run
dcgmi diag -r 3

# 5. GPU-to-GPU bandwidth inside the server (from NVIDIA's nccl-tests)
./build/all_reduce_perf -b 8 -e 4G -f 2 -g 8
Lancez ensuite un rodage de plusieurs heures à pleine charge, si possible avec la véritable charge d’inférence ou de rendu, en surveillant les températures, les fréquences et la puissance. Une carte qui réduit sa fréquence à l’atelier la réduira encore davantage dans une allée chaude.
Métriques DCGM utiles pour les alertes en production : DCGM_FI_DEV_GPU_TEMP, DCGM_FI_DEV_POWER_USAGE, DCGM_FI_DEV_FB_USED, DCGM_FI_DEV_GPU_UTIL et les événements d’erreur XID dans le journal système.
10. Un plan de déploiement
- Benchmark (1–2 semaines). Exécutez vos modèles et vos prompts sur un serveur RTX PRO 6000. Relevez les tokens par seconde, le délai avant le premier token et la mémoire, avec vos longueurs de contexte et votre concurrence réelles. Choisissez la précision (BF16, FP8 ou FP4) en fonction de la précision obtenue sur votre propre jeu d’évaluation.
- Dimensionnement et audit du site (1 semaine). Traduisez le benchmark en un nombre de GPU avec de la marge, puis vérifiez l’alimentation, le refroidissement, le réseau et l’espace en baie sur le site.
- Assemblage et rodage. Configuration identique pour chaque serveur : firmware, paramètres BIOS, pilote, limite de puissance et disposition MIG sous gestion de configuration.
- Pilote. Une équipe, un service, avec la supervision et une astreinte en place avant l’arrivée des utilisateurs.
- Montée en charge. Ajoutez des serveurs de même configuration. Passez à une fabric entre serveurs uniquement lorsqu’une charge de travail s’étend réellement sur plusieurs d’entre eux.
11. Questions qui nous sont posées
Peut-on mélanger des cartes RTX PRO 6000 et L40S dans un même serveur ? Techniquement oui, mais ne les placez pas dans le même groupe de parallélisme tensoriel. Gardez chaque modèle sur un seul type de GPU et utilisez l’ordonnanceur pour placer le travail.
Le FP4 est-il suffisant ? Pour de nombreux modèles instruct disposant de bons checkpoints 4 bits, oui ; pour certaines tâches, comme le code, les mathématiques et les longues chaînes de raisonnement, la précision baisse davantage. Testez sur vos propres données. Le FP8 est le choix par défaut sûr.
Peut-on faire du fine-tuning dessus ? Oui, pour le fine-tuning économe en paramètres (LoRA et QLoRA) de modèles petits et moyens, et pour le fine-tuning complet de modèles plus petits. Pour le fine-tuning complet de modèles de la classe 70B ou le pré-entraînement, les systèmes HGX avec NVLink sont plus adaptés.
Faut-il des licences particulières ? Le pilote et CUDA sont gratuits. NVIDIA AI Enterprise (qui inclut NIM) et le logiciel GPU virtuel de NVIDIA font l’objet de licences distinctes ; les piles open source comme vLLM n’en ont pas besoin.
Sources
- NVIDIA : RTX PRO 6000 Blackwell Server Edition, spécifications
- AMAX : RackScale 32 avec NVIDIA RTX PRO 6000 Blackwell Server Edition
- AMAX : AceleMax AXG-428AG
- AMAX : RTX PRO 6000 Blackwell Server Edition face à NVIDIA L40S
Pour l’argumentaire commercial et les systèmes que nous fournissons, consultez la page RTX PRO 6000 Blackwell Server Edition et notre article de blog.
Marques. NVIDIA, le logo NVIDIA, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, ConnectX, TensorRT, NIM et DCGM sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d’autres pays. AMAX et AceleMax sont des marques commerciales d’AMAX Engineering Corporation. AMD et EPYC sont des marques commerciales d’Advanced Micro Devices, Inc. Llama est une marque commerciale de Meta Platforms, Inc. Ubuntu est une marque commerciale de Canonical Ltd. Red Hat est une marque commerciale de Red Hat, Inc. Kubernetes est une marque commerciale de The Linux Foundation. Docker est une marque commerciale de Docker, Inc. Toutes les autres marques appartiennent à leurs propriétaires respectifs. Workstation est un fournisseur indépendant ; aucune approbation de la part de ces entreprises n’est sous-entendue. La vidéo appartient à NVIDIA.


