L'observabilité n'est pas facultative : faites-en une norme d'entreprise
Pour les dirigeants et les propriétaires : centralisez la télémétrie, standardisez les plateformes et traitez la supervision comme une exigence de mise en production, et non comme une préférence d'équipe
 Balinder Walia8 octobre 20264 min read
Pour les dirigeants et les chefs d'entreprise : l'observabilité n'est pas une préférence d'outil ; c'est ainsi que l'entreprise sait si ses produits, ses paiements et ses agents IA se portent bien. Faites-en une norme centralisée, et non un projet annexe facultatif. Complément technique : Big Prometheus, avantages et inconvénients, et MoSCoW du paysage des outils. Sur le même thème : goulots d'étranglement des LLM & maîtrise des coûts.
Pourquoi c'est une décision d'entreprise, et non un passe-temps de SRE
Lorsqu'un paiement échoue à 2 heures du matin, la direction ne demande pas quelle base de données open source a remporté un benchmark. Elle demande : combien de temps avant de savoir, combien de temps avant de corriger, et comment éviter que cela se reproduise ? Ces réponses n'existent que si les métriques, les journaux, les traces et les alertes résident dans un système partagé avec une responsabilité clairement définie.
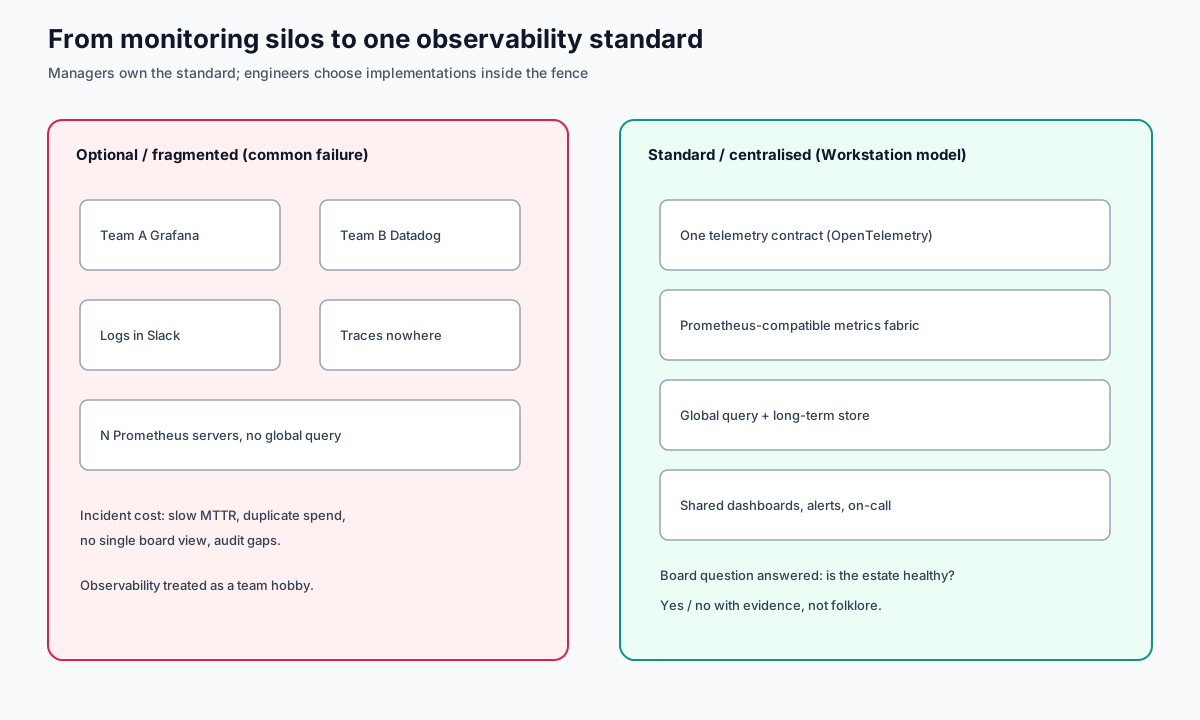
Une observabilité facultative entraîne des défaillances prévisibles :
- Des angles morts : un service critique « n'a pas eu le temps » d'ajouter des métriques.
- La prolifération des outils : trois APM, deux produits de journalisation, aucune source unique de vérité pour les SLO.
- Des surprises de coûts : les labels à forte cardinalité et les traces non échantillonnées font exploser les budgets.
- Des lacunes d'audit : les régulateurs et les grands clients demandent des preuves ; des captures d'écran issues de Slack ne comptent pas.
Ce que « centralisé et standardisé » signifie en pratique
Centralisé ne signifie pas un fournisseur unique pour toujours. Cela signifie :
- Un seul contrat de télémétrie : chaque service de production émet des métriques, des journaux et des traces dans des formats approuvés (généralement OpenTelemetry + Prometheus).
- Un seul endroit pour interroger l'ensemble du parc : « quels clusters sont en feu ? » et « quel était le taux d'erreur il y a sept semaines ? » sans passer d'une interface à l'autre parmi dix.
- Une seule taxonomie d'astreinte et d'alertes : la gravité, la responsabilité et l'escalade constituent un langage commun.
- Un seul garde-fou FinOps : la rétention, l'échantillonnage et les budgets de cardinalité relèvent de la politique, pas de l'héroïsme.
Inspiré du débat open source autour de « Big Prometheus » (Thanos, Cortex/Mimir, M3, VictoriaMetrics), le choix technique porte sur la manière de déployer cette norme à l'échelle de nombreux clusters Kubernetes, et non sur la nécessité d'une norme.
Le MoSCoW en une diapositive pour la direction
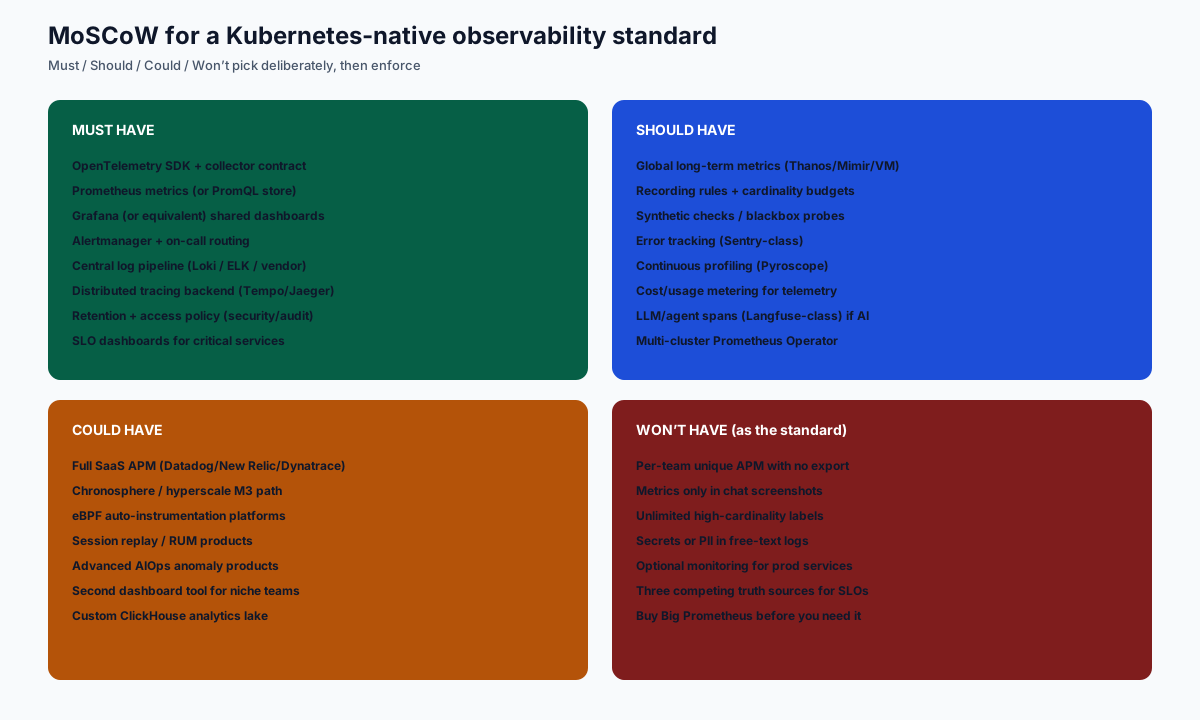
- Must : contrat OpenTelemetry, métriques PromQL, tableaux de bord partagés, alertes et astreinte, journaux centralisés, traçage, politique de rétention et d'accès, SLO pour les parcours critiques.
- Should : stockage global des métriques à long terme, budgets de cardinalité, tests synthétiques, suivi des erreurs, profilage, mesure du coût de la télémétrie.
- Could : APM SaaS complet, piles commerciales à très grande échelle, auto-instrumentation eBPF, RUM et relecture de sessions.
- Won't (en tant que norme) : APM propres à chaque équipe sans export, métriques sous forme de captures d'écran, cardinalité illimitée, supervision facultative en production, trois sources de SLO concurrentes.
Ce que les dirigeants doivent financer et imposer
- La responsabilité de la plateforme : une petite équipe est responsable de la norme ; les équipes produit l'utilisent.
- La définition de « terminé » : aucune mise en production sans signaux clés ni runbooks liés aux alertes.
- Le budget comme politique : payez délibérément la rétention et les performances des requêtes ; ne « faites pas d'économies » en devenant aveugle.
- Des revues trimestrielles : prolifération des outils, tendances MTTA/MTTR et principaux responsables de forte cardinalité.
La position de Workstation
Workstation exploite des boutiques de GPU, des agents IA, des proxys en périphérie et des anneaux de promotion. Ces surfaces ne restent fiables que si l'observabilité est obligatoire sur toute la chaîne INT → TEST → ACC → PROD, avec la même discipline que celle que nous appliquons aux secrets et aux mises en production. Pour l'analyse technique approfondie (options Big Prometheus, avantages et inconvénients en toute franchise, et un MoSCoW complet du paysage des outils), lisez l'article technique.
Vous souhaitez une norme d'observabilité unique pour vos clusters et vos charges de travail IA ? Parlez à Workstation.