NVIDIA UFM pour les clusters d'IA : pourquoi la visibilité de la fabric InfiniBand détermine ce que valent vos GPU
Les trois niveaux d'UFM, trois configurations de cluster réelles, et comment Workstation fournit, met en place et exploite la supervision
 Balinder Walia9 novembre 202614 min read
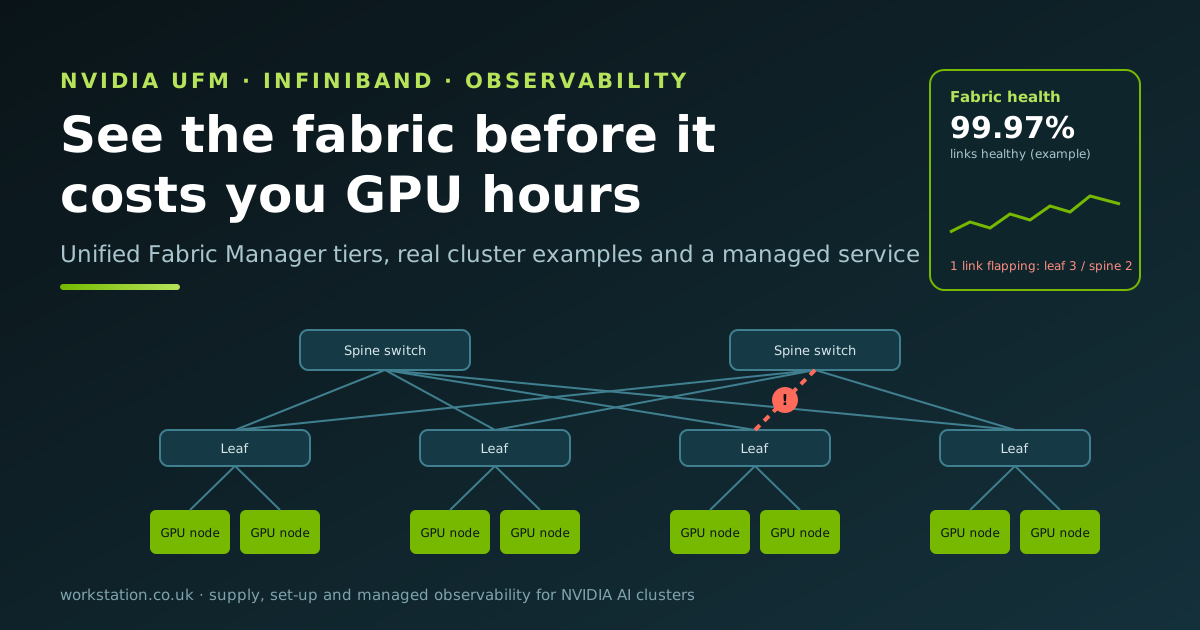
Les GPU attirent l'attention et le budget. Le réseau qui les relie détermine quelle part de ce budget se transforme en travail utile. Cet article s'adresse aux directeurs informatiques, aux CTO et aux responsables du calcul pour la recherche qui exploitent ou achètent un cluster NVIDIA InfiniBand. Il explique simplement ce que fait NVIDIA Unified Fabric Manager (UFM), lequel de ses trois niveaux convient à quel cluster, ce que vaut une meilleure visibilité de la fabric en heures GPU, et comment Workstation fournit, met en place et exploite la supervision pour vous. Les ingénieurs qui veulent les plugins, la configuration OpenTelemetry et les règles d'alerte liront l'article technique.
Version interactive : ouvrez dix-sept exemples de tableaux de bord, de la santé de la fabric au coût par heure GPU, avec les requêtes et les seuils d'alerte qui sous-tendent chacun d'eux.

Pourquoi la fabric détermine ce que valent vos GPU
Entraîner un grand modèle, ou le servir sur plusieurs serveurs, est un sport d'équipe pour les GPU. Toutes les quelques millisecondes, ils s'arrêtent et échangent leurs résultats entre eux via le réseau. La tâche ne peut avancer qu'à la vitesse de l'échange le plus lent. Si un lien parmi plusieurs centaines fonctionne avec des erreurs, retransmet des paquets ou passe discrètement à une vitesse inférieure, chaque GPU de cette tâche l'attend.
C'est ce qui distingue le réseau d'IA du réseau bureautique. Sur un réseau ordinaire, un lien lent gêne quelques utilisateurs. Sur une fabric d'IA, un lien lent transforme une tâche de 256 GPU en une file d'attente de 256 GPU. Et le symptôme ne ressemble pas à un problème réseau. Il ressemble à « l'entraînement est plus lent cette semaine » ou à « les GPU ne sont qu'à 60 % ». Les équipes passent alors des jours à optimiser un logiciel qui n'a jamais été en cause.
Le calcul est assez simple pour être présenté à un directeur financier. Prenez un cluster de 256 GPU et attribuez à chaque heure GPU un coût complet de 2,50 £ (amortissement du matériel, électricité, refroidissement, espace et support ; votre chiffre sera différent). Ce cluster représente environ 2,24 millions d'heures GPU par an :
- Perdre 1 % d'utilisation à cause de problèmes de fabric coûte environ 56 000 £ par an.
- Un seul lien instable qui bloque un entraînement de 256 GPU pendant trois heures avant que quelqu'un ne s'en aperçoive coûte environ 770 heures GPU, soit 1 900 £, plus le redémarrage depuis le dernier point de reprise.
- Un émetteur-récepteur défaillant remplacé pendant une fenêtre planifiée plutôt qu'en pleine exécution permet d'économiser autant, ainsi que l'intervention du week-end.
Ces chiffres sont illustratifs, mais la logique est toujours la même : le coût d'une surveillance correcte de la fabric est faible comparé au temps GPU qu'elle protège.
Ce qu'est NVIDIA UFM, en termes simples
InfiniBand est le réseau que la plupart des grands clusters d'IA et de HPC utilisent entre les serveurs GPU, parce qu'il est rapide, prévisible et décharge les serveurs d'une grande partie du travail. Toute fabric InfiniBand a besoin d'un gestionnaire de sous-réseau (subnet manager), le logiciel qui découvre chaque commutateur et chaque adaptateur, calcule les routes et assure le fonctionnement de la fabric. NVIDIA Unified Fabric Manager est le logiciel de NVIDIA pour exploiter et surveiller cette fabric à l'échelle d'un centre de données.
Voyez-le comme trois métiers réunis dans une même famille de produits : NVIDIA décrit la plateforme complète sur sa page officielle UFM.
- Voir. Collecter les compteurs de chaque port de commutateur, de chaque adaptateur et de chaque câble : trafic, erreurs, retransmissions, températures, vitesses de liaison. Les afficher en direct et en conserver l'historique.
- Exploiter. Découvrir la topologie, piloter le gestionnaire de sous-réseau, découper la fabric en partitions isolées pour différentes équipes ou différents clients, appliquer micrologiciels et configuration de manière cohérente, et générer des événements et des alarmes.
- Prédire. Apprendre à quoi ressemble la normale pour votre fabric et signaler le câble qui se dégrade, ou le schéma de trafic qui ne correspond pas, avant la panne.
UFM dispose également d'un kit de développement logiciel ouvert, avec des plugins qui envoient ses données vers les outils que votre équipe d'exploitation utilise déjà : Prometheus et Grafana, Elasticsearch via Fluentd, Zabbix, syslog et l'ordonnanceur de tâches Slurm. C'est important, car personne ne veut un écran de plus à surveiller. Nous détaillons les plugins dans l'article technique.
Les trois niveaux d'UFM et quand choisir chacun
NVIDIA propose UFM en trois niveaux principaux. Leurs noms décrivent ce que chacun ajoute :
| Niveau | Ce qu'il ajoute | Idéal lorsque | Points de vigilance |
|---|---|---|---|
| UFM Telemetry | Collecte en temps réel des compteurs de la fabric et des données des câbles, diffusées vers vos propres outils de supervision. Visibilité uniquement. | Clusters plus petits dont le gestionnaire de sous-réseau tourne déjà sur un commutateur, ou équipes qui ont seulement besoin des données de la fabric dans Grafana. | Pas de gestion des partitions, pas de contrôle centralisé de la fabric et pas de paire haute disponibilité. |
| UFM Enterprise | Tout ce que contient Telemetry, plus la gestion complète de la fabric : découverte, vues de topologie, pilotage du gestionnaire de sous-réseau, partitions, événements et alarmes, rapports de santé, API REST, intégration avec l'ordonnanceur et paire HA active/passive. | La plupart des clusters d'IA en production, tout ce qui est partagé entre équipes ou locataires, et tout cluster utilisant Slurm. | Nécessite des serveurs de gestion dédiés (ou l'appliance de NVIDIA), et une personne qui en est responsable. |
| UFM Cyber-AI | Analyses s'appuyant sur l'historique de télémétrie d'Enterprise : apprend le comportement normal de chaque fabric, prédit les liens et câbles défaillants et signale les anomalies de performance ou d'utilisation. | Grandes fabrics comptant des milliers de câbles, où la prédiction des pannes est rentable, et fournisseurs qui vendent de la capacité GPU et doivent repérer les usages abusifs. | Sa valeur croît avec la taille et l'historique de la fabric ; sur un cluster à un seul commutateur, c'est généralement plus que nécessaire. |
Les fonctionnalités exactes, les licences et les options d'appliance changent d'une version d'UFM à l'autre ; nous confirmons donc l'offre en vigueur auprès de NVIDIA pour chaque devis. La logique de décision, elle, est stable : Telemetry si vous avez seulement besoin de voir la fabric, Enterprise si vous devez l'exploiter, Cyber-AI si la fabric est assez grande pour que la prédiction des pannes fasse réellement économiser de l'argent.
Trois clusters, trois réponses
1. Un cluster DGX B300 ou HGX B300 de quatre nœuds
Quatre serveurs à huit GPU, 32 GPU, utilisés par une seule équipe d'IA pour l'affinage et l'inférence. Chaque serveur dispose de huit adaptateurs réseau de 800 Gb/s pour la fabric GPU, soit 32 ports de calcul, qui tiennent sur un seul commutateur InfiniBand.
- Notre recommandation habituelle : faire tourner le gestionnaire de sous-réseau sur le commutateur et utiliser UFM Telemetry pour alimenter en compteurs de fabric le même Grafana qui affiche l'utilisation des GPU. Si le cluster doit grandir ou être partagé par la suite, commencez par UFM Enterprise afin que le partitionnement et l'historique soient déjà en place.
- Résultat pour l'organisation : un seul tableau de bord montre ensemble les GPU et le réseau. Lorsqu'une tâche ralentit, l'équipe peut voir en quelques minutes si un GPU, un serveur ou un port est en cause, au lieu d'ouvrir un dossier de support et d'attendre.
- Exemple : le débit d'une tâche d'affinage baisse d'un cinquième chaque après-midi. Le panneau de la fabric montre une hausse des compteurs de récupération d'erreurs sur un port à mesure que la salle se réchauffe. La cause est un émetteur-récepteur sensible à la température ; il est remplacé sous garantie avant de tomber complètement en panne.
2. Un cluster de 32 nœuds de type SuperPOD
Trente-deux serveurs à huit GPU, 256 GPU, construits selon la conception de référence de NVIDIA avec des rails réseau séparés, des commutateurs leaf et spine et bien plus d'un millier de liens optiques. Plusieurs équipes y entraînent de grands modèles, et certaines tâches utilisent tous les GPU à la fois.
- Notre recommandation habituelle : UFM Enterprise en paire HA, avec des partitions par équipe, le plugin de détection des problèmes activé d'abord en mode simulation (dry-run), et la télémétrie acheminée vers la supervision centrale. Évaluez UFM Cyber-AI une fois que vous disposez de quelques mois d'historique : à cette taille, une poignée de câbles défaillants par trimestre est normale, et les prédire a une vraie valeur.
- Résultat pour l'organisation : les pannes qui se manifestaient auparavant par « la grosse tâche est lente » deviennent un ticket qui indique quel câble, quel rack et quelles tâches l'ont traversé. La maintenance passe de l'urgence à la planification.
- Exemple : un lien entre un leaf et un spine commence à osciller deux fois par heure. L'alerte appelle l'ingénieur d'astreinte en cinq minutes environ, le plugin de détection des problèmes d'UFM isole le port afin que le trafic le contourne, et la tâche de 256 GPU se poursuit avec une bande passante inférieure d'une fraction de pour cent au lieu de se bloquer. Le câble est remplacé le lendemain matin.
3. Un service HPC universitaire avec Slurm
Un cluster de recherche partagé : plusieurs générations de nœuds GPU, un grand parc de nœuds CPU, un système de fichiers parallèle et des centaines d'utilisateurs répartis entre les départements, le tout ordonnancé via Slurm.
- Notre recommandation habituelle : UFM Enterprise avec l'intégration Slurm de NVIDIA, qui peut attribuer à chaque tâche sa propre partition de fabric pendant son exécution, de sorte que les tâches de groupes différents sont isolées sur le réseau comme sur les serveurs. Les métriques GPU sont étiquetées avec l'identifiant de tâche Slurm, ce qui permet de rattacher l'utilisation à une tâche, un utilisateur et un département.
- Résultat pour l'organisation : des rapports équitables et fondés sur des preuves. L'équipe de calcul pour la recherche peut montrer à chaque département ses heures GPU, l'efficacité de leur utilisation et si les tâches lentes relevaient du code ou de l'infrastructure. Les demandes de financement, la refacturation et la planification des capacités s'en trouvent grandement facilitées.
- Exemple : un doctorant signale que sa tâche sur huit nœuds est « toujours lente le mardi ». La vue des tâches montre que ses nœuds partagent un commutateur leaf avec une tâche hebdomadaire d'ingestion de données qui sature ses liaisons montantes. La solution est une contrainte d'ordonnancement, pas du nouveau matériel.
Ce que vous apporte une bonne visibilité de la fabric
- Une meilleure utilisation des GPU, parce que les pannes réseau sont détectées en quelques minutes et non en plusieurs jours, et que les tâches ne restent pas bloquées à cause d'un seul port défectueux.
- Moins d'échecs de longues exécutions, parce que les câbles et émetteurs-récepteurs défaillants sont repérés et remplacés pendant des fenêtres planifiées.
- Des incidents résolus plus vite et plus sereinement, parce que les données GPU, serveurs, réseau et tâches figurent sur une même chronologie, de sorte que la première question (« est-ce le réseau ? ») obtient une réponse étayée.
- Une multilocation propre, parce que les partitions et l'isolement par tâche sont gérés et audités de manière centralisée.
- Des rapports de capacité et de coûts honnêtes, parce que vous pouvez présenter le coût par heure GPU utile, par équipe, plutôt que le coût par GPU installé.
- Des dossiers de garantie et de support plus solides, parce que vous pouvez remettre au fournisseur les compteurs, horodatages et historiques d'une pièce défectueuse plutôt qu'une simple description.
Superviser toute la pile, pas seulement la fabric
UFM couvre la fabric InfiniBand. Un cluster d'IA opérationnel a aussi besoin de visibilité sur les GPU (Data Center GPU Manager de NVIDIA, DCGM), sur les réseaux Ethernet de stockage et de trafic frontal (NVIDIA Spectrum-X et NetQ), sur les unités de traitement de données BlueField si vous les utilisez, sur les serveurs, sur l'ordonnanceur et sur les services d'IA eux-mêmes. Dans notre article précédent sur l'observabilité comme standard d'entreprise, nous soutenions que la supervision doit être un contrat unique à l'échelle de l'entreprise, et non un ensemble de préférences d'équipe. Il en va de même ici : les données de la fabric doivent résider dans le même système que tout le reste, étiquetées de la même manière, afin qu'une seule requête puisse suivre une tâche lente de l'ordonnanceur jusqu'au GPU puis au port du commutateur.
Notre conception standard utilise OpenTelemetry pour tout collecter une seule fois et l'envoyer vers deux types de backend : des métriques compatibles Prometheus avec Grafana (nous utilisons Grafana Mimir pour un stockage à long terme hautement disponible, et Grafana Tempo pour les traces de requêtes), et la pile Elastic (Elasticsearch et Kibana) pour les journaux et les événements, car de nombreuses organisations l'exploitent déjà. Si vous avez déjà standardisé l'un d'eux, nous nous raccordons à ce que vous avez.
Ce que fait Workstation
Nous sommes revendeur et intégrateur britannique d'infrastructures d'IA NVIDIA, et nous assurons l'observabilité gérée pour nos clients. Pour un cluster géré par UFM, cela recouvre trois choses :
- Fourniture. Serveurs GPU (systèmes DGX et HGX B300, entre autres), commutateurs InfiniBand et Ethernet, adaptateurs, câbles et émetteurs-récepteurs, ainsi que les licences UFM au bon niveau, spécifiés ensemble pour que la fabric corresponde aux GPU. Vous pouvez parcourir les systèmes DGX, les équipements réseau et les logiciels NVIDIA dans notre boutique.
- Mise en place. Nous installons UFM (en paire HA lorsque c'est pertinent), configurons les partitions et l'intégration Slurm ou Kubernetes, déployons DCGM et les collecteurs OpenTelemetry, et remettons des tableaux de bord et des règles d'alerte testés sur de vraies pannes : nous débranchons un câble et vous montrons l'alerte arriver.
- Exploitation pour votre compte. Notre service d'observabilité gérée maintient la pile de supervision elle-même saine et hautement disponible, ajuste les alertes pour qu'elles méritent qu'on se lève la nuit, surveille la santé de la fabric et des GPU 24 heures sur 24 et vous envoie chaque mois un rapport sur l'utilisation, les pannes et la capacité. Nous travaillons aux côtés de votre équipe et du support NVIDIA, pas à leur place.
Questions à se poser avant d'acheter
- Qui sera responsable de la fabric au quotidien, et doit-il l'exploiter ou seulement la voir ?
- Le cluster sera-t-il partagé entre équipes, départements ou clients ? Si oui, comment seront-ils isolés sur le réseau ?
- Quel ordonnanceur utilisez-vous, et souhaitez-vous que l'utilisation des GPU et de la fabric soit rapportée par tâche et par équipe ?
- Où les données de supervision doivent-elles être stockées, et pendant combien de temps ? Exploitez-vous déjà Prometheus, Grafana ou Elastic ?
- Combien coûte une heure de votre cluster, et en combien de temps devez-vous savoir qu'elle est gaspillée ?
Partenaire NVIDIA : ingénierie, logiciels et équipes
Workstation est partenaire NVIDIA. Au-delà de la fourniture du matériel, nous apportons l'ingénierie, les logiciels et le personnel nécessaires pour planifier, construire et exploiter des centres de données d'IA : études de site et d'alimentation, conception des racks et de la fabric, installation d'InfiniBand et de Spectrum-X, mise en place d'UFM, DCGM et OpenTelemetry, intégration de Kubernetes et Slurm, et des ingénieurs qui vous accompagnent jusqu'à la remise et au-delà, dans le cadre du support géré. Pour la description de la plateforme par NVIDIA elle-même, consultez la page officielle NVIDIA Unified Fabric Manager (UFM) (s'ouvre dans un nouvel onglet).
Prochaines étapes
Ouvrez la galerie interactive de tableaux de bord pour découvrir les dix-sept vues que nous construisons pour un cluster type, de la santé de la fabric au coût par heure GPU. Ensuite, demandez à notre ingénieur commercial IA de dimensionner un cluster, une fabric et le bon niveau d'UFM pour vos charges de travail, ou parcourez la boutique Workstation pour découvrir les serveurs HGX B300 et les configurations DGX BasePOD. Nous commençons volontiers par une revue d'observabilité d'un cluster que vous possédez déjà.
Les chiffres de cet article sont des exemples illustratifs, et non des mesures provenant d'un client particulier.
Mention des droits : NVIDIA, le logo NVIDIA, DGX, HGX, Quantum, Spectrum, Spectrum-X, BlueField, ConnectX, NVLink, DOCA, DCGM et Unified Fabric Manager (UFM) sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. Les produits et technologies NVIDIA peuvent être couverts par des brevets et d'autres droits de propriété intellectuelle détenus par NVIDIA Corporation, et tous ces droits sont reconnus et réservés à leurs titulaires. Les informations sur les produits sont résumées dans nos propres termes à partir de la documentation publique de NVIDIA ; le site web et la documentation de NVIDIA font foi. Les autres noms de sociétés et de produits, notamment Prometheus, Grafana, Elasticsearch, Kibana, Logstash, OpenTelemetry, Kubernetes et Slurm, peuvent être des marques de leurs propriétaires respectifs. Les tableaux de bord, configurations et textes propres à Workstation sont © Workstation.