Gemini 4 Argon : ce que cela signifie pour votre équipe, et où l'utiliser en premier
Le modèle de pointe de Google pour le codage de longue haleine, le travail intellectuel et la cyberdéfense : ce qui est sorti, ce que cela coûte et les cinq flux de travail par lesquels nous commencerions
 Balinder Walia18 octobre 20267 min read
Gemini 4 Argon de Google est un modèle de pointe conçu pour travailler longtemps sur un seul problème difficile : migrer une base de code, corriger des vulnérabilités ou mener de bout en bout une recherche sur une question financière ou juridique. Voici l'analyse de Workstation : ce qui est sorti, ce que cela coûte, sa place à côté des modèles que vous utilisez déjà, et les flux de travail sur lesquels nous le mettrions en premier. Le code, les schémas et dix flux de travail détaillés figurent dans l'article détaillé.
gemini-4-argon) partage une seule fenêtre de 1M de tokens entre l'entrée, la réflexion et la sortie, là où les modèles Gemini précédents limitaient la sortie à 64K tokens. Il arrive en tête des résultats publiés par Google en ingénierie logicielle de longue haleine (DeepSWE v1.1, 77,9 %), en automatisation métier (AutomationBench, 51,3 %) et en compréhension de longues vidéos (LVBench, 91,7 %), et partage la première place en correction de vulnérabilités (CWE-bench v1, 68 %). Il est désormais disponible sur le niveau payant de l'API Gemini, à 2 $ / 10 $ par million de tokens en entrée / en sortie jusqu'au 30 novembre, puis 4 $ / 20 $. Utilisez-le lorsqu'une seule exécution longue et vérifiable remplace des jours de travail humain. Conservez un modèle rapide pour le volume.
Réécrit pour les lecteurs de Workstation à partir de l'annonce de Google, Gemini 4 Argon: our next era of frontier intelligence (30 sept. 2026), et du guide du développeur AI Studio (13 oct. 2026). Les chiffres des benchmarks sont ceux de Google ; vérifiez les tarifs en vigueur avant d'établir votre budget.
Ce qui est réellement sorti
- 30 septembre : annonce, puis première mise à disposition auprès de spécialistes de la cyberdéfense sélectionnés via le Fairwind Program de Google, pendant le test des mesures de protection.
- 13 octobre : disponible pour les développeurs sur le niveau payant de l'API Gemini (Google AI Studio, Android Studio), pour les abonnés Google AI Ultra et dans Google Antigravity, la plateforme de développement orientée agents de Google.
- Une seule fenêtre pour tout : l'entrée, la réflexion et la sortie partagent 1M de tokens. La sortie est par défaut de 64K. Au-delà, vous exécutez la requête en arrière-plan (« long decode ») et le modèle peut renvoyer en une seule passe des diffs complets sur plusieurs fichiers, des suites de tests ou des démonstrations.
- Trois niveaux de réflexion :
lowpour le routage et l'extraction,medium(par défaut) pour le codage courant et l'utilisation d'outils,highpour le débogage des causes profondes, les correctifs de sécurité et l'architecture.
Les chiffres publiés par Google
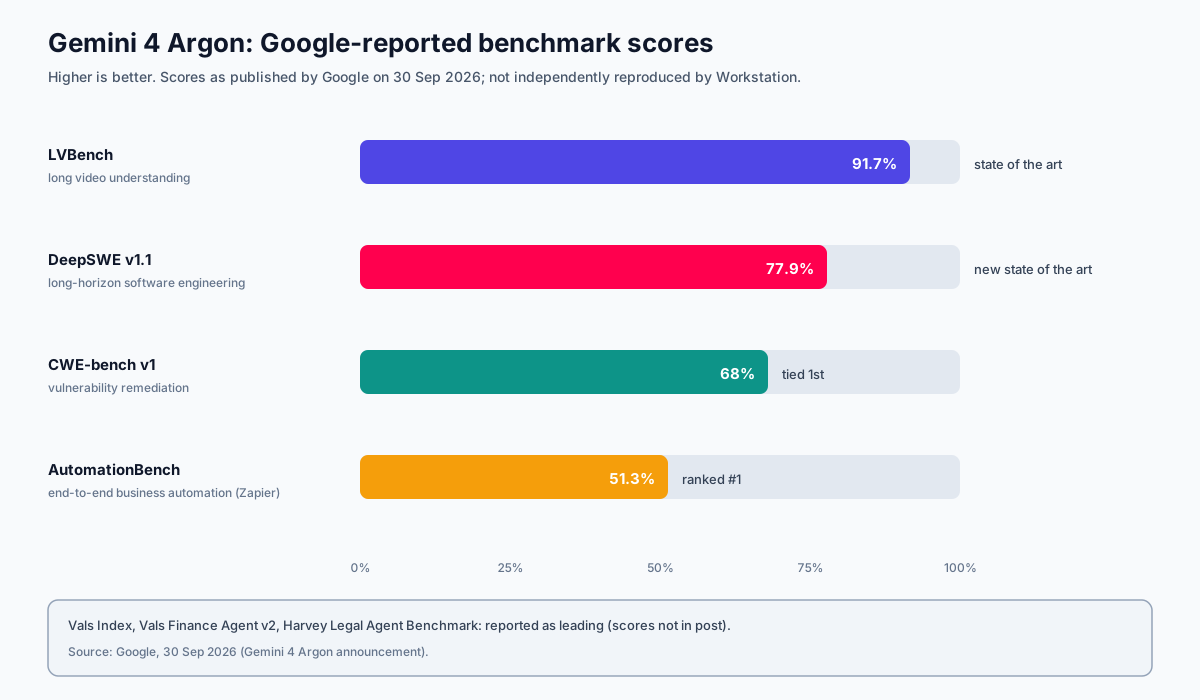
Les benchmarks ne disent pas tout. Les résultats internes sont plus utiles, car ils décrivent un travail pour lequel une entreprise paierait :
- Mémoire : une équipe d'agents Argon a analysé des données de profilage de l'ensemble du parc et appliqué des optimisations qui ont libéré plus de 300 Tio de mémoire dans les centres de données de Google, avec 500 Tio à 1 Pio attendus au total.
- Migrations : des agents Argon portent du C et du C++ vers Rust dans tout Google, des bibliothèques de quelques dizaines de milliers de lignes jusqu'au noyau Fuchsia Zircon de plus de 800K lignes. Chaque portage passe par un audit automatisé et manuel, des tests en émulation et une revue avant la mise en production.
- Performances : sur libgav1, le décodeur vidéo open source de Google, Argon a remplacé 32K lignes de SIMD écrites à la main par du Rust sûr que le compilateur vectorise lui-même. Le résultat est 2,7 fois plus rapide que le portage Rust précédent, avec une sortie identique.
- Recherche : sur une sous-routine d'informatique quantique, il a battu de 40 % la référence publiée en matière de ressources, en quelques minutes.
Pourquoi les chefs d'entreprise devraient s'y intéresser
- Le travail en souffrance qui n'est jamais pourvu en personnel. Les migrations de systèmes hérités, les mises à niveau de dépendances, les nettoyages de performances et la dette de sécurité sont longs, mesurables et fastidieux : exactement le type de tâche pour lequel Argon a été entraîné.
- Le travail intellectuel sur tous les formats. Il lit ensemble des PDF, des tableurs, des grands livres, des dépôts réglementaires et de longues vidéos, et les transforme en rapport, en version annotée ou en tableau de bord. Google indique qu'il arrive en tête de Vals Finance Agent v2 et du benchmark d'agent juridique de Harvey.
- Des exécutions répétées moins chères. Les entrées en cache bénéficient d'une remise de 95 %, et la mise en cache est automatique. Les agents qui relisent la même base de code ou le même ensemble de politiques à chaque tour deviennent beaucoup moins chers.
- La défense, pas seulement la vitesse. Il trouve, valide et corrige des vulnérabilités. Wiz l'a utilisé pour découvrir une exposition critique dans un logiciel hospitalier que les modèles précédents avaient manquée.
Pourquoi les développeurs devraient s'y intéresser
- Donnez-lui un objectif et un test, puis prenez du recul. Argon donne le meilleur de lui-même lorsqu'il peut se vérifier par rapport à un signal réel : votre suite de tests, un script de benchmark, des captures d'écran du navigateur, des journaux d'exécution.
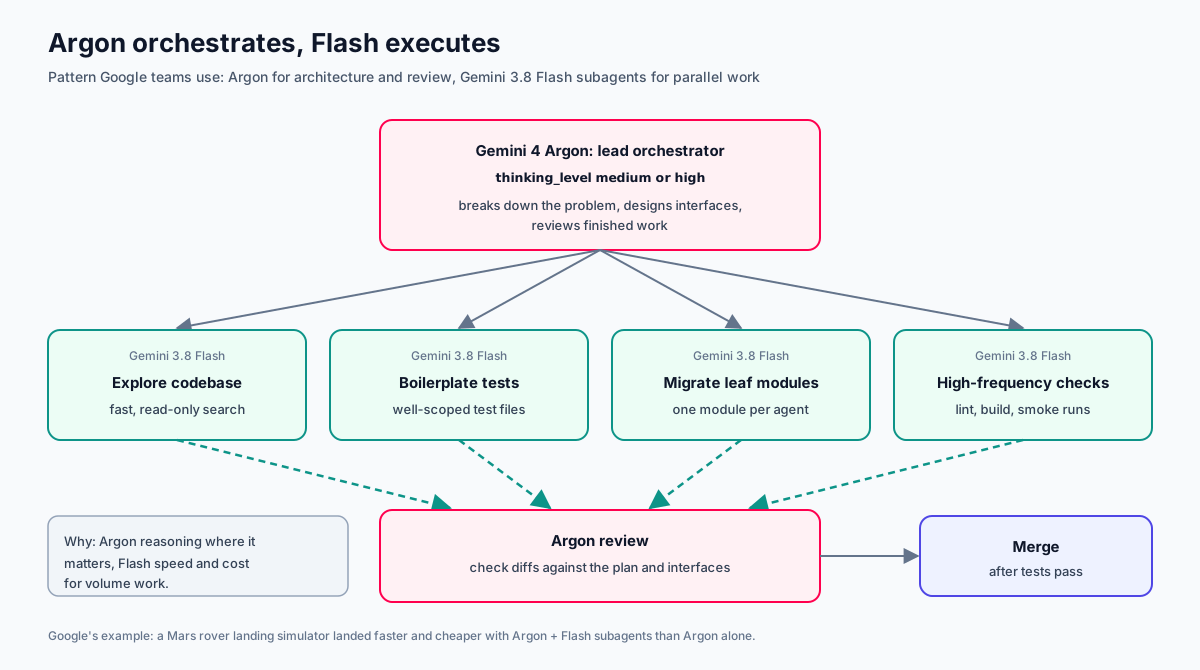
- Utilisez-le comme chef de file, pas comme toute l'équipe. Les propres ingénieurs de Google associent Argon (planification, interfaces, revue) à des sous-agents rapides Gemini 3.8 Flash pour le travail parallèle et bien délimité. C'est plus rapide et moins cher qu'Argon seul.
- Nettoyage de migration. Remplacez
thinking_budgetparthinking_level, supprimeztemperature/top_p/top_k(ignorés), retirez les caches de contexte explicites, et portez les délais d'expiration des clients à 15–20 minutes ou exécutez en arrière-plan.
Cinq flux de travail par lesquels nous commencerions
| Flux de travail | Pourquoi Argon | Le contrôle qui le garde honnête |
|---|---|---|
| Migration de modules hérités | Garde tout un sous-système en contexte et itère pendant des heures | Tests différentiels : l'ancien et le nouveau code produisent une sortie identique |
| Backlog de vulnérabilités | Trouve, prouve et corrige en une seule boucle | Preuve de concept dans un bac à sable, puis revue de sécurité humaine |
| Optimisation des coûts cloud et de la mémoire | Lit des mois de métriques et les transforme en changements concrets | Déploiement progressif avec retour arrière automatique en cas de violation de SLO |
| Dossier financier de fin de mois | Recoupe grands livres, PDF et tableurs | Chaque chiffre cite sa cellule source ; les totaux concordent |
| Post-mortem d'incident | Visionne l'enregistrement de l'appel et lit les tableaux de bord en même temps | La chronologie correspond aux journaux à la minute près ; le responsable valide |
Les dix flux de travail, avec les invites, le code et le YAML de pipeline, se trouvent dans l'article détaillé.
Ce que cela coûte, en chiffres simples
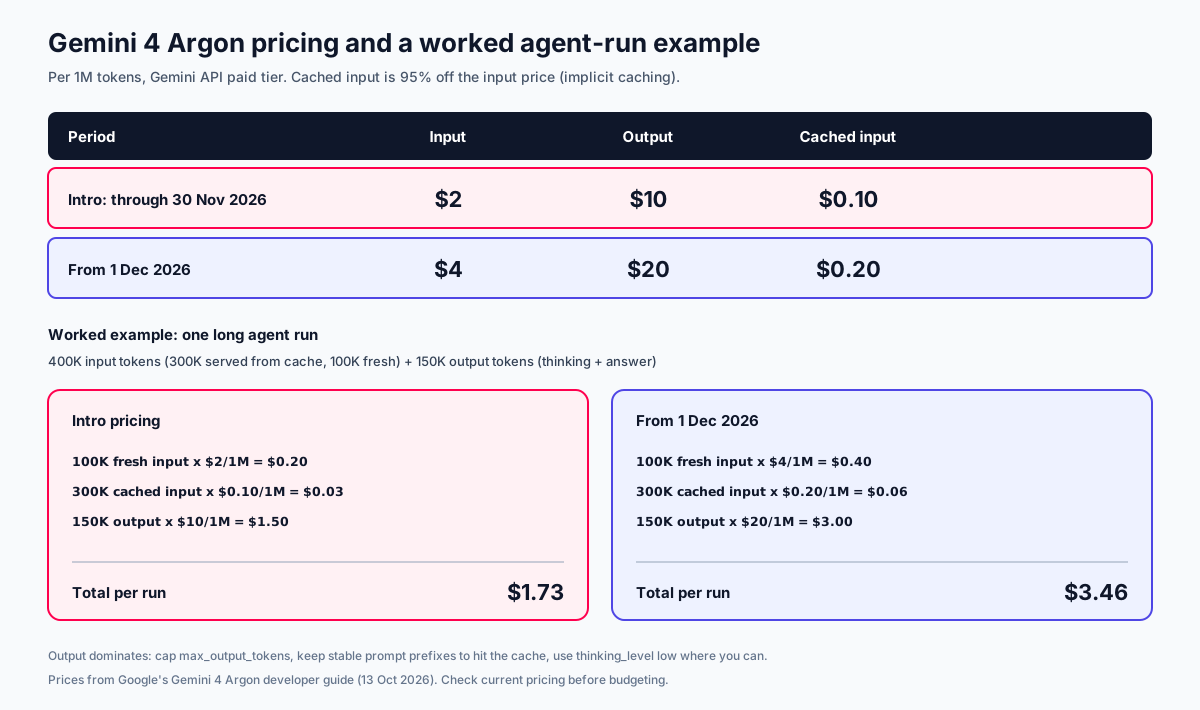
Une exécution d'agent longue typique, qui lit 400K tokens (dont 300K en cache depuis les tours précédents) et en écrit 150K, coûte environ 1,73 $ au prix de lancement et 3,46 $ à partir du 1er décembre. C'est la sortie qui coûte cher ; plafonnez donc max_output_tokens sur chaque exécution en arrière-plan et réservez le travail en volume à un modèle moins cher.
Sécurité : ce que Google a fait, et ce qui reste de votre ressort
Google soumet Argon à quatre mesures de protection : refuser les usages malveillants (cyber et NRBC) tout en autorisant la recherche légitime à double usage, résister à l'injection d'invites (il arrive en tête du benchmark d'injection indirecte d'invites de Gray Swan), surveiller sa chaîne de pensée et ses actions pour détecter tout désalignement, et l'exécuter dans des bacs à sable scellés pendant les tests à haut risque. Rien de tout cela ne remplace vos propres contrôles. Donnez aux agents des clés au moindre privilège, séparez le contenu non fiable des instructions, isolez dans un bac à sable tout ce qui exécute du code, et exigez qu'un humain approuve tout ce qui est irréversible. Notre guide de sécurité des agents et les barrières QA de Ring Promoter montrent comment nous procédons en pratique.
Le point de vue de Workstation
- Router, pas remplacer. Argon est le chef de file pour les tâches longues et vérifiables. Les modèles rapides gèrent le chat, la classification et les tâches élémentaires. Consultez notre guide du routeur de modèles ; le même raisonnement s'applique à tous les fournisseurs.
- Mesurer avant de faire confiance. Exécutez-le sur votre propre dépôt et vos propres documents avec un score de référence, pas un classement.
- Livrer en passant par des barrières. La production des agents suit le chemin int → test → acc → prod comme tout autre changement.
Besoin d'aide pour piloter Argon sur un véritable backlog ? Parlez à Workstation. Nous choisirons un flux de travail mesurable, construirons le harnais de vérification et l'exécuterons à travers vos barrières de mise en production habituelles.