NVIDIA Minerva für KI-Fabriken: Aus Alarmstürmen werden zurückgewonnene GPU-Stunden
Was Minerva leistet, welches Nutzungsmodell zu wem passt, drei durchgerechnete Beispiele und wie Workstation es liefert, integriert und betreut
 Balinder Walia9. November 202611 min read
Eine KI-Fabrik verdient ihr Geld in GPU-Stunden und Tokens, und sie verliert sie unbemerkt: ein nachhinkender Knoten, eine nachlassende Optik, ein Sturm von Alarmen, die niemand rechtzeitig lesen kann. Dieser Beitrag richtet sich an CTOs, Betreiber von KI-Fabriken und Neoclouds sowie Leitungen von Forschungsrechenzentren. Er erklärt verständlich, was NVIDIA Minerva ist, was es dem Unternehmen wert ist, welches seiner drei Nutzungsmodelle zu welcher Organisation passt, wie es sich zu NVIDIA UFM verhält und wie Workstation es liefert, einrichtet, integriert und betreut. Ingenieure, die die Architektur, die Integrationskonfiguration und das Rollout-Runbook suchen, sollten den technischen Artikel lesen.
Interaktive Version: Öffnen Sie siebzehn Beispiel-Dashboards für ein Minerva-Deployment, von der Ausbeute der KI-Fabrik bis zum Zustand der Collector, jeweils mit den zugrunde liegenden Signalen und Alarmhinweisen.

Was NVIDIA Minerva ist, einfach erklärt
NVIDIA hat Minerva im Oktober 2026 angekündigt und beschreibt es auf seiner offiziellen NVIDIA-Minerva-Seite als zentrales Observability-Produkt für seine KI-Fabriken, einschließlich Systemen auf Basis der Plattformen Vera Rubin und Blackwell. Ohne Fachjargon leistet es fünf Dinge:
- Erfasst alles einmal. GPU-Zustand, die NVLink-Switches, die GPUs innerhalb eines Racks verbinden, Spectrum-X-Ethernet-Switches und SuperNICs, die Racks miteinander verbinden, DPUs, NCCL (die Bibliothek, mit der GPUs Ergebnisse austauschen), die Job-Scheduler wie Slurm und NVIDIA Run:ai, Storage sowie die KI-Workloads selbst. Die Daten kommen über offene Standards herein: OpenTelemetry, gNMI-Streaming von Switches, Syslog, DCGM für GPUs, Slurm-Daten und einfaches JSON.
- Führt eine Live-Karte. Ein Wissensgraph hält fest, welche GPU in welchem Knoten sitzt, welcher Port mit welchem Switch verbunden ist und welcher Job wo läuft, und er aktualisiert sich, wenn Jobs kommen und gehen.
- Lernt den Normalzustand und erkennt Auffälligkeiten. Maschinelles Lernen erstellt für jedes Signal eine Baseline und markiert die Abweichung, die einem Ausfall üblicherweise vorausgeht.
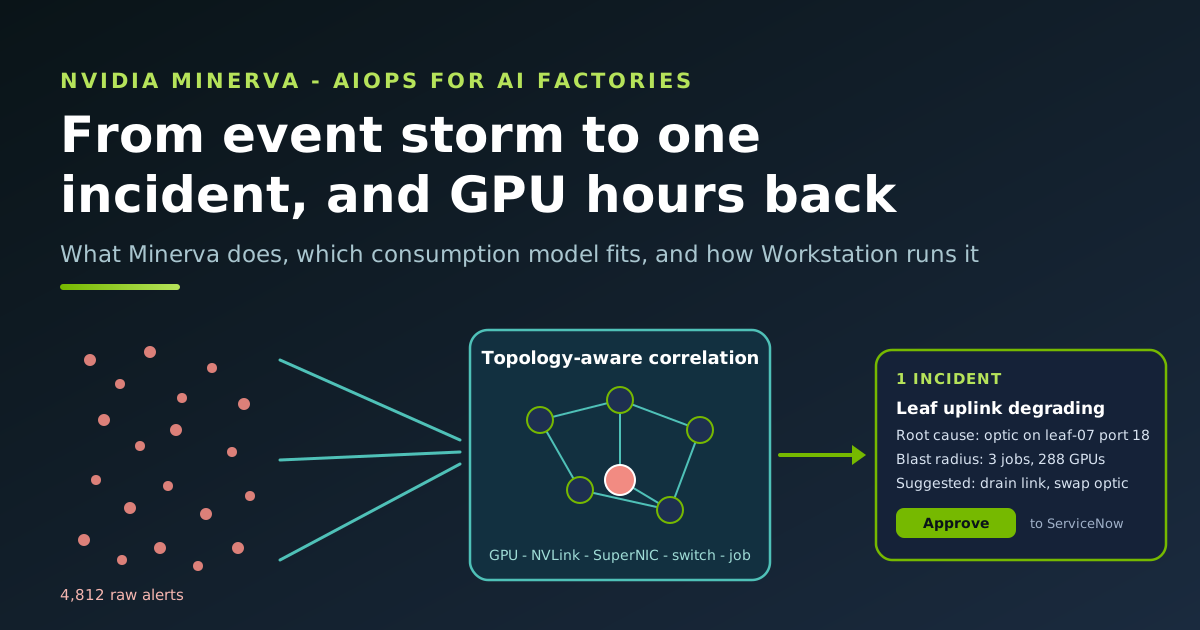
- Erklärt, statt nur zu alarmieren. Wenn etwas schiefgeht, durchläuft es die Karte, um die gemeinsame Ursache hinter den Symptomen zu finden, ermittelt, welche Jobs und GPUs betroffen sind, und sendet einen einzigen Vorfall an Slack, Microsoft Teams, PagerDuty oder ServiceNow.
- Antwortet. Ein Assistent namens Sherlock ermöglicht es Operatoren, Fragen in natürlicher Sprache an die Live-Telemetrie zu stellen, und ein MCP-Server (Model Context Protocol) lässt Ihre eigenen KI-Agenten Minerva abfragen. Wo Sie es zulassen, können empfohlene Korrekturen automatisch ausgeführt werden, zum Beispiel über Ansible.
Es kann in Ihrem Rechenzentrum oder als von NVIDIA gehosteter Dienst laufen, und laut NVIDIA skaliert es auf Hunderttausende von GPUs. Der Minerva Collector ist zudem Teil von NVIDIA DSX OS, wodurch sich dieselbe Sicht von der GPU bis zur Stromversorgung und Kühlung des Gebäudes erstreckt.
Warum es für das Unternehmen wichtig ist
Eine KI-Fabrik ist eine sehr teure Maschine, deren Output Tokens und trainierte Modelle sind. Alles, was sie anhält, verlangsamt oder schwer reparierbar macht, schlägt sich direkt in den Kosten pro Token nieder. NVIDIA beschreibt den Wert von Minerva in denselben Größen, über die Betreiber bereits berichten, und wir tun das auch:
- Zurückgewonnene GPU-Stunden. Fehler, die Jobs unbemerkt verlangsamen, etwa ein einzelner nachhinkender Knoten, der bei jedem Synchronisationsschritt Tausende von GPUs aufhält, werden in Minuten statt Tagen gefunden.
- Höherer Goodput. Goodput ist der Anteil der GPU-Zeit, der nützliche Arbeit leistet, nachdem Neustarts, Wiederholungsläufe und Wartezeiten abgezogen sind. Diese Zahl zählt, nicht die rohe Auslastung.
- Weniger Unterbrechungen (höhere MTBI). Die mittlere Zeit zwischen Unterbrechungen steigt, wenn ausfallende Teile früh erkannt und in einem geplanten Wartungsfenster getauscht werden statt mitten im Lauf.
- Schnellere Reparatur (niedrigere MTTR). Die mittlere Reparaturzeit sinkt, wenn bereits die erste Meldung die wahrscheinliche Ursache und den Auswirkungsbereich nennt.
- Ruhigere Rufbereitschaft. Ein Vorfall statt Tausender Alarme bedeutet, dass Menschen auf das Richtige reagieren und im Job bleiben.
- Mehr Tokens. Bei Inferenz ist jede Stunde mit verringertem Durchsatz verlorener Output und für einen Anbieter verlorener Umsatz.
- Datensouveränität. Eine On-Premises-Bereitstellung hält Telemetrie, Topologie und Job-Metadaten in Ihrer eigenen Umgebung, was für den öffentlichen Sektor, die Forschung und regulierte Kunden in Großbritannien wichtig ist.
Drei Nutzungsmodelle und für wen sie jeweils passen
NVIDIA bietet Minerva auf drei Arten an, von Do-it-yourself bis vollständig schlüsselfertig. Wir helfen Kunden bei der Wahl, indem wir fragen, was sie bereits betreiben und wie viel der Analyse sie selbst verantworten möchten.
| Modell | Was Sie erhalten | Geeignet für | Zu bedenken |
|---|---|---|---|
| DIY Observability | Minerva als Collector für die Telemetrie der KI-Fabrik, der Ihre eigenen Observability-Tools wie Grafana speist. | Teams mit ausgereifter Prometheus- und Grafana-Praxis, die eine an NVIDIA ausgerichtete Datenerfassung wünschen, ohne ihre Tools zu wechseln. | Dashboards, Alarme und Korrelation bauen und pflegen Sie selbst. |
| AIOps mit DIY Observability | Der Collector plus das maschinelle Lernen, die Anomalieerkennung und die Korrelation von Minerva, wobei die Erkenntnisse in Ihre bestehenden Tools und Agenten zurückfließen. | Unternehmen mit etabliertem Grafana-, ServiceNow- oder PagerDuty-Stack, die weniger und bessere Alarme ohne neue Konsole wünschen. | Integration und Alarm-Routing erfordern sorgfältiges Design, damit Vorfälle genau einmal in der richtigen Warteschlange landen. |
| Turnkey | Die vollständige Plattform: Erfassung, Erkenntnisse, der Sherlock-Assistent sowie die eigenen Dashboards und die Benutzeroberfläche von Minerva. | KI-Fabriken und Neoclouds, die vom ersten Tag an eine einheitliche Betriebssicht wünschen, die an den Referenzarchitekturen von NVIDIA ausgerichtet ist. | Entscheiden Sie früh, wie es neben einem bereits vorhandenen Monitoring für Nicht-GPU-Systeme bestehen soll. |
Lizenzierung, Editionen und Supportbedingungen kommen von NVIDIA und können sich ändern, daher bestätigen wir sie für jedes Angebot. Die Wahl ist auch nicht endgültig: Viele Kunden beginnen mit dem Collector und ergänzen AIOps, sobald sie den Daten vertrauen.
Drei Beispiele
Die folgenden Zahlen sind illustrativ und durchgerechnet, um die Struktur des Business Case zu zeigen. Ihre Kosten pro GPU-Stunde, Ihr Job-Mix und Ihre Ausfallraten werden abweichen.
1. Eine Neocloud mit rund tausend Vera-Rubin-GPUs
Vierzehn Vera-Rubin-NVL72-Racks, 1.008 GPUs, auf einem Spectrum-X-Ethernet-Fabric, an Kunden für große Trainingsläufe und Inferenz vermietet. Bei illustrativen Vollkosten von £6 pro GPU-Stunde entspricht die Umgebung rund 8,8 Millionen GPU-Stunden pro Jahr, sodass jedes 1 % verlorener Goodput rund £530.000 kostet.
- Unsere übliche Empfehlung: Turnkey-Minerva on premises, mit dem Collector als Teil von DSX OS, sodass Stromversorgung und Kühlung der Anlage auf derselben Zeitachse liegen wie die GPUs, und Vorfälle an das ServiceNow des Anbieters geleitet werden.
- Wo das Geld liegt: Angenommen, der Trainingsjob eines Mieters erstreckt sich über acht Racks (576 GPUs) und jede Unterbrechung kostet etwa 50 Minuten Arbeit und Neustartzeit, also rund 480 GPU-Stunden. Der Übergang von einer Unterbrechung alle zwei Tage zu einer alle drei Tage vermeidet etwa 60 Unterbrechungen pro Jahr, rund 29.000 GPU-Stunden oder £175.000 allein für diese Job-Klasse.
- Beispiel: Ein Knoten mit einer langsam nachlassenden NVLink-Verbindung wird zum Nachzügler. Ohne Korrelation läuft der Job einfach 15 % langsamer, und der Kunde beschwert sich Tage später. Mit Korrelation wird der Nachzügler innerhalb von Minuten benannt, der Job beim nächsten Checkpoint vom Knoten verlagert und der Tray in einem geplanten Wartungsfenster gewartet.
2. Eine Universität mit einem Blackwell-Cluster aus 256 GPUs
Zweiunddreißig HGX-B300-Server, 256 GPUs, von Forschungsgruppen über Slurm gemeinsam genutzt und von einem kleinen zentralen Team betrieben, das für alles andere bereits Grafana nutzt. Bei £2,50 pro GPU-Stunde entspricht 1 % des Cluster-Jahres rund 22.400 GPU-Stunden oder £56.000.
- Unsere übliche Empfehlung: Beginnen Sie mit DIY Observability und senden Sie die von Minerva erfassten Daten in das vorhandene Grafana des Teams, wobei GPU- und Job-Daten nach Slurm-Job gekennzeichnet werden, sodass jede Abteilung ihre eigene Nutzung sieht. Wechseln Sie zu AIOps mit DIY Observability, sobald das Team eine automatisierte Ursachenanalyse fehlgeschlagener Jobs wünscht.
- Geschäftliches Ergebnis: belegbare Antworten auf die zwei Fragen, die jeder Forschungsrechendienst gestellt bekommt: „Warum ist mein Job fehlgeschlagen?“ und „Wer hat die GPUs genutzt?“. Das unterstützt interne Leistungsverrechnung, Förderanträge und faires Scheduling.
- Ein Hinweis zum Fabric: Wenn das GPU-Netzwerk des Clusters InfiniBand statt Spectrum-X Ethernet ist, bleibt NVIDIA UFM das Werkzeug, das dieses Fabric betreibt und überwacht; siehe unseren Beitrag zu UFM. Wir klären mit NVIDIA, wie Minerva- und UFM-Daten für das von Ihnen erworbene Release zusammengeführt werden.
3. Ein Unternehmen, in dem Grafana, ServiceNow und PagerDuty bereits im Einsatz sind
Ein Finanzdienstleister betreibt 128 Blackwell-GPUs (sechzehn HGX-B300-Server) für interne Inferenz, rund 2 Milliarden Tokens pro Tag. Sein Betriebsteam arbeitet bereits in Grafana, ServiceNow und PagerDuty und möchte keine weitere Konsole.
- Unsere übliche Empfehlung: AIOps mit DIY Observability, on premises für Datensouveränität. Die korrelierten Vorfälle von Minerva erzeugen ServiceNow-Tickets und PagerDuty-Benachrichtigungen; seine Erkenntnisse erscheinen im vorhandenen Grafana; Sherlock und der MCP-Server werden für das Plattformteam nur lesend aktiviert.
- Geschäftliches Ergebnis (illustrativ): Aus rund 3.000 rohen Alarmen pro Woche werden einige Dutzend Vorfälle, und die Benachrichtigungen an den Bereitschaftsingenieur sinken von über hundert pro Woche auf rund fünfzehn. Die typische Reparaturzeit sinkt von etwa drei Stunden auf unter eine Stunde, weil das Ticket die Ursache bereits benennt.
- Auswirkung auf Tokens: Eine vierstündige Verlangsamung, die den Durchsatz um 30 % senkt, kostet rund 100 Millionen Tokens Output. Wird sie stattdessen in 30 Minuten erkannt, bleibt der Großteil davon erhalten.
Minerva und UFM: Was macht was?
Unser früherer Beitrag zu NVIDIA UFM behandelte den Unified Fabric Manager, die Software von NVIDIA zum Betrieb und zur Überwachung von InfiniBand-Fabrics: Subnetzverwaltung, Partitionen, Fabric-Telemetrie und Ausfallvorhersage. Minerva hat einen anderen Umfang:
- UFM ist ein Fabric-Manager. Er konfiguriert und betreibt ein InfiniBand-Netzwerk und berichtet über dessen Zustand.
- Minerva ist eine AIOps-Plattform für die gesamte KI-Fabrik. Laut der Beschreibung von NVIDIA umfasst sie Compute, NVLink Scale-up, Spectrum-X Ethernet Scale-out und Scale-across, Scheduler, Storage und Workloads, und ihre Aufgabe ist die Korrelation und Diagnose über all diese Bereiche hinweg, nicht der Betrieb des Netzwerks.
Ein InfiniBand-Cluster benötigt also weiterhin einen Subnet-Manager wie UFM, und eine Spectrum-X-KI-Fabrik erhält ihre Netzwerk-Observability von Minerva. Wo ein Standort beides hat, entwerfen wir ein gemeinsames Kennzeichnungsschema und einen gemeinsamen Vorfallsablauf, damit die beiden niemanden doppelt alarmieren.
Was Workstation tut
Wir sind ein britischer Reseller und Integrator für NVIDIA-KI-Infrastruktur. Für Minerva bedeutet das:
- Lieferung. Die Minerva-Lizenz im richtigen Modell, zusammen mit den Systemen, die sie überwacht: Vera-Rubin-NVL72-Racks, DGX- und HGX-Systeme, Spectrum-X Ethernet, SuperNICs und BlueField-DPUs.
- Einrichtung und Integration. Wir stellen die Collector bereit und, wo nötig, eine OpenTelemetry-Schicht für Ihre bestehenden Quellen; verbinden Minerva mit Slack oder Teams, PagerDuty und ServiceNow; speisen Grafana; konfigurieren Slurm- oder Run:ai-Metadaten; und führen eine Baselining-Phase durch, bevor irgendjemand alarmiert wird.
- Automatisierung sicher machen. Der Zugriff auf Sherlock und MCP beginnt nur lesend. Korrekturen laufen über freigegebene Ansible-Playbooks mit Change-Records, und wir weisen dies vor der Übergabe mit Fehlerübungen nach.
- Support und Betrieb. Unsere Ingenieure betreuen Minerva und die umgebenden Softwaredienste im Tagesgeschäft, optimieren die Rauschunterdrückung, halten die Collector-Schicht gesund und hochverfügbar und berichten monatlich über GPU-Stunden, Goodput, MTBI und MTTR. Wir arbeiten Hand in Hand mit Ihrem Team und dem NVIDIA-Support.
Fragen, die Sie vor dem Kauf stellen sollten
- Was kostet eine Stunde Ihrer KI-Fabrik, und wie viel Goodput verlieren Sie Ihrer Einschätzung nach heute?
- In welchen Tools arbeitet Ihr Betriebsteam bereits, und soll Minerva diese speisen oder ersetzen?
- Müssen Telemetrie und Job-Metadaten on premises bleiben, und wer darf sie einsehen?
- Wie viel Automatisierung lässt Ihr Change-Prozess zu, und wer gibt sie frei?
- Ist Ihr GPU-Fabric Spectrum-X Ethernet, InfiniBand oder beides?
NVIDIA-Partner: Engineering, Software und Menschen
Workstation ist NVIDIA-Partner. Über die Lieferung der Hardware hinaus stellen wir das Engineering, die Software und das Personal bereit, um KI-Rechenzentren zu planen, zu bauen und zu betreiben: Standort- und Stromversorgungsanalysen, Rack- und Fabric-Design, Installation von Spectrum-X, NVLink und InfiniBand, Einrichtung von Minerva, UFM, DCGM und OpenTelemetry, Onboarding von Kubernetes, Run:ai und Slurm sowie Ingenieure, die Sie über die Übergabe hinaus bis in den Managed Support begleiten. Die Produktbeschreibung von NVIDIA selbst finden Sie auf der offiziellen Seite NVIDIA Minerva und im Minerva-Datenblatt (beide öffnen sich in einem neuen Tab).
Nächste Schritte
Öffnen Sie die interaktive Dashboard-Galerie, um die siebzehn Ansichten zu sehen, die wir rund um ein Minerva-Deployment einrichten. Sehen Sie sich dann NVIDIA Minerva in unserem Shop an, oder fragen Sie unseren KI-Vertriebsingenieur, um das Deployment, das Nutzungsmodell und die umgebenden Systeme zu dimensionieren. Gern beginnen wir mit einem Observability-Review eines KI-Clusters, den Sie bereits betreiben.
Die Zahlen in diesem Beitrag sind illustrative Beispiele, keine Messungen bei einem bestimmten Kunden.
Hinweis zu Schutzrechten: NVIDIA, das NVIDIA-Logo, Minerva, Sherlock (als Name des Assistenten von NVIDIA), DSX, DSX OS, DGX, HGX, Vera Rubin, Blackwell, Spectrum, Spectrum-X, NVLink, ConnectX, SuperNIC, BlueField, DCGM, NCCL, Run:ai und Unified Fabric Manager (UFM) sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den Vereinigten Staaten und anderen Ländern. NVIDIA-Produkte und -Technologien können durch Patente und andere geistige Eigentumsrechte der NVIDIA Corporation geschützt sein, und alle diese Rechte werden anerkannt und bleiben ihren Inhabern vorbehalten. Produktinformationen sind in unseren eigenen Worten aus öffentlichem Material von NVIDIA zusammengefasst; maßgebliche Quelle sind die Website und die Dokumentation von NVIDIA. Andere Firmen- und Produktnamen, darunter Grafana, Prometheus, Slack, Microsoft Teams, PagerDuty, ServiceNow, Ansible, OpenTelemetry, Slurm und Kubernetes, können Marken ihrer jeweiligen Inhaber sein. Die eigenen Dashboards, Konfigurationen und Texte von Workstation sind © Workstation.