KI-Wissensdatenbank · KI-Cloud-Plattformen · Hyperscaler
Amazon Web Services
Amazon Bedrock, SageMaker AI und das breiteste Angebot an GPUs und eigenen Chips.
Am besten geeignet für: Unternehmen, die verwalteten Zugriff auf viele Foundation Models, starke Governance und die Option wünschen, eigene Modelle zu trainieren und zu hosten.
KI-Dienste
- Amazon Bedrock: eine API für Foundation Models von Anthropic (Claude), Meta (Llama), Mistral, Cohere, Amazon Nova und anderen, mit Knowledge Bases für RAG, Guardrails, Batch-Inferenz und Modellbewertung.
- Bedrock AgentCore: verwaltete Runtime, Memory, Gateway, Identität und Observability für produktive Agenten, die mit jedem Framework gebaut wurden.
- Amazon SageMaker AI: Training, Fine-Tuning und Hosting, mit SageMaker HyperPod für ausfallsichere Trainingscluster im großen Maßstab.
- Amazon Q für Entwickler und Geschäftsanwender.
GPUs und Beschleuniger
- EC2 P5 (H100), P5e/P5en (H200), P6 (Blackwell) und GB200 UltraServers.
- AWS-Trainium- und Inferentia-Instanzen für kostengünstigeres Training und Inferenz.
- EKS mit Karpenter für GPU-Autoscaling; Capacity Blocks für reservierte GPU-Zeit.
Agenten und Identität
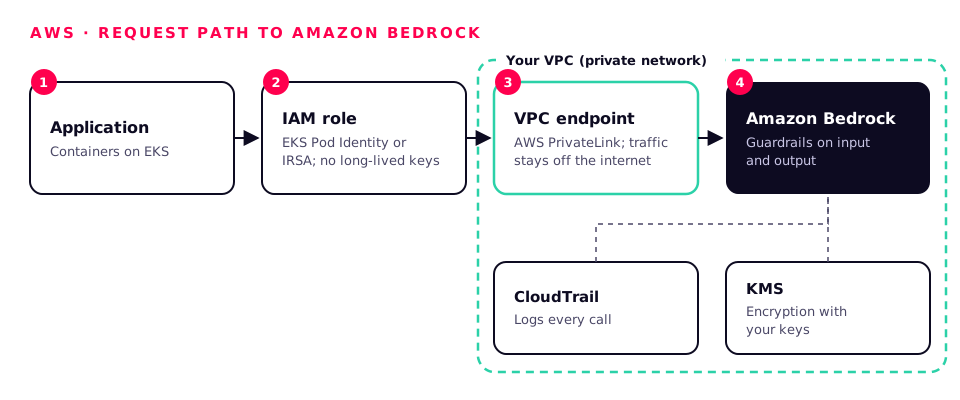
- AgentCore Identity für Agenten-Anmeldedaten und OAuth zu Drittanbieter-Tools; IAM-Rollen für jeden Workload.
- EKS Pod Identity oder IRSA, damit Container nie langlebige Schlüssel halten.
Sicherheit und Daten
- Bedrock verwendet Ihre Prompts oder Ausgaben nicht zum Training von Basismodellen.
- PrivateLink (VPC-Endpunkte) hält den Modellverkehr vom Internet fern; KMS-Verschlüsselung; CloudTrail protokolliert jeden Aufruf.
- Guardrails für Inhaltsfilterung, gesperrte Themen, Schwärzung personenbezogener Daten und Grounding-Prüfungen.
Skalierung und Optimierung
- Regionsübergreifende Inferenzprofile zum Abfangen von Lastspitzen; Provisioned Throughput für garantierte Kapazität.
- Prompt-Caching, Batch-Inferenz und intelligentes Prompt-Routing senken die Kosten pro Anfrage.
UK- und EU-Regionen
London (eu-west-2) und EU-Regionen; prüfen Sie die Modellverfügbarkeit pro Region.
Worauf Sie achten sollten
Kontingente pro Modell (Tokens und Anfragen pro Minute) müssen lange vor dem Launch erhöht werden.
Wie Workstation hilft: Wir entwerfen Bedrock-Architekturen, modellieren und erhöhen Kontingente, bauen Agenten auf AgentCore und verbinden AWS mit Ihren On-Premises-GPUs.
KI im großen Maßstab skalieren mit Amazon Bedrock →CI/CD für LLMs, Agenten und Daten in der Cloud →LLM- und Agenten-APIs absichern →Der KI-Agenten-Harness →Identität und Authentifizierung für KI →
Weitere Anbieter, mit denen wir arbeiten
Logos sind Marken ihrer jeweiligen Inhaber, werden nur zur Kennzeichnung der jeweiligen Plattform verwendet und stammen von Wikimedia Commons. Diagramme vom Workstation-Team.