NVIDIA UFM für KI-Cluster: Warum die Sichtbarkeit des InfiniBand-Fabrics bestimmt, was Ihre GPUs wert sind
Die drei UFM-Stufen, drei reale Cluster-Formen und wie Workstation das Monitoring liefert, einrichtet und betreibt
 Balinder Walia9. November 202612 min read
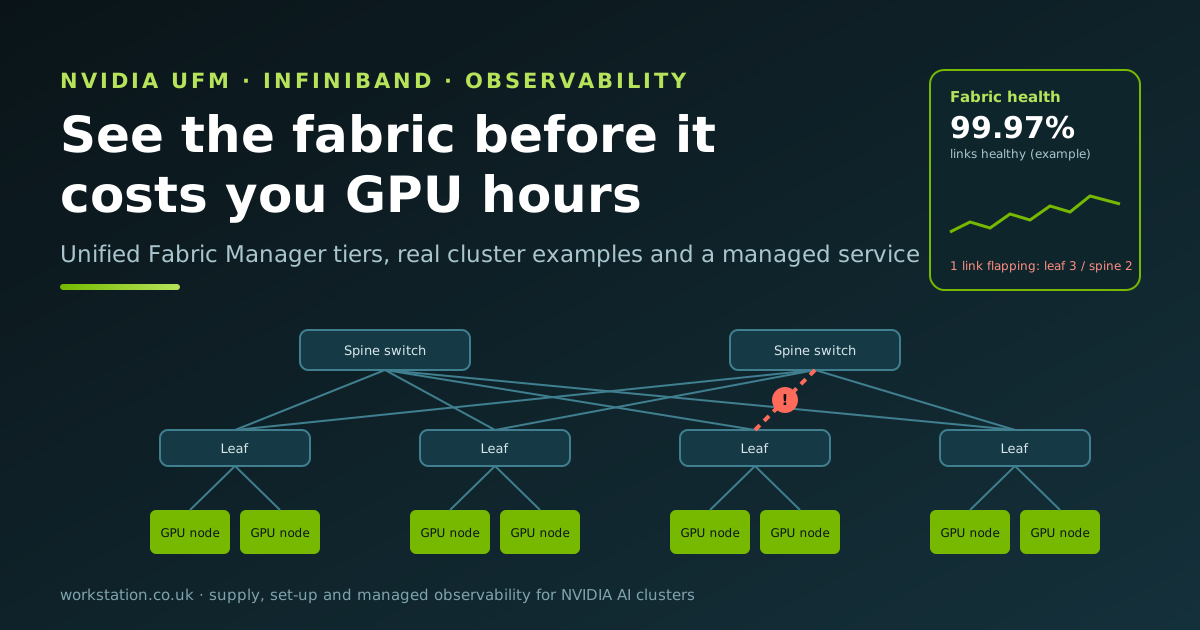
Die GPUs bekommen die Aufmerksamkeit und das Budget. Das Netzwerk, das sie verbindet, entscheidet, wie viel von diesem Budget zu nützlicher Arbeit wird. Dieser Beitrag richtet sich an IT-Leitungen, CTOs und Leitungen von Forschungsrechenzentren, die einen NVIDIA-InfiniBand-Cluster betreiben oder anschaffen. Er erklärt verständlich, was NVIDIA Unified Fabric Manager (UFM) leistet, welche seiner drei Stufen zu welchem Cluster passt, was eine bessere Fabric-Sichtbarkeit in GPU-Stunden wert ist und wie Workstation das Monitoring für Sie liefert, einrichtet und betreibt. Ingenieure, die die Plugins, die OpenTelemetry-Konfiguration und die Alarmregeln suchen, sollten den technischen Artikel lesen.
Interaktive Version: Öffnen Sie siebzehn Beispiel-Dashboards, vom Zustand des Fabrics bis zu den Kosten pro GPU-Stunde, jeweils mit den zugrunde liegenden Abfragen und Alarmschwellen.

Warum das Fabric bestimmt, was Ihre GPUs wert sind
Ein großes Modell zu trainieren oder es über mehrere Server hinweg bereitzustellen, ist für GPUs ein Mannschaftssport. Alle paar Millisekunden halten sie an und tauschen über das Netzwerk Ergebnisse untereinander aus. Der Job kann nur so schnell vorankommen wie der langsamste Austausch. Wenn einer von mehreren hundert Links mit Fehlern läuft, Pakete wiederholt oder still auf eine niedrigere Geschwindigkeit zurückfällt, wartet jede GPU in diesem Job darauf.
Das unterscheidet KI-Netzwerke von Büronetzwerken. In einem normalen Netzwerk ärgert ein langsamer Link ein paar Nutzer. In einem KI-Fabric macht ein langsamer Link aus einem Job mit 256 GPUs eine Warteschlange mit 256 GPUs. Und das Symptom sieht nicht wie ein Netzwerkproblem aus. Es sieht aus wie „das Training ist diese Woche langsamer“ oder „die GPUs laufen nur bei 60 %“. Die Teams verbringen dann Tage damit, Software zu optimieren, die nie die Ursache war.
Die Rechnung ist einfach genug, um sie einer Finanzleitung vorzulegen. Nehmen Sie einen Cluster mit 256 GPUs und setzen Sie für jede GPU-Stunde Vollkosten von £2,50 an (Hardwareabschreibung, Strom, Kühlung, Fläche und Support; Ihre Zahl wird abweichen). Dieser Cluster entspricht rund 2,24 Millionen GPU-Stunden pro Jahr:
- 1 % Auslastungsverlust durch Fabric-Probleme kostet rund £56.000 pro Jahr.
- Ein einziger flatternder Link, der einen Trainingslauf mit 256 GPUs drei Stunden lang ausbremst, bevor es jemand bemerkt, kostet rund 770 GPU-Stunden oder £1.900, zuzüglich des Neustarts ab dem letzten Checkpoint.
- Ein ausfallender Transceiver, der in einem geplanten Wartungsfenster statt mitten im Lauf ersetzt wird, spart noch einmal denselben Betrag, und den Wochenendeinsatz.
Das sind illustrative Zahlen, aber die Struktur ist immer dieselbe: Die Kosten für eine ordentliche Überwachung des Fabrics sind gering im Vergleich zu der GPU-Zeit, die sie schützt.
Was NVIDIA UFM ist, einfach erklärt
InfiniBand ist das Netzwerk, das die meisten großen KI- und HPC-Cluster zwischen GPU-Servern einsetzen, weil es schnell und vorhersehbar ist und den Servern viel Arbeit abnimmt. Jedes InfiniBand-Fabric benötigt einen Subnet-Manager, die Software, die jeden Switch und jeden Adapter erkennt, Routen berechnet und das Fabric am Laufen hält. NVIDIA Unified Fabric Manager ist die Software von NVIDIA, um dieses Fabric im Rechenzentrumsmaßstab zu betreiben und zu überwachen.
Stellen Sie es sich als drei Aufgaben in einer Produktfamilie vor: NVIDIA beschreibt die vollständige Plattform auf seiner offiziellen UFM-Seite.
- Sehen. Zähler von jedem Switch-Port, Adapter und Kabel erfassen: Datenverkehr, Fehler, Wiederholungen, Temperaturen, Link-Geschwindigkeiten. Sie live anzeigen und die Historie aufbewahren.
- Betreiben. Die Topologie erkennen, den Subnet-Manager verwalten, das Fabric in isolierte Partitionen für verschiedene Teams oder Kunden aufteilen, Firmware und Konfiguration einheitlich ausrollen sowie Ereignisse und Alarme auslösen.
- Vorhersagen. Lernen, wie der Normalzustand Ihres Fabrics aussieht, und das Kabel markieren, das schlechter wird, oder das Verkehrsmuster, das nicht passt, bevor es ausfällt.
UFM verfügt außerdem über ein offenes Software Development Kit mit Plugins, die seine Daten an die Tools senden, die Ihr Betriebsteam bereits nutzt: Prometheus und Grafana, Elasticsearch über Fluentd, Zabbix, Syslog und den Job-Scheduler Slurm. Das ist wichtig, denn niemand möchte noch einen weiteren Bildschirm beobachten. Die Plugins behandeln wir ausführlich im technischen Artikel.
Die drei UFM-Stufen und wann welche passt
NVIDIA bietet UFM in drei Hauptstufen an. Die Namen beschreiben, was jede hinzufügt:
| Stufe | Was sie hinzufügt | Am besten geeignet, wenn | Worauf zu achten ist |
|---|---|---|---|
| UFM Telemetry | Echtzeiterfassung von Fabric-Zählern und Kabeldaten, die an Ihre eigenen Monitoring-Tools gestreamt werden. Nur Sichtbarkeit. | Kleinere Cluster, bei denen der Subnet-Manager bereits auf einem Switch läuft, oder Teams, die lediglich Fabric-Daten in Grafana benötigen. | Keine Partitionsverwaltung, keine zentrale Fabric-Steuerung und kein Hochverfügbarkeitspaar. |
| UFM Enterprise | Alles aus Telemetry plus vollständige Fabric-Verwaltung: Erkennung, Topologieansichten, Steuerung des Subnet-Managers, Partitionen, Ereignisse und Alarme, Zustandsberichte, eine REST-API, Scheduler-Integration und ein Active/Standby-HA-Paar. | Die meisten produktiven KI-Cluster, alles, was zwischen Teams oder Mandanten geteilt wird, und jeder Cluster mit Slurm. | Benötigt dedizierte Management-Server (oder die Appliance von NVIDIA) und jemanden, der dafür verantwortlich ist. |
| UFM Cyber-AI | Analysen auf Basis der Telemetrie-Historie von Enterprise: lernt das Normalverhalten jedes Fabrics, sagt ausfallende Links und Kabel vorher und markiert Anomalien bei Leistung oder Nutzung. | Große Fabrics mit Tausenden von Kabeln, bei denen sich die Ausfallvorhersage selbst bezahlt, und Anbieter, die GPU-Kapazität verkaufen und Missbrauch erkennen müssen. | Ihr Nutzen wächst mit Fabric-Größe und Historie; bei einem Cluster mit einem einzigen Switch ist sie meist mehr, als Sie brauchen. |
Genaue Funktionen, Lizenzierung und Appliance-Optionen ändern sich zwischen UFM-Releases, daher bestätigen wir die aktuelle Paketierung für jedes Angebot mit NVIDIA. Die Entscheidungslogik ist jedoch stabil: Telemetry, wenn Sie das Fabric nur sehen müssen, Enterprise, wenn Sie es betreiben müssen, Cyber-AI, wenn das Fabric so groß ist, dass die Vorhersage von Ausfällen echtes Geld spart.
Drei Cluster, drei Antworten
1. Ein DGX-B300- oder HGX-B300-Cluster mit vier Knoten
Vier Server mit je acht GPUs, 32 GPUs, von einem KI-Team für Fine-Tuning und Inferenz genutzt. Jeder Server hat acht Netzwerkadapter mit 800 Gb/s für das GPU-Fabric, also gibt es 32 Compute-Ports, die auf einen einzigen InfiniBand-Switch passen.
- Unsere übliche Empfehlung: Betreiben Sie den Subnet-Manager auf dem Switch und nutzen Sie UFM Telemetry, um Fabric-Zähler in dasselbe Grafana einzuspeisen, das die GPU-Auslastung zeigt. Wenn der Cluster später wachsen oder geteilt werden soll, beginnen Sie mit UFM Enterprise, damit Partitionierung und Historie bereits vorhanden sind.
- Geschäftliches Ergebnis: Ein Dashboard zeigt GPUs und Netzwerk gemeinsam. Wenn ein Job langsamer wird, kann das Team innerhalb von Minuten erkennen, ob eine GPU, ein Server oder ein Port die Ursache ist, statt einen Supportfall zu eröffnen und zu warten.
- Beispiel: Der Durchsatz eines Fine-Tuning-Jobs sinkt jeden Nachmittag um ein Fünftel. Das Fabric-Panel zeigt steigende Fehlerbehebungszähler an einem Port, während sich der Raum erwärmt. Die Ursache ist ein temperaturempfindlicher Transceiver; er wird im Rahmen der Garantie getauscht, bevor er endgültig ausfällt.
2. Ein Cluster im SuperPOD-Stil mit 32 Knoten
Zweiunddreißig Server mit je acht GPUs, 256 GPUs, aufgebaut nach dem Referenzdesign von NVIDIA mit getrennten Netzwerk-Rails, Leaf- und Spine-Switches und weit über tausend optischen Links. Mehrere Teams trainieren darauf große Modelle, und manche Jobs nutzen alle GPUs gleichzeitig.
- Unsere übliche Empfehlung: UFM Enterprise als HA-Paar, mit Partitionen pro Team, dem Plugin zur Problemerkennung zunächst im Dry-Run-Modus und der Telemetrie im zentralen Monitoring. Prüfen Sie UFM Cyber-AI, sobald einige Monate Historie vorliegen: In dieser Größe sind eine Handvoll ausfallender Kabel pro Quartal normal, und ihre Vorhersage ist Geld wert.
- Geschäftliches Ergebnis: Fehler, die sich früher als „der große Job ist langsam“ bemerkbar machten, werden zu einem Ticket, das angibt, welches Kabel, welches Rack und welche Jobs darüber liefen. Wartung wird von Notfall zu Planung.
- Beispiel: Ein Link zwischen einem Leaf und einem Spine beginnt, zweimal pro Stunde zu flattern. Die Alarmierung benachrichtigt den Bereitschaftsingenieur in etwa fünf Minuten, das Problemerkennungs-Plugin von UFM isoliert den Port, sodass der Verkehr darum herum geleitet wird, und der Job mit 256 GPUs läuft mit einer um einen Bruchteil eines Prozents geringeren Bandbreite weiter, statt stehen zu bleiben. Das Kabel wird am nächsten Morgen ersetzt.
3. Ein HPC-Dienst an einer Universität mit Slurm
Ein gemeinsam genutzter Forschungscluster: einige Generationen von GPU-Knoten, ein großer Pool von CPU-Knoten, ein paralleles Dateisystem und Hunderte von Nutzern aus verschiedenen Fachbereichen, alles über Slurm geplant.
- Unsere übliche Empfehlung: UFM Enterprise mit der Slurm-Integration von NVIDIA, die jedem Job während seiner Laufzeit eine eigene Fabric-Partition zuweisen kann, sodass Jobs verschiedener Gruppen sowohl im Netzwerk als auch auf den Servern isoliert sind. GPU-Metriken werden mit der Slurm-Job-ID gekennzeichnet, sodass sich die Nutzung einem Job, einem Nutzer und einem Fachbereich zuordnen lässt.
- Geschäftliches Ergebnis: faire, belegbare Berichterstattung. Das Team für Forschungsrechnen kann jedem Fachbereich seine GPU-Stunden zeigen, wie effizient sie genutzt wurden und ob langsame Jobs am Code oder an der Infrastruktur lagen. Das erleichtert Förderanträge, interne Leistungsverrechnung und Kapazitätsplanung erheblich.
- Beispiel: Ein Doktorand meldet, dass sein Job mit acht Knoten „dienstags immer langsam“ ist. Die Job-Ansicht zeigt, dass seine Knoten einen Leaf-Switch mit einem wöchentlichen Datenimport-Job teilen, der dessen Uplinks auslastet. Die Lösung ist eine Scheduler-Einschränkung, keine neue Hardware.
Was gute Fabric-Sichtbarkeit Ihnen bringt
- Höhere GPU-Auslastung, weil Netzwerkfehler in Minuten statt Tagen gefunden werden und Jobs nicht auf einen einzigen schlechten Port warten.
- Weniger fehlgeschlagene lange Läufe, weil ausfallende Kabel und Transceiver erkannt und in geplanten Wartungsfenstern ersetzt werden.
- Schnellere, ruhigere Vorfälle, weil GPU-, Server-, Netzwerk- und Job-Daten auf einer Zeitachse liegen, sodass die erste Frage („Ist es das Netzwerk?“) mit Belegen beantwortet wird.
- Saubere Mandantenfähigkeit, weil Partitionen und die Isolation pro Job zentral verwaltet und auditiert werden.
- Ehrliche Kapazitäts- und Kostenberichte, weil Sie die Kosten pro nützlicher GPU-Stunde nach Team ausweisen können statt der Kosten pro installierter GPU.
- Stärkere Garantie- und Supportfälle, weil Sie dem Hersteller für ein defektes Teil die Zähler, Zeitstempel und die Historie übergeben können statt einer Beschreibung.
Überwachen Sie den gesamten Stack, nicht nur das Fabric
UFM deckt das InfiniBand-Fabric ab. Ein funktionierender KI-Cluster benötigt außerdem Sichtbarkeit der GPUs (Data Center GPU Manager von NVIDIA, DCGM), der Ethernet-Netzwerke für Storage- und Front-End-Verkehr (NVIDIA Spectrum-X und NetQ), von BlueField Data Processing Units, falls Sie diese einsetzen, der Server, des Schedulers und der KI-Dienste selbst. In unserem früheren Beitrag zu Observability als Unternehmensstandard haben wir argumentiert, dass Monitoring ein unternehmensweiter Vertrag sein sollte und keine Sammlung von Teamvorlieben. Dasselbe gilt hier: Fabric-Daten gehören in dasselbe System wie alles andere, auf dieselbe Weise gekennzeichnet, sodass eine einzige Abfrage einen langsamen Job vom Scheduler über die GPU bis zum Switch-Port verfolgen kann.
Unser Standarddesign nutzt OpenTelemetry, um alles einmal zu erfassen und an zwei Arten von Backends zu senden: Prometheus-kompatible Metriken mit Grafana (wir nutzen Grafana Mimir für langfristige, hochverfügbare Speicherung und Grafana Tempo für Request-Traces) und den Elastic Stack (Elasticsearch und Kibana) für Logs und Ereignisse, weil viele Organisationen ihn bereits betreiben. Wenn Sie sich bereits auf eines davon festgelegt haben, binden wir uns an das an, was Sie haben.
Was Workstation tut
Wir sind ein britischer Reseller und Integrator für NVIDIA-KI-Infrastruktur und betreiben Managed Observability für Kunden. Für einen von UFM verwalteten Cluster bedeutet das drei Dinge:
- Lieferung. GPU-Server (DGX- und HGX-B300-Systeme und andere), InfiniBand- und Ethernet-Switches, Adapter, Kabel und Transceiver sowie die UFM-Lizenzen in der richtigen Stufe, gemeinsam spezifiziert, damit das Fabric zu den GPUs passt. In unserem Shop finden Sie DGX-Systeme, Netzwerktechnik und NVIDIA-Software.
- Einrichtung. Wir installieren UFM (als HA-Paar, wo es passt), konfigurieren Partitionen und die Slurm- oder Kubernetes-Integration, stellen DCGM und die OpenTelemetry-Collector bereit und übergeben Dashboards und Alarmregeln, die an echten Fehlern getestet wurden: Wir ziehen ein Kabel und zeigen Ihnen, wie die Benachrichtigung eintrifft.
- Betrieb für Sie. Unser Managed-Observability-Dienst hält den Monitoring-Stack selbst gesund und hochverfügbar, stimmt Alarme so ab, dass es sich lohnt, für sie aufzuwachen, überwacht Fabric- und GPU-Zustand rund um die Uhr und sendet Ihnen einen monatlichen Bericht zu Auslastung, Fehlern und Kapazität. Wir arbeiten Hand in Hand mit Ihrem Team und dem NVIDIA-Support, nicht an deren Stelle.
Fragen, die Sie vor dem Kauf stellen sollten
- Wer wird im Tagesgeschäft für das Fabric verantwortlich sein, und muss diese Person es betreiben oder nur sehen?
- Wird der Cluster zwischen Teams, Fachbereichen oder Kunden geteilt? Falls ja, wie werden sie im Netzwerk isoliert?
- Welchen Scheduler verwenden Sie, und möchten Sie die GPU- und Fabric-Nutzung pro Job und pro Team ausgewiesen haben?
- Wo sollen die Monitoring-Daten liegen, und wie lange? Betreiben Sie bereits Prometheus, Grafana oder Elastic?
- Was kostet eine Stunde Ihres Clusters, und wie schnell müssen Sie wissen, wenn sie verschwendet wird?
NVIDIA-Partner: Engineering, Software und Menschen
Workstation ist NVIDIA-Partner. Über die Lieferung der Hardware hinaus stellen wir das Engineering, die Software und das Personal bereit, um KI-Rechenzentren zu planen, zu bauen und zu betreiben: Standort- und Stromversorgungsanalysen, Rack- und Fabric-Design, Installation von InfiniBand und Spectrum-X, Einrichtung von UFM, DCGM und OpenTelemetry, Onboarding von Kubernetes und Slurm sowie Ingenieure, die Sie über die Übergabe hinaus bis in den Managed Support begleiten. Die Plattformbeschreibung von NVIDIA selbst finden Sie auf der offiziellen Seite NVIDIA Unified Fabric Manager (UFM) (öffnet sich in einem neuen Tab).
Nächste Schritte
Öffnen Sie die interaktive Dashboard-Galerie, um die siebzehn Ansichten zu sehen, die wir für einen typischen Cluster erstellen, vom Fabric-Zustand bis zu den Kosten pro GPU-Stunde. Fragen Sie dann unseren KI-Vertriebsingenieur, um einen Cluster, ein Fabric und die richtige UFM-Stufe für Ihre Workloads zu dimensionieren, oder stöbern Sie im Workstation-Shop nach HGX-B300-Servern und DGX-BasePOD-Konfigurationen. Gern beginnen wir mit einem Observability-Review eines Clusters, den Sie bereits besitzen.
Die Zahlen in diesem Beitrag sind illustrative Beispiele, keine Messungen bei einem bestimmten Kunden.
Hinweis zu Schutzrechten: NVIDIA, das NVIDIA-Logo, DGX, HGX, Quantum, Spectrum, Spectrum-X, BlueField, ConnectX, NVLink, DOCA, DCGM und Unified Fabric Manager (UFM) sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den Vereinigten Staaten und anderen Ländern. NVIDIA-Produkte und -Technologien können durch Patente und andere geistige Eigentumsrechte der NVIDIA Corporation geschützt sein, und alle diese Rechte werden anerkannt und bleiben ihren Inhabern vorbehalten. Produktinformationen sind in unseren eigenen Worten aus der öffentlichen Dokumentation von NVIDIA zusammengefasst; maßgebliche Quelle sind die Website und die Dokumentation von NVIDIA. Andere Firmen- und Produktnamen, darunter Prometheus, Grafana, Elasticsearch, Kibana, Logstash, OpenTelemetry, Kubernetes und Slurm, können Marken ihrer jeweiligen Inhaber sein. Die eigenen Dashboards, Konfigurationen und Texte von Workstation sind © Workstation.