Infrastruktur auf Enterprise-Niveau für KI-Training und Inferenz im großen Maßstab
Moderne KI-Workloads erfordern eine speziell entwickelte Infrastruktur, die von einer einzelnen GPU-Workstation bis zu Hunderten vernetzter Knoten skaliert. Workstation AI liefert die Tools, Architekturen und das Know-how, um von Kubernetes orchestrierte GPU-Cluster zu entwerfen, bereitzustellen und zu verwalten – damit sich Ihre Teams auf die Modellentwicklung statt auf die Komplexität der Infrastruktur konzentrieren können.
Überblick über die GPU-Cluster-Architektur
Ein gut konzipierter GPU-Cluster kombiniert leistungsstarke Rechenknoten mit schnellen Interconnects, gemeinsamem Speicher und intelligenter Orchestrierung. Das Verständnis der Architektur ist die Grundlage für eine zuverlässige KI-Infrastruktur.
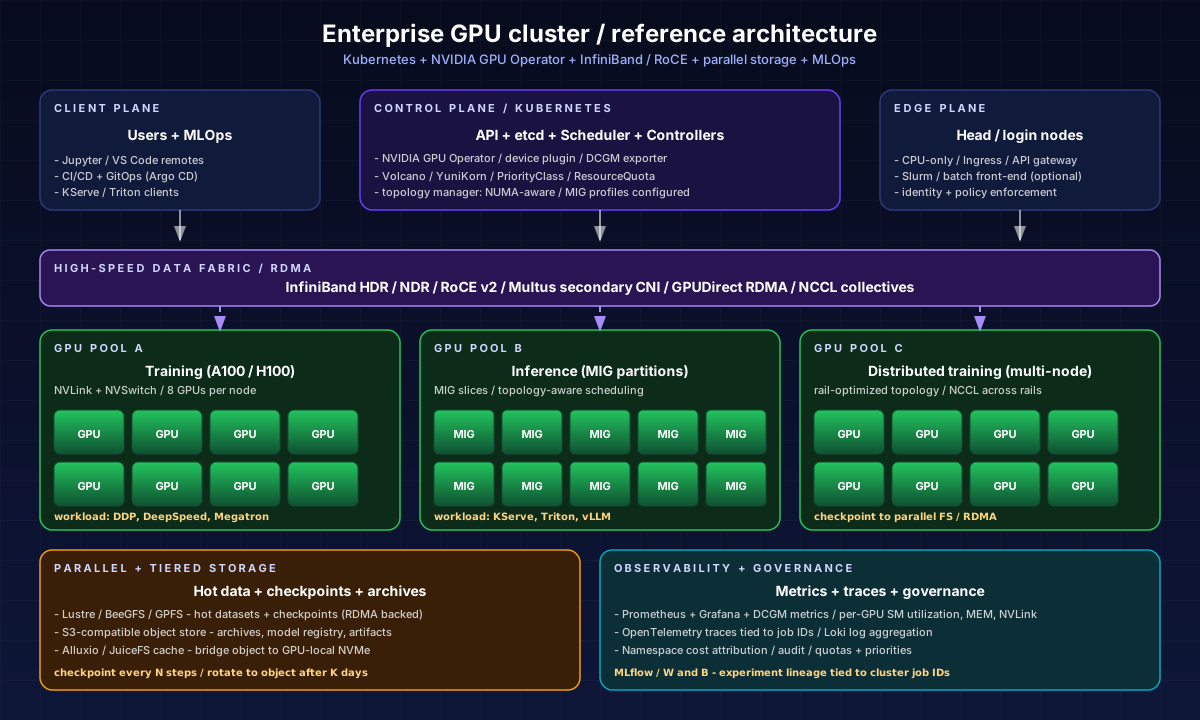
- Jeder Rechenknoten enthält typischerweise 4 bis 8 GPUs (NVIDIA A100, H100 oder L40S), die über NVLink oder NVSwitch für die Kommunikation innerhalb des Knotens mit bis zu 900 GB/s Bandbreite verbunden sind.
- Eine dedizierte Management-Ebene übernimmt Job-Scheduling, Ressourcenzuteilung, Zustandsüberwachung und Zugriffskontrolle und hält die Datenebene frei für den Trainingsverkehr.
- Head-Nodes dienen als Zugang, über den Benutzer Jobs einreichen, auf Jupyter-Umgebungen zugreifen und mit MLOps-Tools arbeiten, ohne GPU-Ressourcen zu verbrauchen.
- Schnelle Netzwerk-Fabrics wie InfiniBand HDR (200 Gbit/s) oder RoCE v2 verbinden die Knoten für verteiltes Training und minimieren die Latenz bei der Gradientensynchronisation.
- Gemeinsame parallele Dateisysteme (Lustre, GPFS oder BeeGFS) liefern den Durchsatz für Datensatz-I/O im großen Maßstab, ohne Speicherengpässe zu verursachen.
Kubernetes für KI-Workloads
Kubernetes ist zum De-facto-Orchestrator für KI-Infrastruktur geworden und bietet deklaratives Ressourcenmanagement, automatische Skalierung und ein reichhaltiges Ökosystem GPU-fähiger Komponenten.
- ✓Der NVIDIA GPU Operator automatisiert die Bereitstellung von GPU-Treibern, Container-Toolkit, Device-Plugins und Monitoring-Exportern auf allen Knoten und macht manuelles Treibermanagement überflüssig.
- ✓Kubernetes-Device-Plugins machen GPU-Ressourcen für den Scheduler sichtbar und ermöglichen eine feingranulare Zuteilung, etwa die Anforderung bestimmter GPU-Modelle, MIG-Slices (Multi-Instance GPU) oder zeitlich geteilten Zugriff.
- ✓Eigene Scheduling-Richtlinien wie Bin-Packing, topologiebewusste Platzierung und Gang-Scheduling sorgen dafür, dass Multi-GPU-Jobs auf Knoten mit optimaler Interconnect-Topologie landen.
- ✓Namespace-basierte Ressourcenkontingente und Prioritätsklassen ermöglichen es Teams, einen Cluster gemeinsam zu nutzen und dabei SLAs für produktive Inferenz-Workloads vor experimentellen Trainingsläufen zu garantieren.
- ✓Die Integration von Volcano oder Apache YuniKorn bietet Batch-Scheduling speziell für KI- und HPC-Workloads, mit Fair-Share-Warteschlangen und Job-Preemption.
MLOps-Pipelines auf GPU-Clustern
Eine durchgängige MLOps-Pipeline verwandelt Rohdaten in bereitgestellte Modelle – mit voller Reproduzierbarkeit, Versionierung und Observability in jeder Phase.
- ✓Pipelines zur Datenaufnahme und Vorverarbeitung laufen auf CPU-Knoten mit Apache Spark oder Dask und legen bereinigte Datensätze im gemeinsamen Speicher für die GPU-Trainingsphasen ab.
- ✓Plattformen für Experiment-Tracking wie MLflow oder Weights & Biases erfassen Hyperparameter, Metriken und Artefakte und ermöglichen reproduzierbare Vergleiche über Hunderte von Trainingsläufen.
- ✓Frameworks für verteiltes Training (PyTorch DDP, DeepSpeed, Horovod) koordinieren Gradienten-Updates über mehrere GPUs und Knoten hinweg, während Kubernetes Platzierung und Lebenszyklus der Pods verwaltet.
- ✓Modell-Registries versionieren trainierte Modelle mit Metadaten und Herkunft und lassen sich in CI/CD-Pipelines integrieren, um Validierung, A/B-Tests und Canary-Deployments zu automatisieren.
- ✓Inferenz-Serving mit Triton Inference Server, vLLM oder KServe liefert Vorhersagen mit geringer Latenz – mit dynamischem Batching, Modell-Ensembles und automatischer GPU-Skalierung je nach Anfragelast.
Netzwerke für verteilte KI
Die Netzwerkleistung ist beim verteilten Training oft der Engpass. Die Wahl des richtigen Fabrics und der richtigen Konfiguration ist entscheidend für eine effiziente Skalierung.
- ✓InfiniBand HDR/NDR bietet mit RDMA die niedrigste Latenz und höchste Bandbreite (200–400 Gbit/s pro Port) und ist damit ideal für Training im großen Maßstab über 64+ Knoten.
- ✓RoCE v2 (RDMA over Converged Ethernet) ist eine kostengünstige Alternative, die über Standard-Ethernet-Switches läuft und dennoch RDMA für geringeren CPU-Overhead unterstützt.
- ✓Die Netzwerktopologie ist entscheidend: Fat-Tree- und Rail-optimierte Designs minimieren Überbuchung, während das SHARP-Protokoll von NVIDIA kollektive Operationen direkt auf die Netzwerk-Switches auslagert.
- ✓In Kubernetes-Umgebungen ermöglicht Multus CNI, dass Pods sowohl an das primäre Cluster-Netzwerk als auch an ein sekundäres schnelles RDMA-Netzwerk für den Trainingsverkehr angebunden werden.
- ✓Netzwerkisolation mit SR-IOV Virtual Functions gibt jedem Trainings-Pod direkten Hardwarezugriff auf den Netzwerkadapter und umgeht den Kernel-Stack für Leistung in Leitungsgeschwindigkeit.
Speicherlösungen für KI-Workloads
KI-Workloads haben vielfältige Speicheranforderungen: parallele Lesevorgänge mit hohem Durchsatz für Trainingsdaten, Zugriff mit geringer Latenz für Checkpoints und langlebigen Objektspeicher für Datensätze und Artefakte.
- ✓NFS bleibt eine praktische Wahl für kleinere Cluster und gemeinsame Home-Verzeichnisse, auch wenn es wegen begrenzten Durchsatzes ab wenigen Knoten nicht als primärer Speicher für Trainingsdaten taugt.
- ✓Ceph bietet eine einheitliche Speicherplattform mit Block- (RBD), Datei- (CephFS) und Objektschnittstellen (RGW) und skaliert horizontal bis in den Petabyte-Bereich, mit integrierter Replikation und Erasure Coding.
- ✓Longhorn, eine schlanke Kubernetes-native Speicherlösung, liefert replizierten Blockspeicher – ideal für Modell-Checkpoints und Persistent Volumes in kleineren GPU-Clustern.
- ✓Leistungsstarke Caching-Schichten mit Alluxio oder JuiceFS können die Lücke zwischen langsamem Objektspeicher (S3-kompatibel) und den Durchsatzanforderungen von GPU-Data-Loadern schließen.
- ✓Eine gestufte Speicherstrategie ist unerlässlich: schnelle NVMe-SSDs auf den Rechenknoten für Scratch und Checkpoints, parallele Dateisysteme für aktive Datensätze und kalter Objektspeicher für die Archivierung.
GPU-Auslastung überwachen
Transparenz über Zustand und Auslastung der GPUs ist unerlässlich, um die Rendite der Infrastrukturinvestition zu maximieren und Leistungsengpässe zu erkennen, bevor sie Trainingsläufe beeinträchtigen.
- ✓Der DCGM-Exporter (Data Center GPU Manager) erfasst über 50 GPU-Metriken, darunter SM-Auslastung, Speicherbandbreite, Temperatur, Leistungsaufnahme und ECC-Fehlerzähler, für das Scraping durch Prometheus.
- ✓Grafana-Dashboards bieten Echtzeit- und historische Ansichten der Auslastung pro GPU, pro Knoten und pro Job, sodass Teams ungenutzte Ressourcen erkennen und Zuteilungen richtig dimensionieren können.
- ✓Alarme bei GPU-Speicherauslastung, thermischer Drosselung und Xid-Fehlern ermöglichen proaktive Wartung und verhindern, dass Hardwareausfälle mehrtägige Trainingsläufe unterbrechen.
- ✓Die Integration mit Kubernetes-Metriken (kube-state-metrics) setzt die GPU-Auslastung in Beziehung zu Pod-Scheduling-Entscheidungen und hilft Administratoren, Bin-Packing und die Größe der Knotenpools zu optimieren.
- ✓Kostenzuordnung nach Namespace oder Team anhand von GPU-Stunden ermöglicht Chargeback-Modelle, die eine effiziente Ressourcennutzung fördern und den Ausbau der Infrastruktur begründen.
Von der Workstation zum Rechenzentrum skalieren
Wählen Sie die passende Größenordnung für Ihre KI-Ziele. Jede Stufe baut auf der vorherigen auf, und Workstation AI bietet Migrationspfade zwischen ihnen.
| Stufe | GPUs | Anwendungsfall | Netzwerk | Speicher | Orchestrierung |
|---|---|---|---|---|---|
| Einzelne Workstation | 1–2 GPUs | Prototyping, Feintuning kleiner Modelle, Inferenzentwicklung | PCIe / NVLink | Lokale NVMe-SSD | Docker / Docker Compose |
| Kleiner Cluster | 8–32 GPUs (2–4 Knoten) | Modelltraining bis 7B Parameter, Inferenz-Serving für mehrere Modelle | 25–100 GbE / RoCE v2 | NFS / Longhorn | K3s / MicroK8s |
| Mittelgroßer Cluster | 32–128 GPUs (4–16 Knoten) | Training von Modellen mit 7B–70B Parametern, produktive Inferenz im großen Maßstab | InfiniBand HDR 200G | Ceph / BeeGFS | Kubernetes + GPU Operator |
| Großer Cluster | 128–1000+ GPUs (16–128 Knoten) | Training von Foundation-Modellen, mandantenfähige KI-Plattform | InfiniBand NDR 400G | Lustre / GPFS + Objektspeicher | Kubernetes + Volcano + Slurm |
End-to-End-MLOps-Pipeline
From data ingestion to model serving, a well-architected MLOps pipeline on Kubernetes automates every stage of the machine learning lifecycle.
Data Ingestion
Preprocessing
Distributed Training
Experiment Tracking
Model Registry
Inference Serving
Planen Sie Ihren GPU-Cluster
Ob Sie von einer einzelnen Workstation aus skalieren oder eine KI-Trainingsplattform mit mehreren Knoten konzipieren: Unser Team hilft Ihnen, die richtige Infrastruktur für Ihre Workloads und Ihr Budget zu entwerfen.