KI-Wissensdatenbank · Linux-Betriebssystem
Linux, optimiert für KI
Jedes KI-System, das wir ausliefern, läuft unter Linux. Dieser Leitfaden behandelt die Distributionen, die das Workstation-Team unterstützt, wie wir sie härten, die Kernel- und Treibereinstellungen, auf die es bei GPUs ankommt, wie wir sie unter Kubernetes und Docker betreiben, wie LLM-APIs darauf skalieren und die CI/CD-Pipelines, die Modelle, Agenten und Daten sicher in die Produktion bringen.
- Ubuntu
- Red Hat Enterprise Linux
- SUSE Linux
- Alpine Linux
- Debian
- Rocky & AlmaLinux
Wahl der Distribution
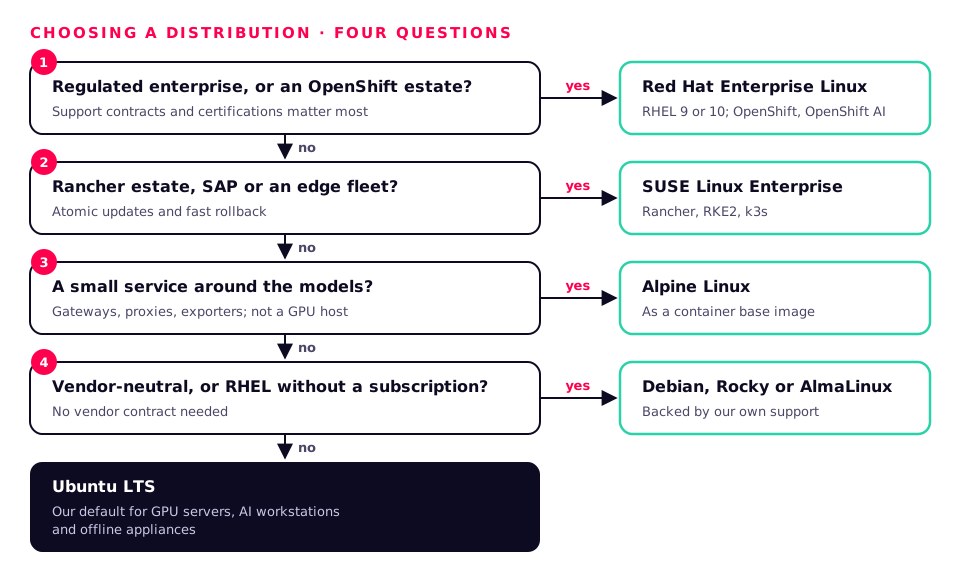
Es gibt nicht das eine beste Linux für KI. Die richtige Wahl hängt davon ab, wo es läuft, wer es unterstützt und wo es sich sonst noch einfügen muss. So entscheiden wir in der Regel.
| Distribution | Am besten geeignet für | GPU & CUDA | Kubernetes | Lebenszyklus |
|---|---|---|---|---|
| Ubuntu LTS | GPU-Server, Workstations, die meisten KI-Teams | Erstklassig: NVIDIA entwickelt und testet hier zuerst; signierte Treiber | Canonical Kubernetes, MicroK8s, k3s, RKE2 | 5 Jahre, mit Ubuntu Pro über 10 |
| Red Hat Enterprise Linux | Regulierte Unternehmen, OpenShift-Umgebungen | NVIDIA-CUDA-Repository und Treiber-Streams; RHEL AI | OpenShift, OpenShift AI | 10 Jahre, plus erweiterter Support |
| SUSE Linux Enterprise | Rancher-Umgebungen, SAP und Edge-Flotten | Signierte Pakete des offenen NVIDIA-Kernel-Treibers; SUSE AI | Rancher, RKE2, k3s | Langer Lebenszyklus mit LTSS |
| Alpine Linux | Minimale Container, Gateways und Edge-Dienste | Nicht für GPU-Hosts (musl, kein CUDA) | Als Container-Basis-Image | Etwa 2 Jahre pro Release |
| Debian | Stabile, herstellerneutrale Server und Labore | NVIDIA-Treiber in non-free; CUDA-Repository | k3s, kubeadm, RKE2 | Etwa 5 Jahre mit LTS |
| Rocky & AlmaLinux | RHEL-kompatibel ohne Subscription | Dieselben Pakete wie RHEL | kubeadm, RKE2, k3s, OKD | Etwa 10 Jahre |
Die Distributionen, die wir unterstützen
Ubuntu
Der Standard für GPU-Server und KI-Workstations.
Der Großteil des KI-Ökosystems wird zuerst auf Ubuntu entwickelt und getestet. NVIDIAs NGC-Container, die CUDA-Dokumentation und viele Framework-Installer setzen es voraus – das bedeutet weniger Überraschungen, wenn ein neues GPU-, Treiber- oder Modell-Release erscheint.
Versionen, die wir einsetzen: Ubuntu 24.04 LTS (Server und Desktop), 22.04 LTS für bestehende Umgebungen
GPU-, CUDA- und KI-Stack
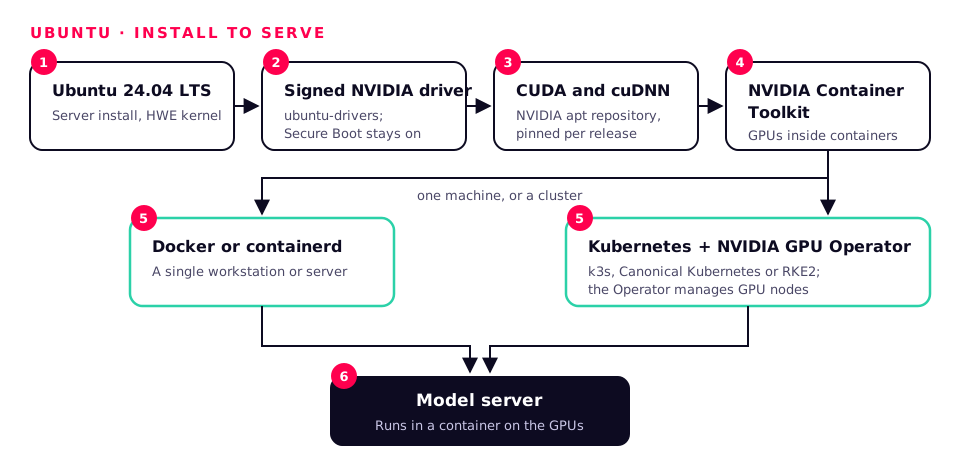
- ubuntu-drivers installiert von Canonical signierte NVIDIA-Kernelmodule, sodass UEFI Secure Boot aktiviert bleibt, ohne einen eigenen Schlüssel zu registrieren.
- CUDA, cuDNN und das NVIDIA Container Toolkit aus NVIDIAs apt-Repositories, pro Release fixiert.
- HWE-Kernel bringen Unterstützung für die neuesten CPUs, GPUs und NICs in ein LTS-Release.
Wie wir es für KI optimieren
- Server-Installationen, minimale Pakete, Snaps auf Appliances zurückgehalten oder entfernt.
- Performance-CPU-Governor, NUMA-bewusste Platzierung und Persistence Mode für die GPUs (siehe Kernel-Abschnitt).
- Unbeaufsichtigte Sicherheitsupdates in einem Wartungsfenster oder Offline-Update-Bundles für Air-Gapped-Standorte.
Kubernetes und Container
- Docker oder containerd mit dem NVIDIA Container Toolkit.
- k3s für Single-Node und Edge, Canonical Kubernetes oder RKE2 für Cluster, darauf der NVIDIA GPU Operator.
Sicherheit
- Ubuntu Pro ergänzt Livepatch, FIPS-140-Module, erweiterte Sicherheitswartung und den Ubuntu Security Guide für die Härtung nach CIS und DISA-STIG.
- AppArmor im Enforcing-Modus, mit Profilen für die von uns betriebenen Dienste.
Unsere Einschätzung: Unser Standard für GPU-Server, KI-Workstations und Offline-Appliances, sofern eine Umgebung nicht bereits auf etwas anderes standardisiert ist.
Red Hat Enterprise Linux
Für regulierte Unternehmen und OpenShift-Umgebungen.
RHEL bietet einen zehnjährigen Lebenszyklus, zertifizierte Hardware und einen Supportvertrag, den Einkauf und Auditoren anerkennen. Red Hats KI-Portfolio – RHEL AI, OpenShift AI und der vLLM-basierte Red Hat AI Inference Server – baut darauf auf.
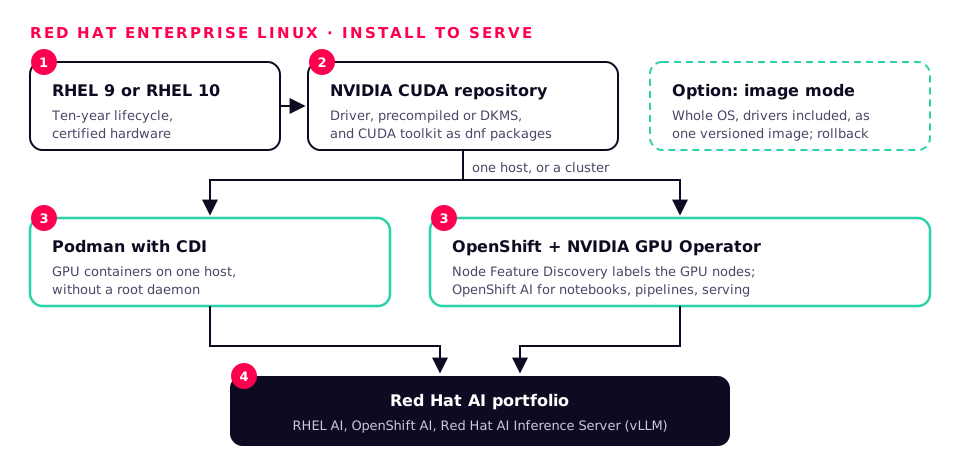
Versionen, die wir einsetzen: RHEL 9 und RHEL 10
GPU-, CUDA- und KI-Stack
- NVIDIAs CUDA-Repository für RHEL stellt den Treiber (vorkompiliert oder DKMS) und das CUDA-Toolkit als dnf-Pakete bereit.
- Podman mit CDI (Container Device Interface) für GPU-Container ohne Root-Daemon.
- Im Image Mode (bootfähige Container) lässt sich das gesamte Betriebssystem inklusive Treibern als ein versioniertes Image ausliefern und zurückrollen.
Wie wir es für KI optimieren
- tuned-Profile wie throughput-performance oder accelerator-performance als Ausgangspunkt, danach workloadspezifische Anpassungen.
- NUMA-, IRQ-Affinitäts- und Huge-Page-Einstellungen als Code verwaltet.
Kubernetes und Container
- OpenShift mit dem NVIDIA GPU Operator und Node Feature Discovery; OpenShift AI für Notebooks, Pipelines und Model Serving.
Sicherheit
- SELinux standardmäßig im Enforcing-Modus, FIPS-Modus sowie OpenSCAP mit dem SCAP Security Guide für CIS- und STIG-Profile.
- kpatch-Live-Kernel-Patching für Sicherheitskorrekturen ohne Ausfallzeit.
Unsere Einschätzung: Die richtige Wahl, wenn Supportverträge, Zertifizierungen oder eine bestehende OpenShift-Plattform wichtiger sind als die neuesten Pakete.
SUSE Linux
Für Rancher-verwaltete Flotten, SAP und Edge.
SUSE kombiniert ein Enterprise-Linux mit Rancher, einer der meistgenutzten Lösungen zur Verwaltung vieler Kubernetes-Cluster, und mit SUSE AI für den Betrieb privater KI auf dieser Plattform. Dank Snapshot- und Transactional-Update-Werkzeugen werden Rollbacks zur Routine.
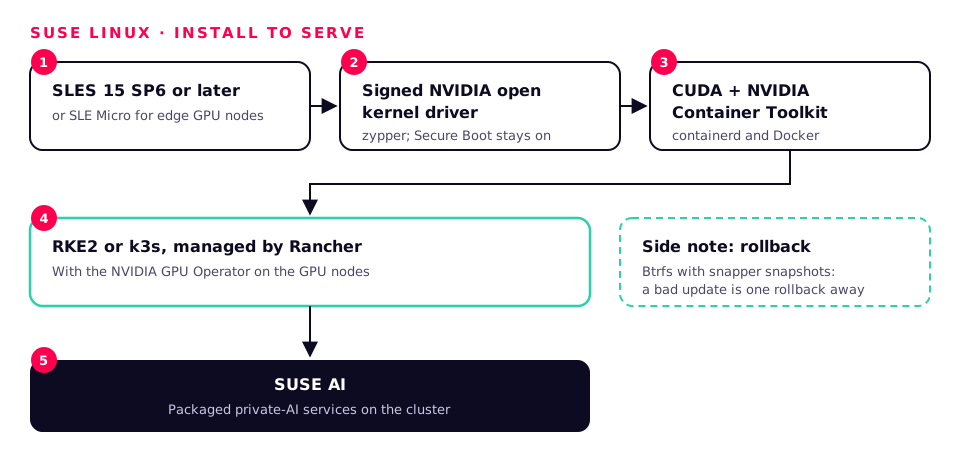
Versionen, die wir einsetzen: SUSE Linux Enterprise Server 15 SP6 und neuer, SLE Micro für Edge, openSUSE Leap für Labore
GPU-, CUDA- und KI-Stack
- SUSE paketiert NVIDIAs offene GPU-Kernelmodule für Secure Boot signiert, installierbar mit zypper.
- CUDA aus NVIDIAs SUSE-Repository; das NVIDIA Container Toolkit für containerd und Docker.
Wie wir es für KI optimieren
- Btrfs mit snapper-Snapshots, sodass ein fehlerhaftes Treiber- oder Kernel-Update nur einen Rollback entfernt ist.
- Das schreibgeschützte, transaktionale Betriebssystem SLE Micro für Edge-GPU-Knoten, die atomar aktualisiert werden müssen.
Kubernetes und Container
- RKE2 oder k3s, verwaltet von Rancher, mit dem NVIDIA GPU Operator; SUSE AI für paketierte Private-AI-Dienste.
Sicherheit
- Mandatory Access Control (AppArmor oder SELinux), FIPS-zertifizierte Module, OpenSCAP-Härtungsprofile.
- SUSE Live Patching für Kernel-Korrekturen ohne Neustart.
Unsere Einschätzung: Ideal, wenn Rancher die Cluster bereits verwaltet, oder für Edge-Flotten, die atomare Updates und schnelle Rollbacks benötigen.

Alpine Linux
Winzig, schnell und gehärtet – für Container statt GPU-Hosts.
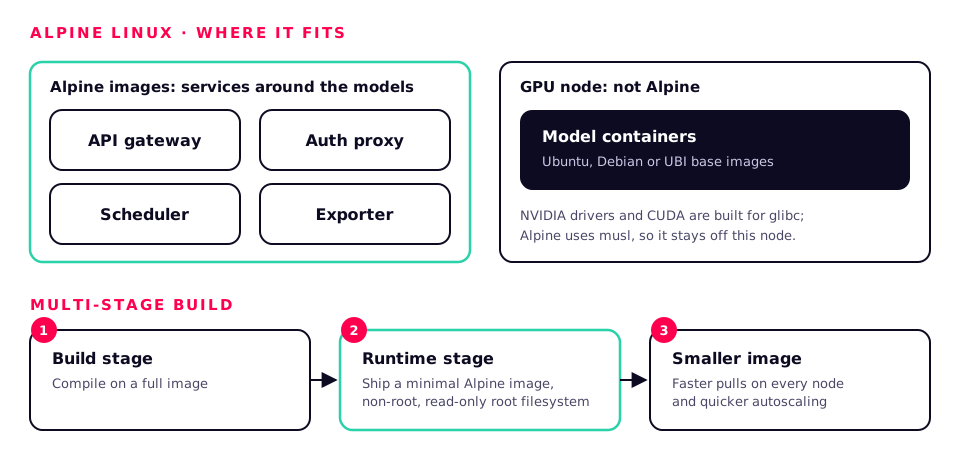
Alpines Basis-Image ist nur wenige Megabyte groß und basiert auf musl libc und BusyBox mit einer gehärteten Toolchain. Damit eignet es sich hervorragend für die kleinen Dienste rund um ein KI-System, aber schlecht für die GPU-Arbeit selbst.
Versionen, die wir einsetzen: Aktuelle stabile Alpine-Releases als Container-Basis-Images
GPU-, CUDA- und KI-Stack
- NVIDIA-Treiber und CUDA sind für glibc gebaut, und PyTorch veröffentlicht keine musl-Wheels – GPU- und die meisten Trainings-Images gehören daher auf Ubuntu-, Debian- oder UBI-Basis.
- Ideal für API-Gateways, Auth-Proxys, Scheduler, Exporter und schlanke CPU-Inferenz mit kompilierten Runtimes.
Wie wir es für KI optimieren
- Multi-Stage-Builds, die auf einem vollständigen Image kompilieren und eine minimale Alpine-Runtime ausliefern.
- Kleinere Images bedeuten schnellere Pulls auf jedem Knoten und schnelleres Autoscaling.
Kubernetes und Container
- Ein Basis-Image für Sidecars, Init-Container und Edge-Dienste in jeder Kubernetes-Distribution.
Sicherheit
- Ein kleiner Paketumfang bedeutet eine kleine Angriffsfläche und kurze Berichte aus Schwachstellenscans.
- Ausführung als Nicht-Root mit schreibgeschütztem Root-Dateisystem.
Unsere Einschätzung: Setzen Sie es für die Dienste rund um Ihre Modelle ein, nicht für die GPU-Knoten oder die Modellcontainer selbst.

Debian, Rocky & AlmaLinux
Community-Distributionen, die wir im Produktivbetrieb unterstützen.
Debian ist die stabile, herstellerneutrale Basis unter Ubuntu und vielen Appliances. Rocky Linux und AlmaLinux sind binärkompatibel mit RHEL – für Teams, die das RHEL-Ökosystem ohne Subscription nutzen möchten.
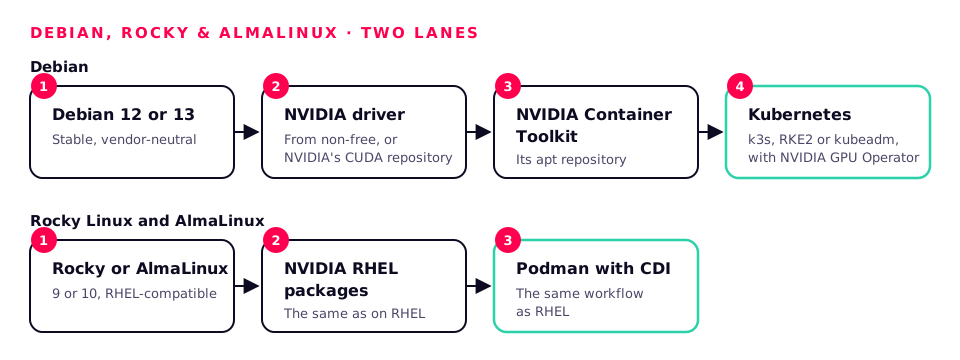
Versionen, die wir einsetzen: Debian 12 und 13; Rocky Linux und AlmaLinux 9 und 10
GPU-, CUDA- und KI-Stack
- Debian: NVIDIA-Treiber aus dem non-free-Repository oder NVIDIAs CUDA-Repository; das apt-Repository des NVIDIA Container Toolkit.
- Rocky und AlmaLinux: dieselben NVIDIA-RHEL-Pakete und derselbe Podman-CDI-Workflow wie bei RHEL.
Wie wir es für KI optimieren
- Dieselben Kernel-, NUMA- und Storage-Einstellungen wie bei ihren kommerziellen Verwandten, angewendet mit Ansible.
- Debian ist auch die Grundlage von Proxmox VE, das wir für GPU-Passthrough-Labore nutzen.
Kubernetes und Container
- k3s-, RKE2- oder kubeadm-Cluster mit dem NVIDIA GPU Operator.
Sicherheit
- CIS-Benchmarks über OpenSCAP, AppArmor auf Debian und SELinux auf Rocky und AlmaLinux, mit automatisierten Sicherheitsupdates.
Unsere Einschätzung: Solide, kostengünstige Optionen, wenn Sie keinen Herstellervertrag benötigen – abgesichert durch unseren eigenen Support.
Kernel- & OS-Optimierungen für KI-Workloads
GPUs sind nur schnell, wenn der Host sie ausreichend versorgt. Diese Einstellungen prüfen wir bei jedem KI-System und optimieren sie dann anhand der Workload des Kunden. Keine davon ist universell: Wir messen vorher und nachher.
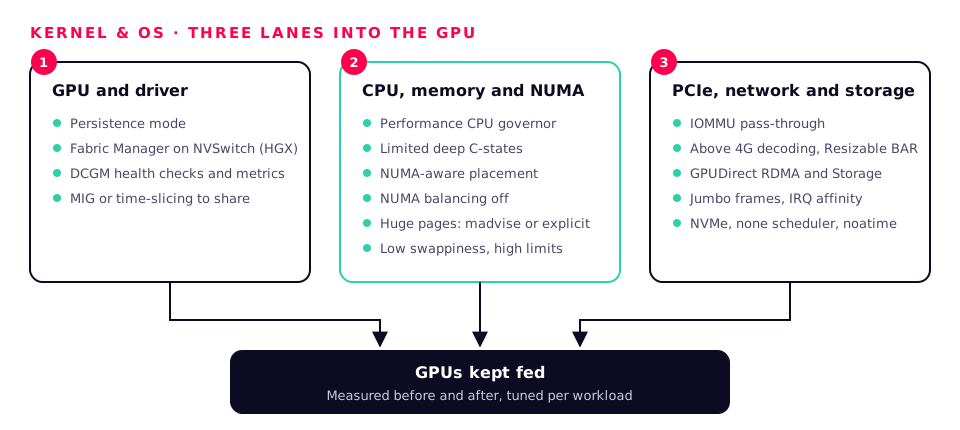
GPU und Treiber
- Persistence Mode (nvidia-persistenced), damit der Treiber geladen bleibt und die erste Anfrage nicht langsam ist.
- NVIDIA Fabric Manager auf NVSwitch-Systemen (HGX): Ohne ihn initialisieren die GPUs nicht für CUDA.
- DCGM für Integritätsprüfungen, Diagnosen und Metriken pro GPU.
- MIG-Partitionen oder Time-Slicing, wenn sich viele kleine Modelle eine große GPU teilen.
CPU, Arbeitsspeicher und NUMA
- Performance-CPU-Governor und begrenzte tiefe C-States auf latenzkritischen Inferenz-Hosts.
- NUMA-bewusste Platzierung: Die Arbeit jeder GPU wird an den nächstgelegenen CPU-Sockel und Speicher gebunden (nvidia-smi topo -m zeigt die Zuordnung).
- Automatisches NUMA-Balancing auf dedizierten GPU-Hosts deaktiviert, damit Seiten unter Last nicht migrieren.
- Transparent Huge Pages standardmäßig auf madvise; explizite Huge Pages für RDMA- und DPDK-Workloads.
- Niedrige Swappiness und großzügige memlock- und File-Descriptor-Limits für Data Loader und RDMA.
PCIe, Netzwerk und Storage
- IOMMU im Pass-through-Modus sowie Above 4G Decoding / Resizable BAR in der Firmware.
- GPUDirect RDMA (nvidia-peermem) und GPUDirect Storage (nvidia-fs), damit Daten die CPU umgehen.
- Jumbo Frames durchgängig auf Storage- und RoCE-Fabrics, mit über die Kerne verteilter IRQ-Affinität.
- NVMe mit dem Scheduler none, XFS oder ext4 mit noatime für Datensätze und Checkpoints.
Ein Ausgangspunkt (pro Workload getestet, nie blind übernommen)
# /etc/sysctl.d/90-ai.conf
kernel.numa_balancing = 0
vm.swappiness = 10
vm.max_map_count = 1048576
net.core.rmem_max = 268435456
net.core.wmem_max = 268435456

# kernel command line (GRUB)
iommu=pt transparent_hugepage=madvise

# services
systemctl enable --now nvidia-persistenced
systemctl enable --now nvidia-fabricmanager   # NVSwitch (HGX) systems
cpupower frequency-set -g performance
Kubernetes & Docker für KI
Die meisten KI-Systeme, die wir bauen, laufen in Containern – von einer einzelnen Workstation mit Docker bis zu GPU-Clustern mit mehreren Knoten. Die Bausteine sind auf jeder Distribution dieselben.
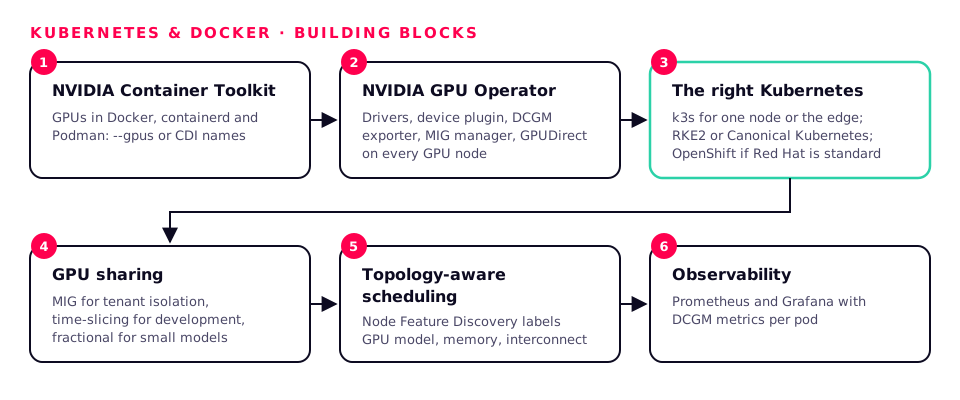
NVIDIA Container Toolkit
Gibt Docker, containerd und Podman Zugriff auf die GPUs, über das Flag --gpus oder CDI-Gerätenamen.
NVIDIA GPU Operator
Installiert und verwaltet Treiber, das Device-Plugin, den DCGM-Exporter, den MIG-Manager und GPUDirect-Komponenten auf jedem Kubernetes-GPU-Knoten.
Das passende Kubernetes
k3s für einen Knoten oder den Edge, RKE2 oder Canonical Kubernetes für Cluster, OpenShift, wo Red Hat der Standard ist.
GPU-Sharing
MIG für strikte Isolation zwischen Mandanten, Time-Slicing für die Entwicklung und fraktionales Scheduling für viele kleine Modelle.
Topologiebewusstes Scheduling
Node Feature Discovery kennzeichnet GPU-Modell, Speicher und Interconnect, sodass große Jobs auf den Knoten landen, die zu ihnen passen.
Observability
Prometheus und Grafana mit DCGM-Metriken: GPU-Auslastung, Speicher, Temperatur, Leistungsaufnahme und Fehler pro Pod.
Native LLM-APIs und wie sie skalieren
Wir stellen Modelle hinter OpenAI-kompatiblen APIs bereit, sodass es Anwendungen egal ist, welches Modell oder welche Engine dahintersteht. Skaliert wird dann in vier Richtungen.
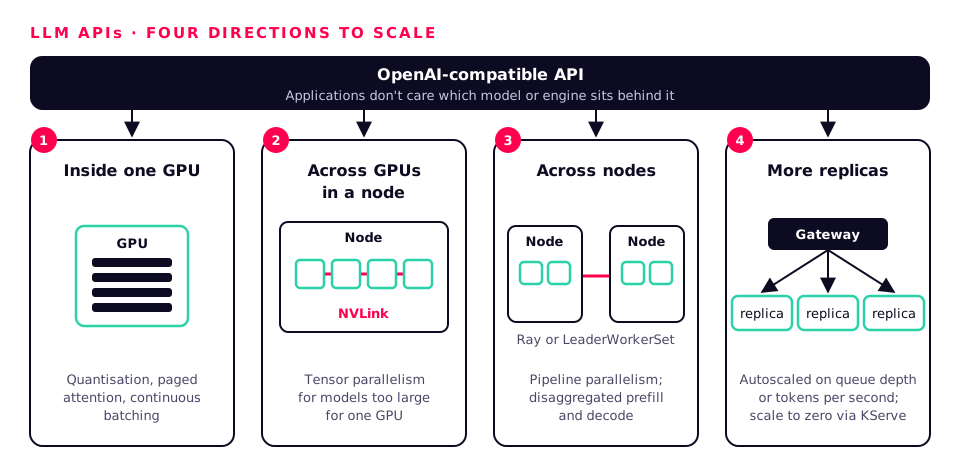
- 1
Innerhalb einer GPU
Quantisierung (FP8, NVFP4 auf Blackwell, AWQ), Paged Attention und Continuous Batching in vLLM, SGLang oder TensorRT-LLM bringen mehr Nutzer auf jede GPU.
- 2
Über GPUs in einem Knoten
Tensor-Parallelität über NVLink stellt Modelle bereit, die für eine GPU zu groß sind – mit der geringsten Latenz.
- 3
Über Knoten hinweg
Pipeline-Parallelität mit Ray oder Kubernetes LeaderWorkerSet für die größten Modelle sowie disaggregiertes Prefill und Decode (NVIDIA Dynamo, llm-d) im Cluster-Maßstab.
- 4
Mehr Replikate
Horizontale Skalierung hinter einem Gateway, automatisch skaliert nach Queue-Tiefe oder Tokens pro Sekunde mit KEDA oder dem HPA, mit KV-Cache-bewusstem Routing und Scale-to-Zero über KServe.
Engines, die wir einsetzen: vLLM, SGLang, TensorRT-LLM mit Triton Inference Server, NVIDIA NIM sowie Ollama oder llama.cpp für Systeme am Arbeitsplatz und am Edge. Viele LoRA-Adapter können sich ein Basismodell auf denselben GPUs teilen.
CI/CD für LLMs, Agenten und Datenpipelines
KI ändert sich häufiger als gewöhnliche Software: neue Modellversionen, neue Prompts, neue Daten. Wir geben jedem der drei eine eigene Pipeline, mit derselben Disziplin: alles versioniert, getestet, signiert und über Ringe ausgerollt.
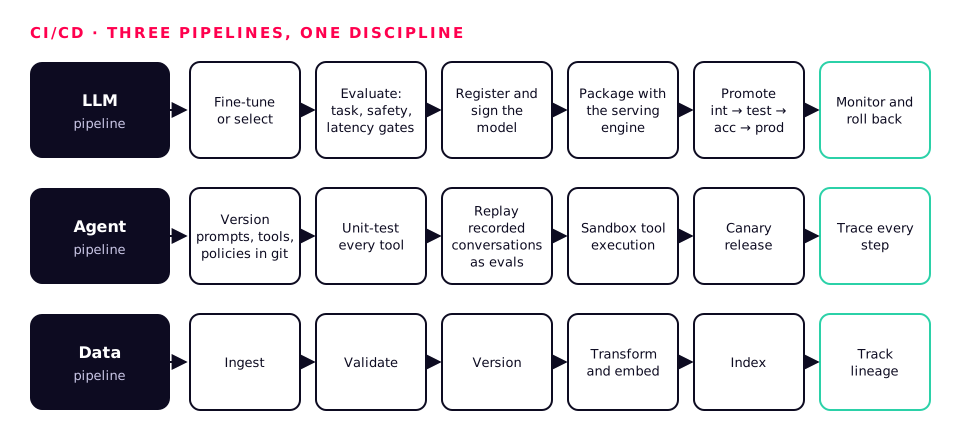
LLM-Pipeline
- Feintunen oder auswählen
- Anhand von Aufgaben-, Sicherheits- und Latenz-Gates bewerten
- Modell registrieren und signieren
- Mit der Serving-Engine paketieren
- Ausrollen int → test → acc → prod
- Überwachen und zurückrollen
Kubeflow oder Ray für das Training, MLflow-Registry, cosign-Signaturen, Argo CD für GitOps und Ring Promoter für zustandsgeprüfte Releases Ring für Ring.
Agenten-Pipeline
- Prompts, Tools und Richtlinien in git versionieren
- Jedes Tool mit Unit-Tests prüfen
- Aufgezeichnete Unterhaltungen als Evals wiedergeben
- Tool-Ausführung in einer Sandbox
- Canary-Release
- Jeden Schritt tracen
Containerisierte Tool-Sandboxes, Evaluierungssuiten in der CI, OpenTelemetry-Tracing, Kosten- und Ratenbudgets pro Agent.
Daten-Pipeline
- Aufnehmen
- Validieren
- Versionieren
- Transformieren und einbetten
- Indexieren
- Lineage nachverfolgen
Airflow, Dagster oder Argo Workflows; Great Expectations für die Validierung; lakeFS oder DVC für Versionen; Spark oder Ray für Skalierung; pgvector, Qdrant oder Milvus für Retrieval; OpenLineage für Lineage.
Die CI läuft auf selbst gehosteten Runnern in Ihrem Netzwerk, einschließlich GPU-Runnern für die Evaluierung, sodass Modelle und Daten es nie verlassen.
Wie wir Linux für KI absichern
Ein KI-Server enthält Ihre wertvollsten Daten und einige Ihrer teuersten Hardwarekomponenten. Wir sichern ihn in Schichten ab, damit kein einzelner Fehler das eine oder das andere preisgibt.
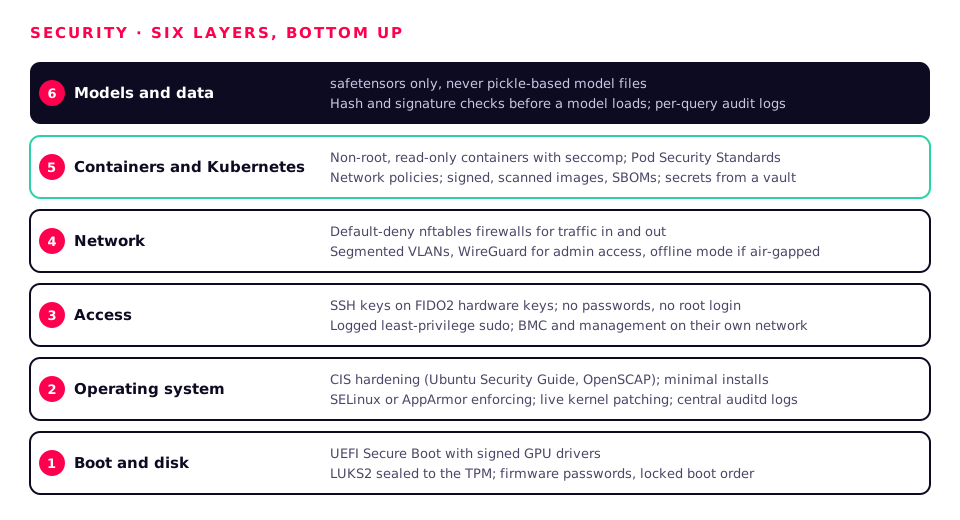
01
Boot und Datenträger
- UEFI Secure Boot mit signierten GPU-Treibern
- Vollständige Festplattenverschlüsselung (LUKS2), an das TPM gebunden, mit unbeaufsichtigtem Neustart
- Firmware-Passwörter und gesperrte Boot-Reihenfolge
02
Betriebssystem
- Härtung nach CIS-Benchmark (Ubuntu Security Guide, OpenSCAP)
- SELinux oder AppArmor im Enforcing-Modus
- Minimalinstallationen und Live-Kernel-Patching
- auditd-Protokollierung in einen zentralen Speicher
03
Zugriff
- SSH-Schlüssel auf FIDO2-Hardwareschlüsseln, keine Passwörter, kein Root-Login
- sudo nach dem Prinzip der geringsten Rechte, mit Protokollierung
- BMC und Management in einem eigenen Netzwerk
04
Netzwerk
- Firewalls mit Default-Deny (nftables) für ein- und ausgehenden Datenverkehr
- Segmentierte VLANs und WireGuard für den Admin-Zugriff
- Vollständiger Offline-Modus für Air-Gap-Standorte
05
Container und Kubernetes
- Container ohne Root, schreibgeschützt, mit seccomp-Profilen
- Pod Security Standards und Netzwerkrichtlinien
- Signierte Images, Schwachstellenscans und SBOMs
- Secrets aus einem Vault, nie in Images oder git
06
Modelle und Daten
- Nur safetensors, nie Pickle-basierte Modelldateien
- Hash- und Signaturprüfungen, bevor ein Modell geladen wird
- Audit-Protokolle pro Abfrage und Zugriff auf Mandats- oder Mandantenebene
Unterstützt vom Workstation-Team
Wählen Sie die Distribution, die zu Ihrer Organisation passt, und wir liefern sie bereit für KI-Arbeit – und halten sie in diesem Zustand.
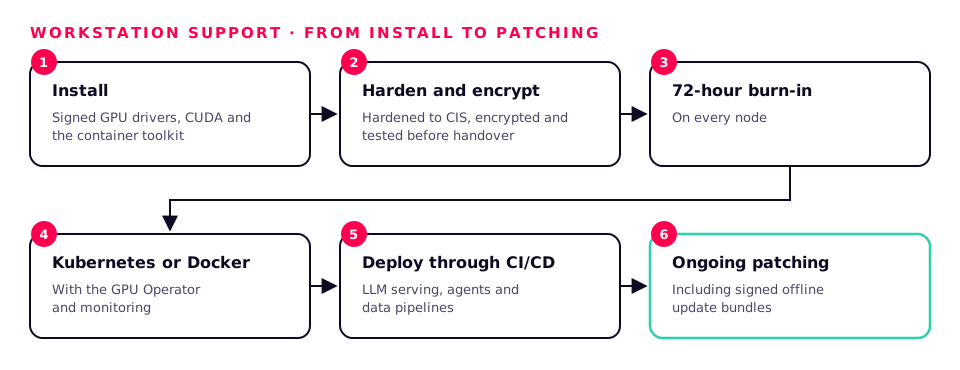
- Installiert mit signierten GPU-Treibern, CUDA und dem Container-Toolkit
- Nach CIS gehärtet, verschlüsselt und vor der Übergabe getestet
- 72-Stunden-Burn-in für jeden Node
- Kubernetes oder Docker eingerichtet, mit GPU Operator und Monitoring
- LLM-Serving, Agenten und Datenpipelines über CI/CD bereitgestellt
- Laufendes Patching, einschließlich signierter Offline-Update-Pakete
Logos sind Marken ihrer jeweiligen Inhaber und werden nur verwendet, um die von uns unterstützten Produkte zu kennzeichnen. Die Logos von Debian, Rocky Linux und AlmaLinux werden unter CC-BY-SA-Lizenzen von Wikimedia Commons verwendet.