Gemini 4 Argon: Was es für Ihr Team bedeutet und wo Sie es zuerst einsetzen sollten
Googles Frontier-Modell für langfristiges Programmieren, Wissensarbeit und Cyberabwehr: was veröffentlicht wurde, was es kostet und mit welchen fünf Workflows wir beginnen würden
 Balinder Walia18. Oktober 20266 min read
Googles Gemini 4 Argon ist ein Frontier-Modell, das dafür gebaut ist, lange an einem schwierigen Problem zu arbeiten: eine Codebasis migrieren, Schwachstellen patchen oder eine Finanz- oder Rechtsfrage von Anfang bis Ende recherchieren. Hier ist die Einschätzung von Workstation: was veröffentlicht wurde, was es kostet, wo es neben den Modellen steht, die Sie bereits betreiben, und für welche Workflows wir es zuerst einsetzen würden. Code, Diagramme und zehn ausgearbeitete Workflows finden Sie im ausführlichen Artikel.
gemini-4-argon) teilt ein einziges Fenster von 1M Tokens zwischen Eingabe, Denken und Ausgabe, während frühere Gemini-Modelle die Ausgabe bei 64K Tokens beendeten. Es führt die von Google berichteten Ergebnisse bei langfristigem Software-Engineering (DeepSWE v1.1, 77,9%), Geschäftsautomatisierung (AutomationBench, 51,3%) und dem Verständnis langer Videos (LVBench, 91,7%) an und teilt sich den ersten Platz bei der Behebung von Schwachstellen (CWE-bench v1, 68%). Es ist jetzt in der kostenpflichtigen Stufe der Gemini API verfügbar, zu 2 $ / 10 $ pro Million Eingabe- / Ausgabe-Tokens bis zum 30. November, danach 4 $ / 20 $. Setzen Sie es dort ein, wo ein einziger langer, überprüfbarer Lauf Tage menschlicher Arbeit ersetzt. Behalten Sie für das Volumen ein schnelles Modell.
Für die Leser von Workstation neu verfasst auf Grundlage von Googles Ankündigung Gemini 4 Argon: our next era of frontier intelligence (30. Sep. 2026) und dem Entwicklerleitfaden von AI Studio (13. Okt. 2026). Die Benchmark-Werte stammen von Google selbst; prüfen Sie die aktuellen Preise, bevor Sie budgetieren.
Was tatsächlich veröffentlicht wurde
- 30. September: angekündigt und zunächst über Googles Fairwind Program für geprüfte Cyberverteidiger freigegeben, während die Schutzmaßnahmen getestet wurden.
- 13. Oktober: verfügbar für Entwickler in der kostenpflichtigen Stufe der Gemini API (Google AI Studio, Android Studio), für Abonnenten von Google AI Ultra und in Google Antigravity, Googles agentenzentrierter Entwicklungsplattform.
- Ein Fenster für alles: Eingabe, Denken und Ausgabe teilen sich 1M Tokens. Die Ausgabe ist standardmäßig auf 64K begrenzt. Darüber führen Sie die Anfrage im Hintergrund aus („Long Decode“), und das Modell kann komplette Diffs über mehrere Dateien, Testsuiten oder Beweise in einem Durchgang zurückgeben.
- Drei Denkstufen:
lowfür Routing und Extraktion,medium(Standard) für alltägliches Programmieren und Tool-Nutzung,highfür Ursachenanalyse beim Debugging, Sicherheitspatches und Architektur.
Die Zahlen, die Google berichtet hat
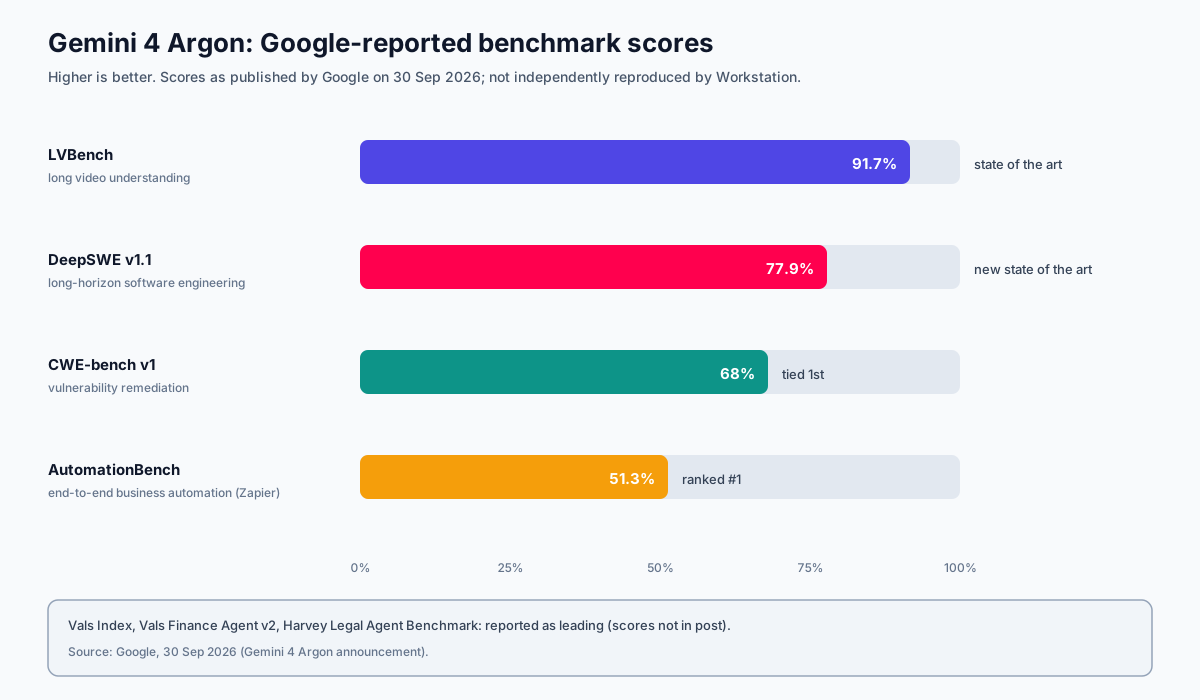
Benchmarks sagen nur begrenzt etwas aus. Die internen Ergebnisse sind nützlicher, weil sie Arbeit beschreiben, für die ein Unternehmen bezahlen würde:
- Arbeitsspeicher: Ein Team von Argon-Agenten las flottenweite Profiling-Daten und wendete Optimierungen an, die in Googles Rechenzentren über 300 TiB Arbeitsspeicher freigaben; insgesamt werden 500 TiB bis 1 PiB erwartet.
- Migrationen: Argon-Agenten portieren bei Google C und C++ nach Rust, von Bibliotheken mit Zehntausenden Zeilen bis zum Fuchsia-Zircon-Kernel mit über 800K Zeilen. Jede Portierung durchläuft vor der Produktion automatisierte und manuelle Audits, Emulationstests und Reviews.
- Leistung: Bei libgav1, Googles Open-Source-Videodecoder, ersetzte Argon 32K Zeilen handgeschriebenen SIMD-Code durch sicheres Rust, das der Compiler selbst vektorisiert. Das Ergebnis ist 2,7-mal schneller als die frühere Rust-Portierung, bei identischer Ausgabe.
- Forschung: Bei einer Subroutine für Quantencomputing übertraf es die veröffentlichte Ressourcen-Baseline innerhalb von Minuten um 40%.
Warum das für Unternehmensinhaber wichtig ist
- Backlog-Arbeit, für die nie Personal da ist. Legacy-Migrationen, Abhängigkeits-Upgrades, Performance-Aufräumarbeiten und Sicherheitsschulden sind langwierig, messbar und mühsam: genau die Art von Aufgabe, für die Argon trainiert wurde.
- Wissensarbeit über Formate hinweg. Es liest PDFs, Tabellen, Hauptbücher, Einreichungen und lange Videos gemeinsam und macht daraus einen Bericht, eine Redline-Fassung oder ein Dashboard. Laut Google führt es den Vals Finance Agent v2 und Harveys Benchmark für juristische Agenten an.
- Günstigere wiederholte Läufe. Gecachte Eingaben sind um 95% günstiger, und das Caching erfolgt automatisch. Agenten, die in jedem Durchgang dieselbe Codebasis oder dasselbe Richtlinienpaket erneut lesen, werden deutlich günstiger.
- Verteidigung, nicht nur Tempo. Es findet, validiert und patcht Schwachstellen. Wiz nutzte es, um eine kritische Sicherheitslücke in Krankenhaussoftware zu finden, die frühere Modelle übersehen hatten.
Warum das für Entwickler wichtig ist
- Geben Sie ihm ein Ziel und einen Test, und treten Sie dann zurück. Argon leistet seine beste Arbeit, wenn es sich an einem echten Signal überprüfen kann: Ihrer Testsuite, einem Benchmark-Skript, Browser-Screenshots, Laufzeit-Logs.
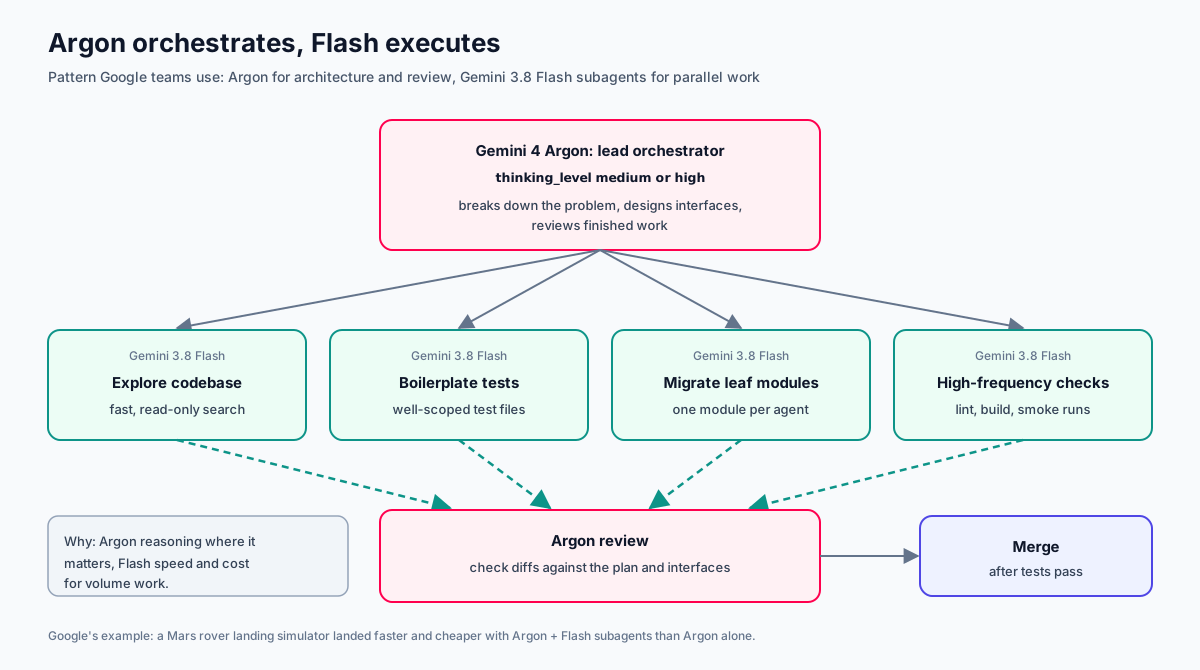
- Setzen Sie es als Leitung ein, nicht als ganzes Team. Googles eigene Ingenieure kombinieren Argon (Planung, Schnittstellen, Review) mit schnellen Gemini-3.8-Flash-Subagenten für die parallele, klar abgegrenzte Arbeit. Das ist schneller und günstiger als Argon allein.
- Aufräumen bei der Migration. Ersetzen Sie
thinking_budgetdurchthinking_level, entfernen Sietemperature/top_p/top_k(werden ignoriert), entfernen Sie explizite Kontext-Caches und erhöhen Sie die Client-Timeouts auf 15–20 Minuten oder führen Sie die Anfragen im Hintergrund aus.
Fünf Workflows, mit denen wir beginnen würden
| Workflow | Warum Argon | Die Prüfung, die es ehrlich hält |
|---|---|---|
| Migration eines Legacy-Moduls | Hält ein ganzes Subsystem im Kontext und iteriert stundenlang | Differenzielle Tests: alter und neuer Code liefern identische Ausgaben |
| Schwachstellen-Backlog | Findet, belegt und patcht in einer Schleife | Proof of Concept in einer Sandbox, danach Sicherheitsreview durch Menschen |
| Optimierung von Cloud-Kosten und Arbeitsspeicher | Liest Metriken aus mehreren Monaten und macht daraus konkrete Änderungen | Stufenweiser Rollout mit automatischem Rollback bei SLO-Verletzung |
| Finanzpaket zum Monatsabschluss | Gleicht Hauptbücher, PDFs und Tabellen miteinander ab | Jede Zahl verweist auf ihre Quellzelle; die Summen stimmen überein |
| Post-Mortem nach einem Vorfall | Sieht sich die Gesprächsaufzeichnung an und liest gleichzeitig die Dashboards | Die Zeitleiste stimmt minutengenau mit den Logs überein; der Verantwortliche zeichnet ab |
Alle zehn Workflows mit Prompts, Code und Pipeline-YAML finden Sie im ausführlichen Artikel.
Was es kostet, in einfachen Zahlen
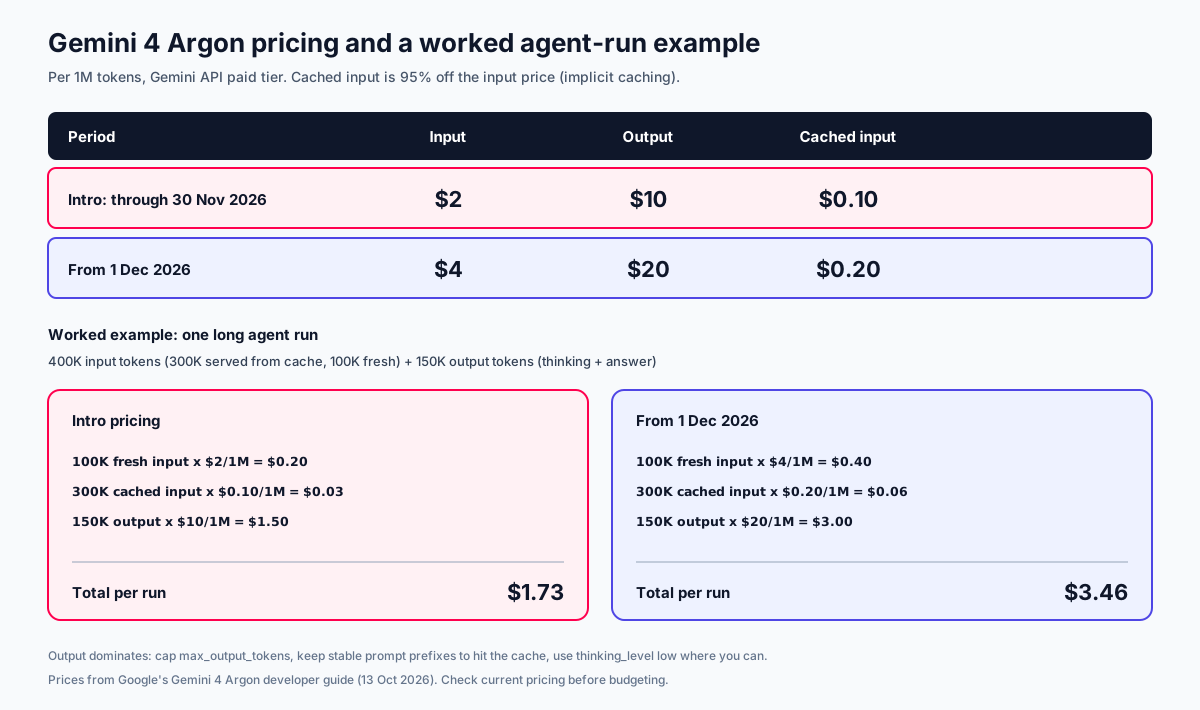
Ein typischer langer Agentenlauf, der 400K Tokens liest (davon 300K aus früheren Durchgängen gecacht) und 150K schreibt, kostet zum Einführungspreis etwa 1,73 $ und ab dem 1. Dezember 3,46 $. Das Geld fließt in die Ausgabe; begrenzen Sie daher max_output_tokens bei jedem Hintergrundlauf und lassen Sie die Volumenarbeit auf einem günstigeren Modell laufen.
Sicherheit: Was Google getan hat und wofür Sie weiterhin verantwortlich sind
Google bindet Argon an vier Schutzmaßnahmen: Missbrauch ablehnen (Cyber und CBRN) und gleichzeitig legitime Dual-Use-Forschung zulassen, Prompt-Injection widerstehen (es führt den Benchmark von Gray Swan für indirekte Prompt-Injection an), seine Gedankenkette und Aktionen auf Fehlausrichtung überwachen und es bei Hochrisikotests in abgeschotteten Sandboxes betreiben. Nichts davon ersetzt Ihre eigenen Kontrollen. Geben Sie Agenten Schlüssel mit minimalen Rechten, halten Sie nicht vertrauenswürdige Inhalte von Anweisungen getrennt, isolieren Sie alles, was Code ausführt, in einer Sandbox, und verlangen Sie, dass ein Mensch alles freigibt, was sich nicht rückgängig machen lässt. Unser Leitfaden zur Agentensicherheit und die QA-Gates von Ring Promoter zeigen, wie wir das in der Praxis umsetzen.
Die Sicht von Workstation
- Routen statt ersetzen. Argon übernimmt die Leitung bei langen, überprüfbaren Aufgaben. Schnelle Modelle erledigen Chat, Klassifizierung und Teilaufgaben. Siehe unseren Leitfaden zum Modell-Routing; derselbe Ansatz gilt anbieterübergreifend.
- Messen, bevor Sie vertrauen. Lassen Sie es mit einem Ausgangswert auf Ihrem eigenen Repository und Ihren eigenen Dokumenten laufen, nicht anhand einer Bestenliste.
- Über Gates ausliefern. Die Ausgabe von Agenten durchläuft int → test → acc → prod wie jede andere Änderung.
Sie möchten Unterstützung bei einem Argon-Pilotprojekt mit einem echten Backlog? Sprechen Sie mit Workstation. Wir wählen einen messbaren Workflow aus, bauen das Verifikations-Harness und lassen ihn durch Ihre normalen Release-Gates laufen.