Le 21 octobre 2026, à la GTC Berlin, Jensen Huang a déclaré à l'assistance que le débat sur l'infrastructure n'était plus le plus intéressant. Les usines, la pile CUDA et les GPU constituaient la fondation. La question qu'il a posée ensuite était de savoir quoi en faire. Des ingénieurs de Workstation étaient dans la salle à STATION-Berlin. Voici ce qu'il a dit, vérifié par rapport à la transcription de la keynote publiée par NVIDIA, et ce que cela signifie si vous achetez des machines plutôt qu'un campus d'un gigawatt.
L'IA est devenue productive cette année
La formule de Huang était simple. Au cours de l'année écoulée, l'IA est devenue productive. Il a rappelé le début de l'année, lorsque NVIDIA a parlé d'OpenClaw, un agent open source. C'est, selon lui, ce qui a lancé la tendance désormais visible partout : des agents qui pensent, raisonnent, itèrent et utilisent des outils.
Les agents utiles sont coûteux d'une manière bien particulière. Ils ne répondent pas une seule fois. Ils bouclent. Chaque boucle consomme des tokens. Davantage d'agents, utilisés par davantage de personnes, chacun consommant de nombreux tokens pour réfléchir : voilà pourquoi, selon lui, la consommation de tokens et la demande de GPU ont toutes deux explosé. Il n'a pas présenté de graphique de tokens dans ce passage. L'affirmation est une tendance : ce sont les charges de travail des agents qui constituent la demande, et non une simple fenêtre de chat.
Cinq éléments, pas un seul modèle
Il a ensuite défini un agent comme cinq choses. Le modèle est le modèle de langage qui s'exécute sur des GPU et produit les tokens que l'agent consomme. Il l'a appelé l'exosquelette. Le harnais est le programme qui planifie et appelle les outils. Le harnais se trouve dans un bac à sable, qui l'isole du reste du système. Les deux autres éléments sont les connaissances et les outils.
Sa propre liste, dans l'ordre qu'il a retenu : modèles, bac à sable, harnais, connaissances et outils.
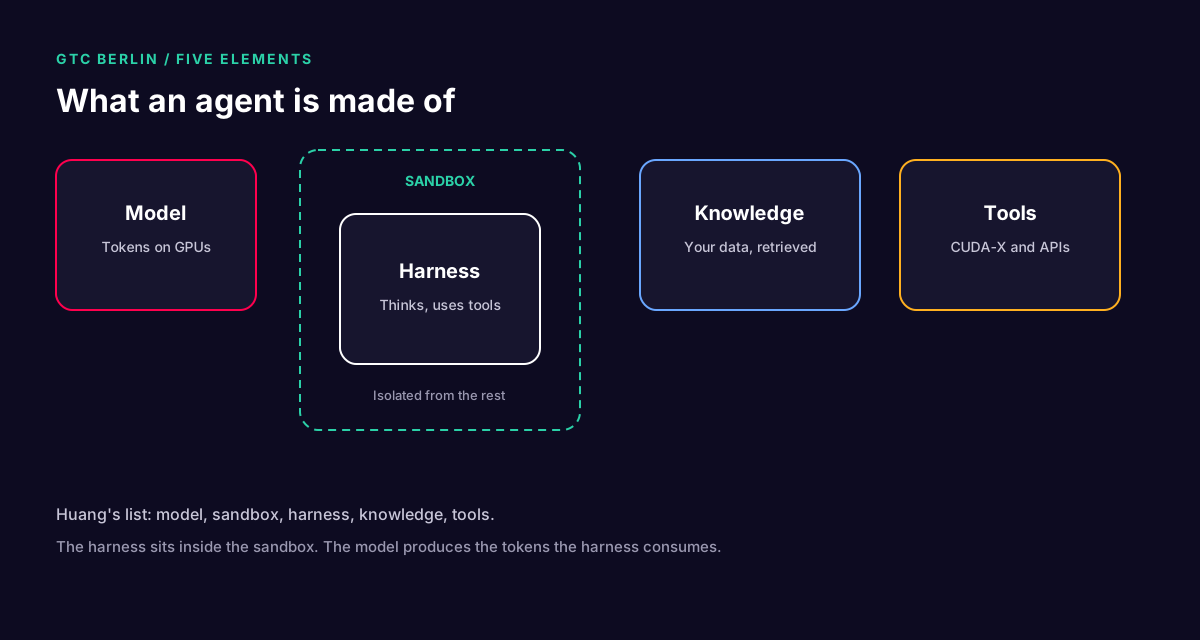
Cette séparation est la partie utile pour un acheteur. Un GPU plus gros n'alimente que le modèle. Il ne décide pas de ce que le harnais peut toucher, des connaissances qu'il peut voir ni des outils qu'il peut appeler. Ce sont des systèmes distincts. La phrase suivante de Huang était que l'agent doit être sécurisé avant d'être utile, car il est autonome et peut accéder aux fichiers, aux réseaux et aux outils. Les privilèges doivent être minimaux, et quelqu'un doit le surveiller. C'est l'annonce d'OpenShell, traitée dans l'article associé.
Ce que le reste de la keynote a construit sur cette base
Trois autres idées reposaient sur le même cadre.
- Des modèles ouverts que vous pouvez réentraîner. Nemotron pour le langage, Cosmos pour les modèles du monde, GR00T pour la robotique, Alpamayo pour la conduite autonome et Earth-2 pour la physique. Huang a déclaré que NVIDIA fournit les poids, les données et les scripts, afin qu'un laboratoire puisse voir d'où vient le modèle. Il a clairement indiqué que les modèles de langage ne sont pas automatiquement à la pointe tant qu'un partenaire ne les a pas post-entraînés sur des données privées.
- Une fondation de connaissances. Les documents non structurés passent par Nemotron Parse, Nemotron Embed, cuVS et Nemotron Rerank. Les données structurées passent par Auto-Ontology, puis cuDF pour l'analyse et Kumo pour la prédiction. Son exemple concret était un retard fournisseur dans un document, des commandes en SQL et la recherche d'une pièce de remplacement.
- L'usine en dessous. NVIDIA DSX est la conception de référence d'usine d'IA full-stack : calcul, réseau, stockage, logiciel, alimentation et refroidissement, en partant d'un jumeau numérique. La diapositive sur l'Europe empilait les applications, les modèles, les usines d'IA, le calcul NVIDIA et l'énergie.
Ce que cela signifie sur une station de travail
La plupart des entreprises présentes dans la salle ne construiront pas cette année une salle Vera Rubin NVL72. Elles exécuteront un harnais, un bac à sable et un modèle qui tient sur un bureau ou dans un seul rack. Le schéma à cinq éléments s'applique tout de même.
- Le modèle peut être Nemotron, une API fermée, ou les deux. Huang a déclaré que chaque entreprise utilisera des modèles fermés et des modèles ouverts, et personnalisera là où le travail est propriétaire.
- Le harnais peut être OpenClaw, Hermes, OpenHands, une pile LangChain ou Deep Agents, ou du Python que vous écrivez. Il les a cités comme moyens de construire le harnais qui s'exécute désormais dans OpenShell.
- Les connaissances, ce sont vos documents et votre base de données, et non une exploration générique du web.
- Les outils sont l'endroit où CUDA-X compte encore : les bibliothèques qu'un agent appelle lorsque la tâche relève de la science, de l'ingénierie ou d'un fichier de conception, et non d'un paragraphe de chat supplémentaire.
Une configuration Workstation adaptée à ce schéma est une machine Linux ou un Mac Studio avec suffisamment de mémoire pour le modèle, un environnement d'exécution en bac à sable et un emplacement pour conserver les documents et le SQL. L'histoire de l'usine concerne le moment où le débit de tokens ne tient plus dans une seule machine. La conclusion de Huang sur l'architecture de référence était que les agents pensent sur Rubin, agissent sur Vera et sont gouvernés sur BlueField. C'est une phrase de centre de données. Les cinq éléments sont la partie que vous pouvez démarrer sur une seule machine.
Des chiffres que nous ne présentons pas comme les nôtres
La salle de presse de NVIDIA a indiqué le même jour que Vera Rubin NVL72 offre 30 fois le débit par mégawatt de la génération précédente sur les charges de travail d'agents, que les CPU Vera offrent deux fois les performances du x86 avec une meilleure efficacité, et que Sentry sur BlueField-4 peut augmenter la capacité des agents jusqu'à 20 %. Ce sont les chiffres de NVIDIA, issus de leur communiqué, et non un benchmark de Workstation. La keynote a également affirmé que Vera Rubin représente encore 30 fois Blackwell en deux ans. Même règle : citez-le comme provenant de NVIDIA.
Les articles techniques détaillés qui suivent celui-ci traitent d'OpenShell et Sentry, de la fondation de connaissances, ainsi que de DSX et la pile européenne.
Une boucle, pas une réponse
Une réponse de chat correspond à un seul appel. Un agent est une chaîne. Le modèle lit une longue invite, écrit un appel d'outil, le harnais exécute l'outil, et le résultat est réinjecté dans l'invite suivante. La « quantité énorme de tokens » évoquée par Huang, c'est cette chaîne, multipliée par le nombre d'agents en cours d'exécution. Il n'a pas dit qu'une équipe devient dix fois plus rapide. Il a dit que les machines sont plus sollicitées parce que le logiciel accomplit enfin un travail.
Si vous voulez un chiffre de planification, présentez-le comme une ébauche. Supposons qu'une exécution d'agent représente huit appels au modèle, et qu'une personne lance vingt exécutions par jour. Cela fait 160 appels là où un chatbot en aurait fait 20. Les GPU ne sont pas devenus plus lents. La forme du travail a changé. Modifiez le 8 ou le 20 et l'ébauche change. Ne la citez pas comme un benchmark.
Ce qu'il faut noter avant d'acheter
Reportez les cinq éléments sur une feuille avant de choisir un GPU.
- Modèle. Quels poids, avec quelle précision, et quelle longueur de contexte vous enverrez réellement. La VRAM en découle. Un modèle de 70 milliards de paramètres en 4 bits ne demande pas la même machine que le même modèle en 16 bits.
- Harnais. OpenClaw, Hermes, OpenHands, un framework ou votre propre Python. Le harnais est un logiciel que vous pouvez modifier. Ce n'est pas une référence de GPU.
- Bac à sable. OpenShell, ou un autre environnement d'exécution capable de dire non. Si vous l'omettez, les quatre autres éléments partagent un même ensemble de privilèges.
- Connaissances. Quels documents, quelle base de données, et qui est autorisé à les récupérer.
- Outils. Les quelques API et bibliothèques CUDA-X dont la tâche a besoin. Huang a déclaré que l'agent utile est celui qui peut appeler un véritable outil, et que ces outils expliquent pourquoi un GPU est plus rapide que l'exécution de la même bibliothèque sur un CPU. Il a parlé de 10, 50 ou 100 fois. C'était une fourchette énoncée sur scène, pas une publication.
Lorsque cette feuille tient sur une seule station de travail, achetez la station de travail. Lorsque le débit de tokens nécessite une salle, vous entrez dans la conversation DSX. Les deux peuvent être vrais au sein d'une même entreprise.
Sources
- Transcription à la demande de NVIDIA, keynote GTC Berlin 2026 SB61112 : nvidia.com
- Salle de presse NVIDIA, 21 octobre 2026, OpenShell Reference Architecture : nvidianews.nvidia.com
- Blog NVIDIA, notes en direct de la keynote : blogs.nvidia.com


