La première moitié de la keynote de Jensen Huang à la GTC Berlin, le 21 octobre 2026, était consacrée à l'usine. NVIDIA DSX est la conception de référence pour en construire une. Les diapositives derrière lui ont ensuite placé les entreprises européennes sur cette usine, par couches, ainsi qu'une roue de marchés autour d'une seule architecture CUDA. Des ingénieurs de Workstation ont photographié ces diapositives. Cet article décrit ce qu'elles contiennent, quels chiffres proviennent de NVIDIA et où se situe encore une machine de bureau.
Les puces seules ne font pas une usine
La phrase d'introduction de Huang : d'excellentes puces ne font pas une excellente usine d'IA. NVIDIA DSX est une architecture de référence full-stack, conçue avec des entreprises d'infrastructure, qui couvre le calcul, le réseau, le stockage, le logiciel, l'alimentation et le refroidissement comme un seul système. Elle commence dans un jumeau numérique, de sorte que le bâtiment est conçu avant d'être coulé. Il a également décrit DSX Max, une couche de contrôle, et une refonte du refroidissement. Un chiffre qu'il a avancé : à 2 gigawatts, DSX peut économiser 54 millions de litres d'eau par jour. C'est l'affirmation de NVIDIA lors de la keynote. Nous n'avons pas audité le modèle de consommation d'eau.
Le même jour, il a annoncé le DSX Pod : des racks Vera Rubin intégrés et câblés en usine, afin qu'un site n'ait pas à câbler une salle de commutateurs isolés. La transcription mentionne un ordre de grandeur de câbles Spectrum-X dans un DSX Pod Vera Rubin. Il a qualifié le résultat d'usine d'IA « responsable dès la conception », et a déclaré que les pods permettent de construire des usines à la vitesse de la lumière. Lisez « vitesse de la lumière » comme un slogan, pas comme un calendrier de construction.
Sur le saut de génération, il a déclaré que Vera Rubin représente encore 30 fois Blackwell en deux ans. La salle de presse, plus prudente, indique que Vera Rubin NVL72 offre un débit par mégawatt 30 fois supérieur sur les charges de travail agentiques. Les deux phrases sont celles de NVIDIA. Il ne s'agit pas d'une mesure de Workstation sur un modèle nommé.
Ce que montrait la diapositive de la plateforme DSX
Une diapositive était intitulée « The NVIDIA DSX Full-Stack AI Factory Platform ». En haut : les bibliothèques CUDA-X, les bibliothèques de plateforme et les modèles ouverts. Au sol, les racks étaient étiquetés ainsi, d'après la photographie :
- Vera Rubin NVL72
- Commutateur NVLink 6
- Calcul Vera BlueField-4
- Commutateur Spectrum-6
- un rack étiqueté Groq 3 LPX
- Stockage Vera BlueField-4
- Calcul Vera RTX
Le flanc du rack Rubin indiquait également Rubin, Vera, BlueField-4 et ConnectX-9. Nous listons les étiquettes que nous avons pu lire. Nous n'inventons ni vitesses de port ni puissance de rack pour les éléments dont la diapositive n'affichait pas ces valeurs sur la photographie.
Une architecture CUDA, six marchés
Une roue présentée plus tard était intitulée « One CUDA Architecture. Many Markets. Productive, Fungible, and Durable. » Le centre portait la mention « Full-Stack AI Factory ». Six segments l'entouraient. Les encadrés citaient des entreprises. Voici l'ensemble que nous avons pu lire, sans prétendre que la liste était exhaustive. L'encadré des startups indiquait lui-même « 10K+ ».
- Entreprises et industrie. Automobile, défense, santé, industrie manufacturière, énergie, services financiers, jeux vidéo, secteur public, commerce de détail et logistique, médias et divertissement, supercalcul, télécommunications.
- Fournisseurs de cloud. AWS, Google Cloud, Microsoft Azure, Oracle Cloud, Meta, SpaceX Super Intelligence.
- Natifs de l'IA. Une longue liste de startups, dont AMI Labs, Black Forest Labs, Cognition, Cohere, Cursor, ElevenLabs, Figure, Harvey, Hugging Face, Inception Labs, Ineffable, Inherent Labs, Lovable, Mistral, Perplexity, Physical Intelligence, Reflection, Runway, Sakana, SSI, Thinking Machines Lab.
- Néoclouds. Baseten, CoreWeave, Crusoe, Firebird, Fireworks, Firmus, GMI, IREN, Lambda, Mistral, Nebius, Nscale, Together AI, Volta.
- ODM et OEM. ASUS, Bull, Dell, Foxconn, Gigabyte, HPE, Inventec, Lenovo, Pegatron, Quanta, Supermicro, Wistron, Wiwynn, et d'autres sur la même carte.
- Laboratoires d'IA. Anthropic, Gemini, Meta, OpenAI, SpaceX Super Intelligence.
Fongible, selon l'explication donnée plus tôt par Huang, signifie que la même base installée exécute l'entraînement, l'inférence et le modèle suivant, parce que l'écosystème logiciel est déjà en place. Durable signifie que cette base installée n'est pas jetée à chaque génération. Productif est le mot qu'il a réservé aux agents.
L'Europe, en cinq bandes
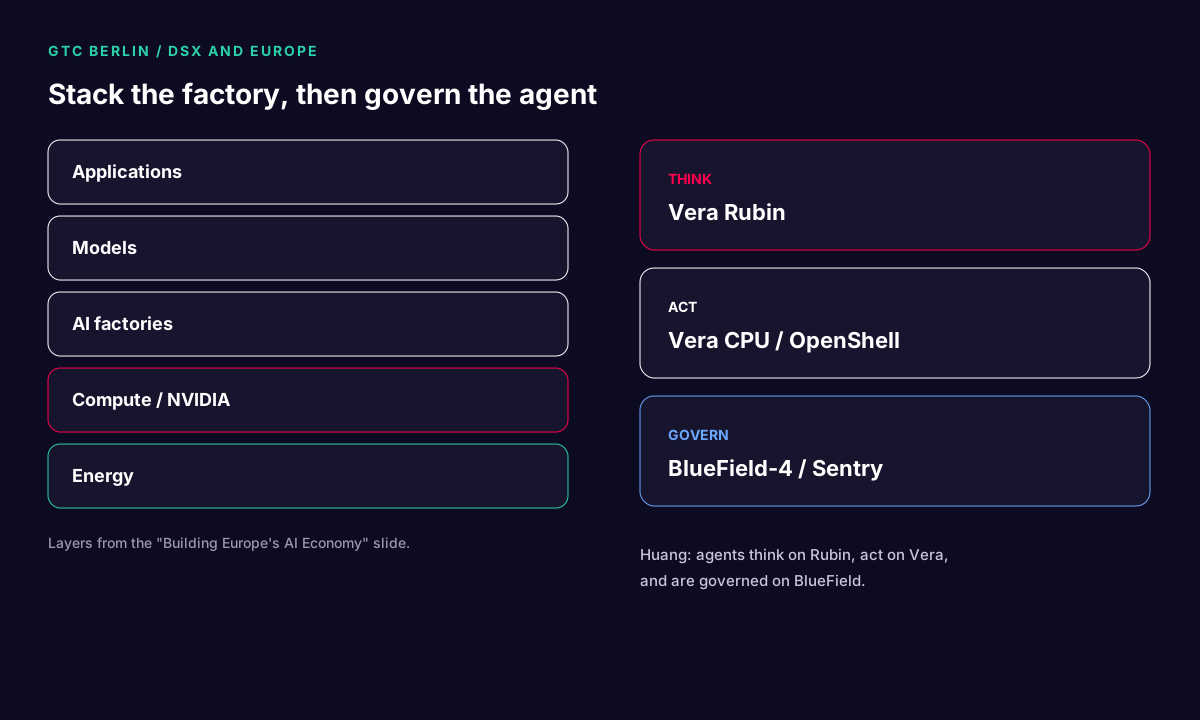
La diapositive intitulée « Building Europe's AI Economy » était une pile, pas une carte. D'après la photographie :
- Applications. Un large ensemble d'entreprises de produits européennes et internationales. Parmi les noms que nous avons pu lire figuraient DeepL, ElevenLabs, Helsing, des logos d'applications proches de Mistral, n8n, PhysicsX, Synthesia et Wayve, parmi beaucoup d'autres. La photo est dense. Considérez chaque logo comme « présent sur la diapositive », et non comme un partenariat avec Workstation.
- Modèles. Aleph Alpha et Mistral AI étaient lisibles, aux côtés d'autres laboratoires de modèles.
- Usines d'IA. Bull, Deutsche Telekom, Firebird, Mistral AI, Nebius, Nscale, Nokia, Radiant, Volta.
- Calcul. NVIDIA, seul dans cette bande.
- Énergie. Un logo SMR, Schneider Electric, Siemens Energy.
Où une station de travail a encore sa place
Le DSX Pod est un produit d'usine. La liste de la périphérie présentée dans la keynote constitue l'autre extrémité : RTX Spark, DGX Spark, DGX Station, avec OpenShell. La démonstration de Huang d'un robot sur RTX Spark, utilisant un harnais et des outils locaux et ne basculant vers le cloud que lorsque la tâche était importante, illustre le modèle intermédiaire entre ces deux extrémités.
Pour une équipe britannique, la répartition pratique est la suivante :
- Une seule machine lorsque l'agent, le bac à sable et les connaissances tiennent en mémoire et que le débit de tokens est à l'échelle humaine. Il s'agit d'une station de travail ou d'une machine de la classe DGX Spark.
- Un pod lorsque de nombreux agents, ou un grand entraînement, ont besoin du domaine NVLink, de la fabric Spectrum et de l'installation électrique. C'est DSX, et c'est un projet de construction.
- Un néocloud lorsque vous voulez les GPU pour un mois et non le bâtiment. Le segment néocloud de la roue est la liste de NVIDIA des acteurs qui mettent en place cette capacité, dont des sociétés comme Nebius, Nscale, Lambda et CoreWeave.
Aucun de ces choix ne supprime le bac à sable. Une usine sans OpenShell, selon l'argument de Huang lui-même, est un vaste endroit pour exécuter un agent que l'on ne peut contrôler qu'en le lui demandant poliment. L'article sur la sécurité se trouve ici. Le chemin des connaissances est ici. La vue d'ensemble de la keynote est ici.
Qui conçoit le bâtiment
Huang a cité les entreprises du parcours du jumeau numérique, qu'il convient de distinguer du mur de logos. PTC transforme les conceptions d'équipements en ressources utilisables par une simulation. Dassault Systèmes relie la conception des racks et des installations à l'ingénierie des systèmes basée sur les modèles. Schneider Electric simule la distribution électrique et le refroidissement liquide. Jacobs assemble les éléments dans un jumeau numérique Omniverse. Siemens évalue l'impact thermique, acoustique et sur le réseau électrique. Procore intervient à l'étape de planification de la construction. Il s'agit d'une chaîne de conception pour un bâtiment, et non d'une installation logicielle.
Concernant l'alimentation, il a décrit DSX Max comme une boucle de contrôle qui oriente l'énergie en fonction de la charge de travail, et a affirmé qu'elle consomme 30 % d'énergie en moins pour le même résultat. Concernant le refroidissement, les systèmes Vera Rubin sont conçus pour un refroidissement liquide en circuit fermé, avec un liquide jusqu'à 45 degrés Celsius, de sorte que, sous un climat adapté, des aéroréfrigérants secs extérieurs peuvent évacuer la chaleur sans évaporer d'eau. Les 54 millions de litres par jour sont le chiffre qu'il a associé à un site de 2 gigawatts capable d'éviter l'évaporation. Ces trois chiffres sont les siens, issus de la keynote. Un acheteur situé hors de ce climat, ou en dessous de cette échelle, ne devrait pas les reprendre dans une étude de rentabilité.
Questions à poser à un fournisseur d'usine
- Le pod est-il câblé et testé comme une unité, ou le site doit-il encore raccorder les liaisons Spectrum-X à la main ?
- Où se trouve le jumeau numérique, et laquelle de ces six entreprises figure réellement au contrat ?
- Quelle température du liquide de refroidissement la conception suppose-t-elle, et le climat local permet-il des aéroréfrigérants secs ?
- Où s'exécute OpenShell : sur les CPU Vera du pod, ou seulement sur la diapositive ?
Si les réponses sont vagues, vous êtes face à un achat de GPU auquel on a accolé le mot usine. La norme fixée par la keynote elle-même était plus exigeante.
Sources
- Transcription de la keynote, passages sur DSX et Vera Rubin : SB61112
- Chiffres de la salle de presse sur le débit par mégawatt, Vera par rapport au x86 et la capacité de Sentry : 21 octobre 2026
- Photographies de la diapositive de la plateforme DSX, de la roue des marchés CUDA et de « Building Europe's AI Economy », prises pendant la keynote.


