À la GTC Berlin, le 21 octobre 2026, Jensen Huang a interrompu la présentation des produits pour affirmer que l'agent doit être sécurisé avant d'être utile. Un agent est un système autonome qui a accès aux fichiers, aux réseaux et aux outils. Les privilèges que vous lui accordez doivent être minimaux, et vous devez le surveiller. La réponse de NVIDIA sur scène était OpenShell, avec Sentry sur BlueField-4 comme moniteur matériel. Cet article décrit le chemin des requêtes, dans l'ordre où la keynote et la note d'architecture de référence de NVIDIA le présentent.
Pourquoi une invite n'est pas un contrôle
Le film diffusé par Huang a fait passer le message sans laisser de place à la métaphore. Les entreprises s'attendent à déployer un grand nombre d'agents. Pour être utiles, ces agents vont raisonner, planifier, utiliser des outils, lire des données et travailler ensemble. Selon le film, la seule chose qui empêchait jusqu'ici un agent d'abuser de cet accès était de le lui demander poliment : s'il vous plaît, ne supprimez rien, s'il vous plaît, ne poussez pas sur main, s'il vous plaît, ne touchez pas aux clés SSH. La phrase de Huang après le film : l'espoir n'est pas une sécurité. La sûreté, c'est de l'ingénierie.
OpenShell est cette ingénierie, à la frontière du système d'exploitation. Vous rédigez une politique définissant ce que chaque agent peut toucher. OpenShell l'applique au niveau des appels système, de l'accès aux fichiers et des connexions réseau. Toute proposition de modification de politique est vérifiée, par vérification formelle, par rapport à un plafond d'autorisations, de sorte qu'une modification ne puisse pas discrètement accorder plus que ce que vous aviez prévu.
L'analogie du navigateur dans le film est la bonne. Les premières pages web pouvaient faire beaucoup trop de choses jusqu'à ce que le navigateur refuse. OpenShell applique la même démarche aux agents. Le refus intervient en dehors du modèle. Un garde-fou dans l'invite n'est pas le contrôle.
Le chemin d'un appel sortant
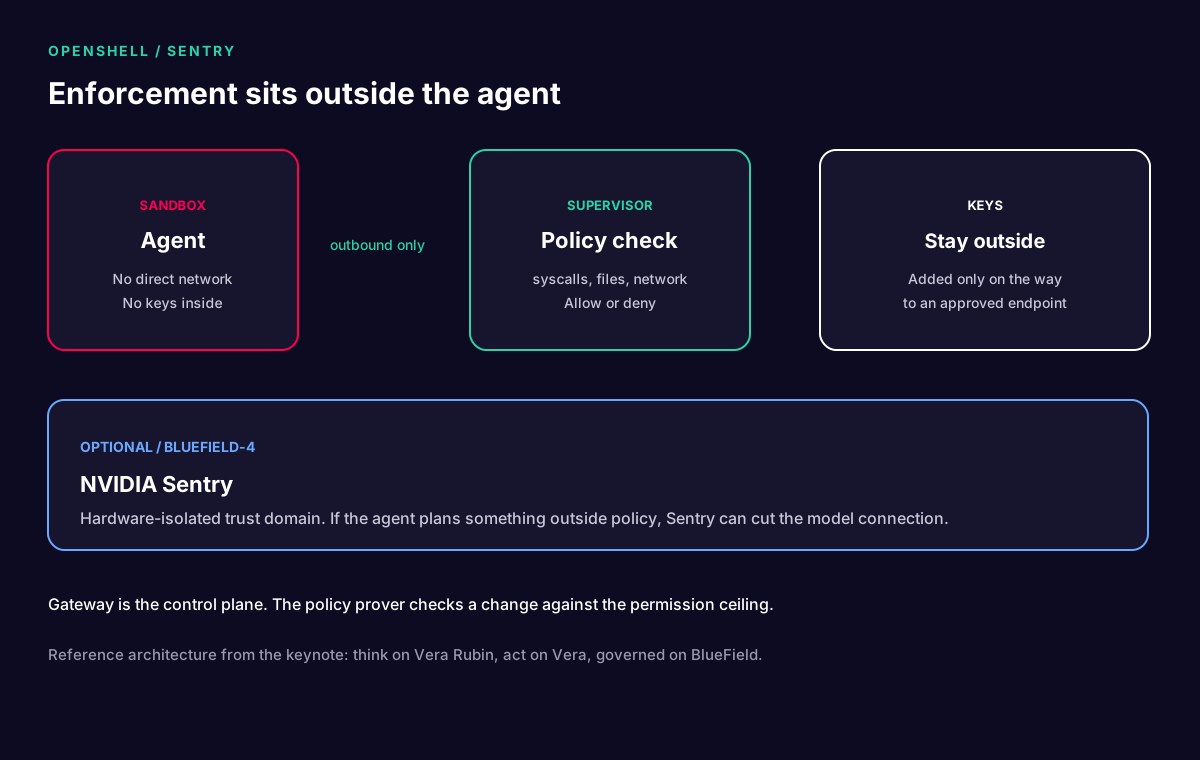
Chaque agent s'exécute dans son propre bac à sable. Le bac à sable n'a aucune route directe vers le réseau. Chaque requête sortante passe par un superviseur situé hors du bac à sable. Le superviseur vérifie l'action par rapport à la politique. Si elle n'est pas autorisée, elle est refusée.
Les clés restent chez le superviseur. Elles ne sont ajoutées qu'en route vers un point de terminaison approuvé. Un agent compromis ne peut pas divulguer une clé qu'il n'a jamais détenue.
Quatre rôles, tels que le film les a nommés :
- Passerelle. Le plan de contrôle.
- Superviseur. Prend la décision d'autoriser ou de refuser.
- Bac à sable. Contient l'agent.
- Vérificateur de politique. Vérifie une politique proposée par rapport au plafond d'autorisations.
Sentry, hors de l'hôte visible par l'agent
OpenShell lui-même repose sur l'isolation du noyau Linux et une politique d'exécution. Sentry est optionnel et se situe plus loin. Il s'exécute sur NVIDIA BlueField-4, dans un domaine de confiance isolé matériellement, sur le chemin entre l'agent et le modèle. L'article technique de NVIDIA indique que BlueField-4 se trouve sur le chemin d'E/S entre les agents exécutés sur Vera et les modèles qu'ils appellent. Sentry, construit sur DOCA, surveille ce chemin.
Comme le trafic de raisonnement passe par Sentry, un plan qui sort de la politique peut être stoppé en coupant la connexion au modèle. Huang a déclaré que cette mise en quarantaine se fait en quelques millisecondes. Sentry conserve également des enregistrements infalsifiables pour la détection, l'investigation et la réponse. Il ne dépend pas de ce que l'agent rapporte sur lui-même.
La salle de presse de NVIDIA ajoute deux chiffres que nous ne mesurons pas à nouveau : Sentry sur BlueField-4 peut augmenter la capacité des agents jusqu'à 20 %, car le travail de sécurité est déporté hors de l'hôte, et une mise en quarantaine se fait en quelques millisecondes. Considérez ces deux chiffres comme des affirmations de NVIDIA.
Penser, agir, gouverner
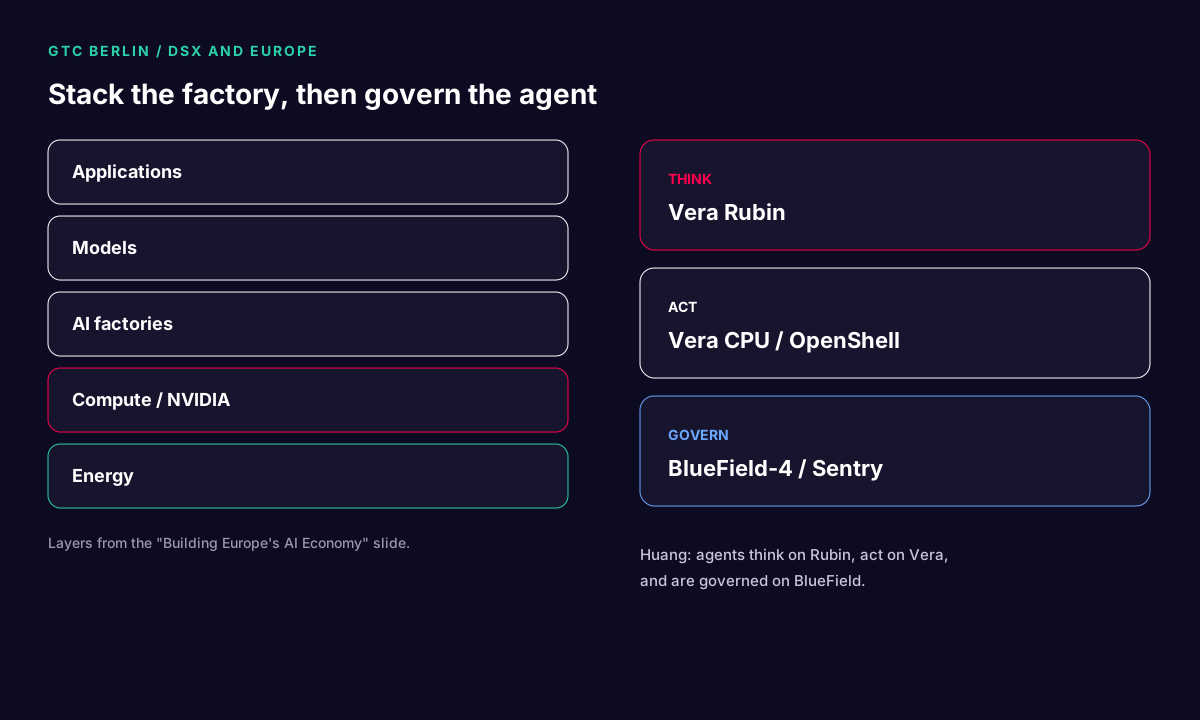
L'architecture de référence annoncée le même jour attribue ces tâches à trois ordinateurs.
- Vera Rubin exécute les modèles, y compris des modèles fermés et des modèles ouverts construits avec Nemotron. NVIDIA indique que Vera Rubin NVL72 peut être utilisé pour le pré-entraînement, le post-entraînement et l'inférence, et annonce un débit par mégawatt 30 fois supérieur sur les charges de travail d'agents. Ce chiffre est le leur.
- Les CPU Vera exécutent le harnais et les outils, dans OpenShell. NVIDIA indique que Vera offre deux fois les performances du x86 avec une meilleure efficacité. Là encore, c'est leur chiffre.
- BlueField-4 exécute Sentry.
La phrase de Huang dans le communiqué : les agents peuvent penser sur Rubin, agir sur Vera et être gouvernés sur BlueField. La même pile logicielle est présentée comme atteignant la périphérie sur RTX Spark, DGX Spark et DGX Station, et comme fonctionnant sur Canonical, SUSE, Red Hat, ainsi que sur Microsoft Windows avec Microsoft Execution Containers. Les systèmes d'exploitation cloud d'AWS, de Google Cloud et d'Azure figurent sur la même liste.
Les privilèges changent à chaque lancement
Huang a pris une minute pour expliquer pourquoi une liste d'autorisations statique échoue. Chaque tâche, chaque personne et chaque capacité requiert un privilège différent. Chaque lancement est différent. La politique, son application et la surveillance doivent être dynamiques. C'est la partie qu'il a qualifiée de révolutionnaire : non pas une seule image de bac à sable pour toute l'entreprise, mais une politique décidée au démarrage de chaque agent.
Il a également précisé que l'enjeu n'est pas seulement que les fournisseurs de modèles utilisent OpenShell lorsqu'ils hébergent des agents. Les entreprises qui reçoivent ces agents ont besoin du même environnement d'exécution, afin qu'un agent puisse fonctionner au sein de l'entreprise sans hériter de l'ensemble de son réseau.
Les harnais, et la ligne sur Anthropic
OpenShell est le bac à sable. Le harnais est ce que vous y placez. Huang a cité OpenClaw, Hermes et OpenHands, ainsi que des harnais issus de LangChain et Deep Agents, ou du Python que vous écrivez vous-même. La transcription publiée de la keynote indique qu'Anthropic et NVIDIA s'associent « to create cloud OpenShell agents », et il a renvoyé à un article sur le site web. Nous n'en déduisons pas un nom de produit qu'il n'a pas employé.
Le logiciel est open source sous licence Apache 2.0, a-t-il dit, et il fonctionne de la périphérie au cloud. Dans le film, l'adoption tient en deux commandes : installer la CLI, créer un bac à sable, exécuter l'agent que vous utilisez déjà. Notre note précédente sur l'exécution de cette CLI sur Mac Studio et sur NVIDIA Linux présente le point de vue de l'opérateur. Cet article présente l'architecture de Berlin qui l'entoure.
Les entreprises citées par NVIDIA
Le communiqué du 21 octobre liste les entreprises qui travaillent avec l'architecture de référence. Nous reprenons leur liste, sans rien y ajouter. Systèmes d'exploitation et clouds : Canonical, SUSE, Red Hat, Microsoft, AWS, Google Cloud, Azure. Concepteurs de modèles : Anthropic, Cohere, Google, Meta, OpenAI, Perplexity, Reflection, SpaceX Super Intelligence. Sécurité : 1Password, Check Point, CrowdStrike, Cisco, F5, Fortinet, Microsoft, Okta, Palo Alto Networks, TrendAI, Zscaler. Banques qui l'explorent : BBVA et Santander. Logiciels d'entreprise : Cadence, Dassault Systèmes, IBM, SAP, Siemens, Synopsys, et Palantir avec des clients en production. SAP le connecte à Joule Studio. ServiceNow a indiqué qu'Arc, son agent à exécution longue, est gouverné par la ServiceNow Super Intelligence Control Tower et contrôlé par OpenShell, AI Passport transmettant la politique à OpenShell et à Sentry. Intégrateurs de systèmes : Dell, Cisco, HPE, Lenovo, Supermicro. Néoclouds et hébergeurs : CoreWeave, Crusoe, Firebird, Firmus, GMI Cloud, IREN, Lambda, Nebius, Nscale, Oracle Cloud Infrastructure, Vultr. Inférence et post-entraînement : Baseten, Deep Infra, Fireworks, Together AI.
La propre réserve de NVIDIA figure sous cette liste. De nombreux produits et fonctionnalités restent proposés « when-and-if-available ». Un logo sur une diapositive n'est pas une intégration disponible que vous pouvez commander lundi.
Ce qu'il faut configurer, dans l'ordre
Les « deux commandes » du film sont un point de départ, pas un modèle d'exploitation. Une équipe qui laissera des agents s'exécuter devrait procéder comme suit, et s'arrêter si une étape n'a pas de responsable.
- Nommez le harnais. OpenClaw, Hermes, OpenHands ou le vôtre. Une image de bac à sable par famille de harnais suffit pour commencer.
- Rédigez la politique la plus restreinte qui permet à la tâche du jour d'aboutir. Les fichiers qu'il peut lire. Les hôtes qu'il peut appeler. Les outils en lecture seule et les outils qui écrivent.
- Placez les secrets dans le superviseur, ni dans l'invite ni dans l'image.
- Effectuez un test hostile : une invite qui demande à l'agent de lire une clé, de contacter un nouvel hôte ou de supprimer un fichier en dehors de la liste d'autorisations. Le refus doit venir du superviseur, et non du modèle qui refuse en toutes lettres.
- Seulement ensuite, ajoutez Sentry si vous disposez de BlueField-4 sur le chemin vers le modèle. Sans ce DPU, OpenShell reste le contrôle. Sentry est la ceinture de sécurité supplémentaire décrite par NVIDIA, pas une exigence pour la CLI.
La politique dynamique est la partie qui fera mal si vous traitez OpenShell comme une liste d'autorisations unique pour toute l'entreprise. Huang a dit que chaque lancement peut nécessiter un privilège différent. Cela signifie que la politique est une entrée du lancement, versionnée à côté de la tâche, et non une page wiki datant de mars.
En quoi cela diffère d'un garde-fou
Un garde-fou examine du texte. Il peut laisser passer un appel d'outil poli et pourtant destructeur. OpenShell examine l'appel que le système d'exploitation s'apprête à effectuer. Les deux peuvent être actifs. Ils ne se substituent pas l'un à l'autre. Le portefeuille de cybersécurité de NVIDIA, que nous avons présenté séparément, comprend toujours Nemotron Safety et NeMo Guardrails. Le message de Berlin était que ceux-ci ne suffisent plus dès que l'agent dispose d'un shell.
Les systèmes en périphérie bénéficient de la même approche à plus petite échelle. Le communiqué cite RTX Spark, DGX Spark et DGX Station comme des emplacements auxquels s'étend l'architecture de référence. Une machine de bureau peut exécuter le bac à sable. Elle n'exécutera pas Vera Rubin NVL72. N'achetez pas une station de travail pour la présenter comme une usine d'IA.
Sources
- Transcription de la keynote, SB61112 : nvidia.com/on-demand
- Communiqué, 21 octobre 2026 : OpenShell Reference Architecture
- Article technique : How OpenShell secures agent workloads
- Projet OpenShell : github.com/NVIDIA/OpenShell


