La boutique est ouverte

Nous construisons les machines Workstation AI pour les sites web, les agents IA et l'entraînement de LLM — configurez-les et achetez-les en ligne.

Obtenir les prix pro
Produits IA
Labs IAAgents OpenAIAgents ClaudeGrok BotCRM natif Workstation AIMarketingTous les produits
Solutions IA
IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseStations de travail IAMatériel et logiciels NVIDIACalcul accéléré NVIDIAIA privéeCloud privé GPUClusters GPUIA en périphérieIA par secteur
Services IA
Modernisation des plateformesIngénierie numériqueFondations data et IAOpérations autonomesConseil IAAutomatisation DevOpsCybersécuritéDéveloppement logicielCréation d'agentsMise en place MLOpsLocation de GPUCloud privé GPU
À propos
EntrepriseNotre histoirePartenairesTémoignages clients
Centres de données IA
Centres de données IACloud privé GPUClusters GPULocation de GPU
Analyses IASérie JevLabo de benchmarksChoix de modèles
Notes techniques
Documentation
OS LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plateformes cloud d'IAAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryClouds et places de marché GPU
Centres de données IA privésPour les cabinets d'avocatsPour les cabinets comptablesPlateformes sur siteCloud entièrement sécurisé
OutilsRing PromoterJobshout
Actualités
Blog
Nous contacterSe connecter

Stations de travail IA, logiciels multi-agents IA, infrastructure GPU et solutions d'agents intelligents pour les entreprises modernes.

Nous contacter

Solutions IA

IA appliquéeAgents IAIA générativeAutomatisation par IAMontée en compétence IAOffres IA pour PMELaboratoire IA d'entrepriseIA par secteur

Produits

Tous les produitsCRM & ERP natifs Workstation AIMarketingAgents OpenAIRing PromoterJobshout

Entreprise

À proposEntrepriseCentres de données IAPourquoi WorkstationPartenairesTémoignages clientsTarifsContactTenthMatrix

Ressources

Analyses IANotes techniquesDocumentationOS LinuxPlateformes cloud d'IACentres de données IA privésBlogRechercherPlan du site
Bureau de Belgique
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Lun - Ven : 9h00 - 18h00 CET
+32 492 45 67 46
Siège social au Royaume-Uni
77-79 Marlowes, Hemel Hempstead HP1 1LFItinéraire : prenez la sortie 20 de la M25, Outer LondonN° d'entreprise: 11641870Lun - Ven : 9h00 - 18h00 GMT
+44 7515 356 146
Bureau de l'Inde
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Bureau de Taïwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Lun - Ven : 9 h 00 - 18 h 00, heure de Taïwan (GMT+8)
+886 926 892 701+32 492 45 67 46
Bureau en Estonie
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaLun - Ven : 9 h 00 - 18 h 00, heure d’Estonie (EET)
+32 492 45 67 46

© 2026 Workstation AI. Tous droits réservés.

ConfidentialitéSuppression des donnéesCookiesConditions d'utilisationPlan du site web

NVIDIA, le logo NVIDIA, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX et HGX sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays. AMD, le logo AMD Arrow, EPYC, Instinct, Ryzen et Threadripper sont des marques commerciales d'Advanced Micro Devices, Inc. Dell et PowerEdge sont des marques commerciales de Dell Inc. ou de ses filiales. Intel et Xeon sont des marques commerciales d'Intel Corporation ou de ses filiales. AMAX, AceleMax et LiquidMax sont des marques commerciales d'AMAX Engineering Corporation. Tous les autres noms de produits, logos et marques appartiennent à leurs propriétaires respectifs. Nous les utilisons uniquement pour identifier les produits que nous décrivons, fournissons ou prenons en charge ; leur utilisation ne signifie pas que leurs propriétaires nous cautionnent.

Loading blog...

Accueil / Blogs
AIMachine LearningLLMAwsMLOpsDevOpsKubernetes

Systèmes de deep learning : brief technique pour ingénieurs et agents

Apprentissage de représentations, voies discriminatives vs génératives, métriques et arbitrage acheter/construire — concepts AWS réécrits pour les équipes de production

Balinder Walia7 août 20262 min read
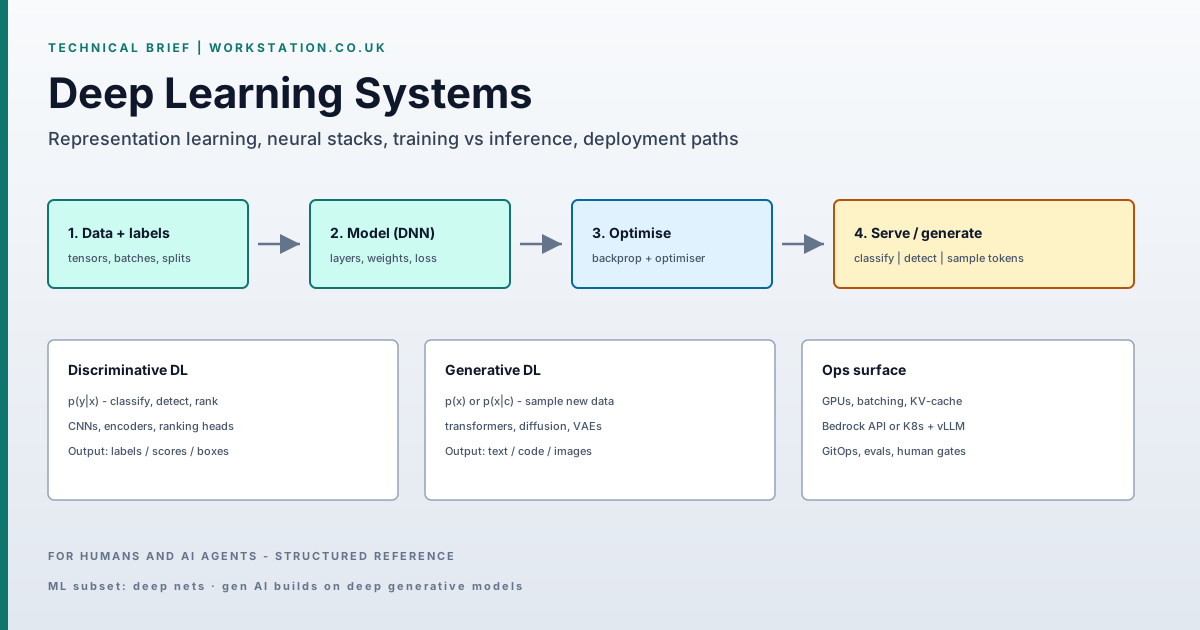
Deep learning systems technical brief — train, optimise, serve

Digest technique : le deep learning comme optimisation neuronale multi-couches, voies discriminatives vs génératives, et comment router le travail vers le ML classique, le DL entraîné ou les API de modèles de fondation. Équations complètes, figures et checklist agent dans le long article.

Brief technique systèmes deep learning — entraîner, optimiser, servir

Définition. Le deep learning est l’entraînement par gradient de réseaux de neurones profonds afin que f_θ(x) apprenne des caractéristiques hiérarchiques à partir d’un x haute dimension. Il sous-tend la vision/ASR/NLP modernes et est le substrat de l’IA générative (transformers / diffusion). Facteurs de coût : volume de données propres, temps d’accélérateur et OpEx d’inférence — pas les slides.
Digest agent. DL ⊂ ML. Discriminatif = p(y|x). Génératif = échantillonner x ou x|c. Préférer GBM pour de fortes features tabulaires ; entraîner le DL pour la perception ; utiliser Bedrock/vLLM pour les agents langage. Serving GitOps ; gater argent/auth/prod.

Adapté d’AWS — What is Deep Learning? — pour les équipes d’ingénierie Workstation.

Répartition des capacités
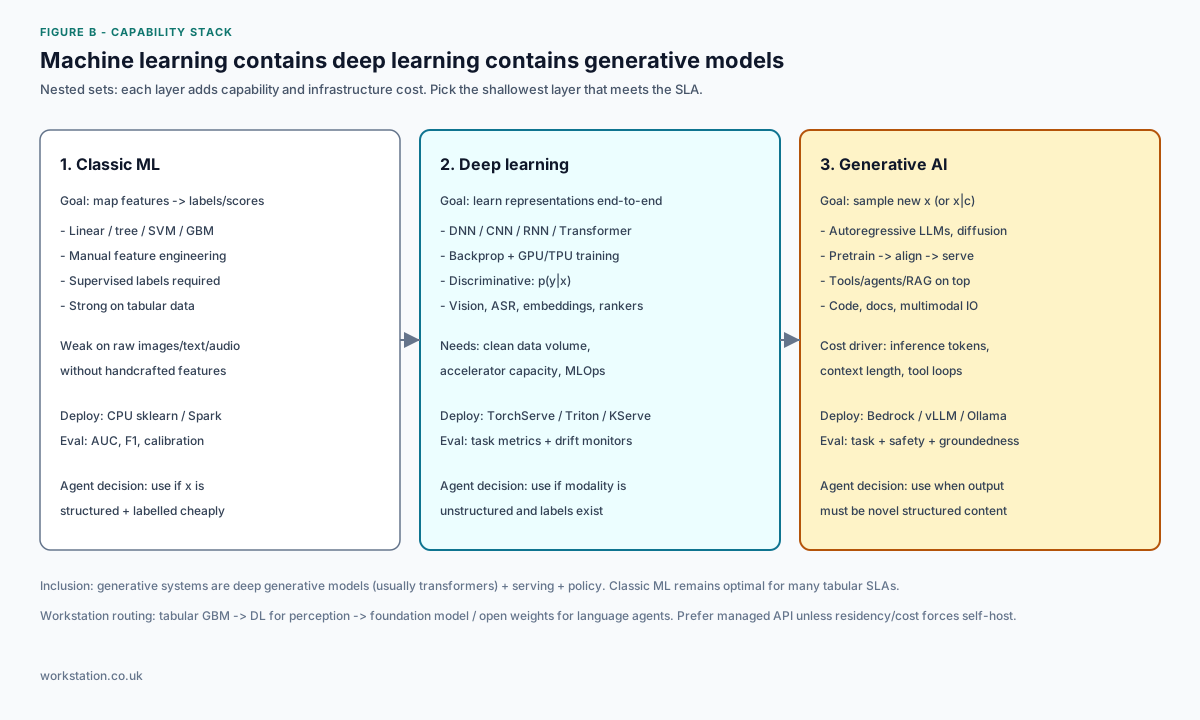
Pile ML vs deep learning vs generative AI

  • Classic ML — features conçues ; arbres/modèles linéaires ; meilleur défaut pour les SLA tabulaires denses.
  • Deep learning — réseaux de bout en bout sur images/texte/audio ; backprop + GPUs ; serving via Triton/KServe/SageMaker.
  • Generative AI — échantillonner du nouveau contenu ; LLMs/diffusion + RAG/outils ; API Bedrock ou inférence open-weight.

Familles de tâches (les métriques comptent)

Famille Objectif / métrique typique
Visiondétecter/classifier — mAP, IoU, latence p99
SpeechASR/TTS — WER, facteur temps réel
NLPclasser / générer — F1, exact-match, groundedness
Recommendranger — NDCG, CTR/CVR
Gen AI agentssuccès de tâche + sécurité + $/requête

Contraintes

  • Data — bruit de labels et drift dominent ; versionner les datasets.
  • Compute — l’entraînement et le décodage LLM sont liés aux accélérateurs.
  • Ops — harnais d’éval, drift, coût, rollback GitOps avant large promote.
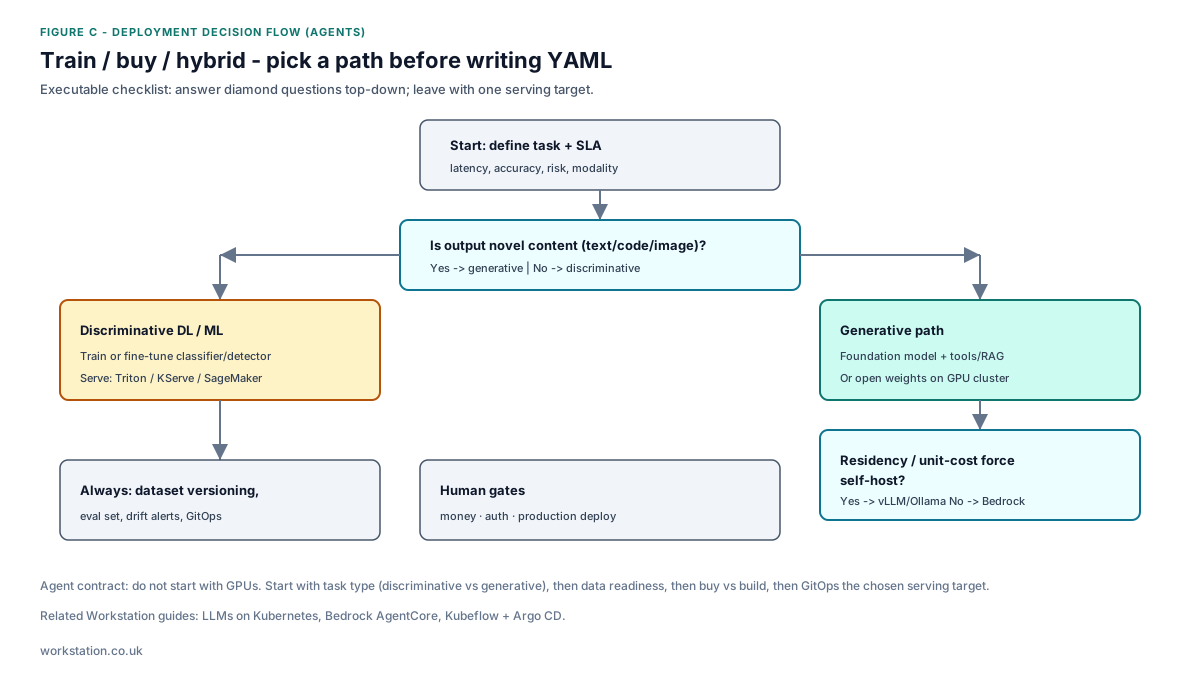
Flux de décision entraîner vs acheter vs hybride

Recommandation Workstation

Classer d’abord discriminatif vs génératif. Préférer les modèles de fondation managés pour les agents langage sauf si résidence/coût imposent des poids ouverts. Garder le ML classique pour le tabulaire. Détails, diagramme de couches et checklist : long article. Publié par Workstation.