Ce qu'apporte réellement une usine d'IA : un rack, 32 GPU Blackwell Ultra et le travail qu'il accomplit pour vous
De vos données aux réponses, aux agents et à vos propres modèles, expliqué sans jargon
 Balinder Walia2 novembre 202610 min read
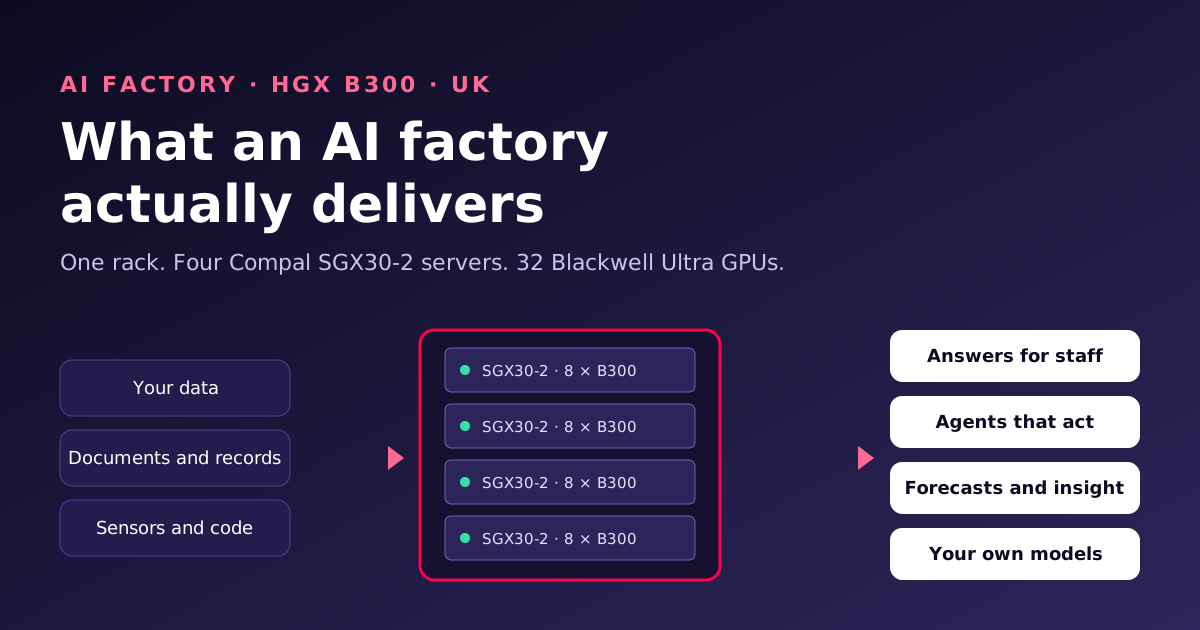
« Usine d'IA » devient rapidement l'une de ces expressions que tout le monde emploie et que peu de gens définissent. Cet article explique, en termes métier simples, ce qu'une usine d'IA apporte réellement : ce qui entre, ce qui sort, comment le travail y circule chaque jour, et ce dont vous avez besoin pour en posséder et en exploiter une. Nous utilisons tout au long de l'article une configuration réelle, un rack de quatre serveurs Compal SGX30-2 avec 32 GPU NVIDIA Blackwell Ultra, pour que les chiffres soient concrets. Les ingénieurs qui veulent l'architecture des nœuds, la conception du réseau et les tests de mise en service liront l'article technique.

Du stockage de l'information à sa production
Pendant trente ans, les centres de données ont surtout stocké et servi de l'information : sites web, bases de données, e-mails, fichiers. Une usine d'IA fait quelque chose de différent. Elle fabrique de nouvelles informations à la demande. Un collaborateur pose une question sur un contrat et obtient une réponse tirée de vos propres archives documentaires. Un agent lit une réclamation entrante, la vérifie par rapport à la politique applicable et rédige une décision. Un modèle entraîné sur cinq ans de vos dossiers de maintenance prédit quelle machine tombera en panne le mois prochain.
L'unité de production est le token, un fragment de texte qu'un modèle lit ou écrit. Chaque réponse, chaque résumé et chaque action d'agent est constitué de tokens. Les questions qui comptent dans une usine d'IA sont donc les mêmes que dans n'importe quelle usine : combien peut-elle produire, quelle est la qualité de la production, combien coûte chaque unité, et avec quelle fiabilité fonctionne-t-elle ?
Ce qui entre, ce qui sort
| Entrée | Sortie |
|---|---|
| Documents, contrats, politiques, manuels | Des réponses précises avec références à la source, en quelques secondes |
| Tickets, e-mails, historiques de chat | Des agents qui trient, rédigent des réponses et orientent le travail |
| Données opérationnelles et de capteurs | Prévisions, alertes d'anomalies et prédictions de maintenance |
| Votre code et vos dossiers d'ingénierie | Des assistants de codage qui connaissent vos systèmes et vos normes |
| Retours sur ce qui a fonctionné | De meilleurs modèles le mois suivant : affinés sur vos propres résultats |
La colonne de droite est ce pour quoi vous payez. Le rack n'est que la machine qui le produit.
La chaîne de production, étape par étape

- Ingestion. La matière première arrive : documents, dossiers, tickets, code. Elle est nettoyée, dédoublonnée et, si nécessaire, les données personnelles sont masquées. Le texte est transformé en embeddings afin de pouvoir être recherché par le sens plutôt que par mot-clé.
- Entraînement ou affinage. La plupart des organisations n'entraînent pas un modèle à partir de zéro. Elles prennent un modèle ouvert performant et l'affinent sur leurs propres données, pour qu'il parle leur langage et connaisse leurs produits. Avec 32 GPU, c'est un travail qui se mesure en heures ou en jours, pas en mois.
- Évaluation et promotion. Avant qu'un nouveau modèle n'atteigne le personnel ou les clients, il est testé en termes de précision, de sécurité, de coût et de vitesse. Les modèles qui réussissent sont promus étape par étape d'un anneau de test à la production, comme les bonnes équipes logicielles publient leur code. Nous utilisons pour cela notre propre Ring Promoter, de sorte que chaque version dispose d'une piste d'audit et peut être annulée.
- Service. C'est ici que la valeur est créée : assistants de chat, recherche documentaire, agents et API répondant aux requêtes toute la journée. L'accès passe par WSL Proxy, qui gère le chiffrement, l'authentification et le pare-feu applicatif web, et les clés et identifiants sont stockés dans WSL Vault plutôt que dans le code.
- Amélioration. Chaque interaction vous apprend quelque chose : quelles réponses ont aidé, lesquelles ont été corrigées, où les agents se sont bloqués. Ces retours deviennent les données d'entraînement et de test du cycle suivant. Cette boucle explique pourquoi une usine d'IA prend de la valeur avec le temps, au lieu de se déprécier comme l'informatique ordinaire.
Sous ces cinq étapes, un ordonnanceur répartit les GPU entre les équipes et les tâches, de sorte que l'entraînement peut s'exécuter la nuit sur une capacité qui sert le personnel pendant la journée. Les GPU inactifs sont ce qui coûte le plus cher dans une usine d'IA, et une bonne planification permet de les éviter.
Ce que contient le rack, et le rôle de chaque élément
Notre brique de base standard est le Compal SGX30-2, un serveur NVIDIA-Certified pour la plateforme HGX B300. Quatre d'entre eux forment un rack. Voici ce que contient chaque serveur, en termes simples.
| Composant | Par serveur | Ce qu'il fait pour vous |
|---|---|---|
| Carte de base NVIDIA HGX B300 NVL8 | 8 GPU Blackwell Ultra, 288 Go de mémoire chacun | Le moteur. Exécute et entraîne les modèles. Une grande mémoire permet d'accueillir de grands modèles et de longs documents sans compromis. |
| Processeurs Intel Xeon 6 | 2 (6767P, 6776P ou 6768P) | Prépare les données, exécute le système d'exploitation et alimente les GPU en continu. |
| Mémoire DDR5-6400 ECC | 32 × 96 Go (3 To) | Espace de travail pour le chargement des données et pour mettre de côté la mémoire des modèles lorsque les GPU sont occupés. |
| Disques NVMe E1.S | 8 × 3,84 To | Stockage local rapide pour les jeux de données, les fichiers de modèles et les points de contrôle d'entraînement. |
| Disques de démarrage M.2 | 2 × 960 Go | Système d'exploitation, en miroir pour qu'une seule panne n'arrête pas le serveur. |
| SuperNIC NVIDIA ConnectX-8 | 8 intégrées, 8 ports 800G | Une ligne privée à 800 Gb/s pour chaque GPU, afin que 32 GPU répartis sur quatre serveurs puissent travailler ensemble sur une même tâche. |
| NVIDIA BlueField-3 B3240 | 1 | Gère séparément le stockage et le trafic des utilisateurs, avec sécurité et isolation intégrées. |
| Alimentations | 12 × 3200 W Titanium, redondance 6+6 | La moitié d'entre elles peut tomber en panne, ou une arrivée électrique peut être coupée, et le serveur continue de fonctionner. |
| Garantie | 3 ans, retour en atelier | Réparations et remplacements organisés par notre intermédiaire. |
À l'échelle du rack, cela représente 32 GPU, environ 8,4 To de mémoire GPU, 12 To de mémoire système et environ 123 To de stockage local rapide, le tout relié par une fabric réseau fonctionnant à 800 Gb/s par GPU.
Ce que cette capacité signifie en pratique
Nous veillons à ne pas promettre de chiffres de performances que nous n'avons pas mesurés sur votre charge de travail, car le débit réel dépend du modèle, de la longueur des questions et des réponses, et du nombre de personnes qui l'utilisent simultanément. Mais certaines choses découlent directement de la mémoire et de la conception :
- Les grands modèles ouverts tiennent sans difficulté. Un seul serveur dispose de 2,1 To de mémoire GPU ; même des modèles de plusieurs centaines de milliards de paramètres peuvent donc être servis depuis un seul serveur, avec de la marge pour de longues conversations.
- Plusieurs services peuvent fonctionner côte à côte. Un serveur peut héberger votre assistant principal tandis qu'un autre gère la recherche documentaire et les embeddings, et que les deux restants s'occupent des agents et de l'affinage nocturne.
- Les tâches d'entraînement peuvent utiliser tout le rack. Lorsqu'un affinage a besoin des 32 GPU, la fabric à 800 Gb/s permet aux quatre serveurs d'agir comme un seul, et l'ordonnanceur rend ensuite la capacité au service.
- Il est conçu pour les modèles de raisonnement. Blackwell Ultra double la vitesse des calculs d'« attention » au cœur des modèles modernes par rapport à la première génération Blackwell, ce qui compte surtout lorsque les modèles réfléchissent à un problème avant de répondre.
Acheter ou louer
Les GPU dans le cloud sont excellents pour les expériences et les besoins ponctuels. L'équation économique change dès que l'IA fait partie du travail quotidien. La capacité louée est facturée à l'heure, qu'elle soit utilisée ou non, et son prix, sa disponibilité et ses conditions appartiennent à quelqu'un d'autre. La capacité possédée est un coût fixe : chaque question supplémentaire traitée, chaque exécution d'agent ou chaque modèle entraîné en réduit le coût unitaire.
Il existe d'autres raisons que le coût. Avec une usine d'IA sur votre propre infrastructure, vos données, vos invites et vos résultats ne quittent jamais le Royaume-Uni ni votre contrôle, ce qui simplifie considérablement les échanges relatifs au RGPD britannique, avec les régulateurs et avec les clients. Vous disposez aussi de la capacité quand vous en avez besoin, sans demande de quota ni attente qu'une région cloud se libère.
Ce n'est pas la bonne solution pour tout le monde. Si votre usage de l'IA est occasionnel, ou si vous n'avez besoin d'une grande capacité que pendant quelques semaines, la location est généralement moins chère. Nous vous dirons honnêtement de quel côté de cette ligne vous vous situez.
Ce qu'il faut pour l'héberger
- Alimentation : chaque serveur a besoin d'environ 14 kW et le rack d'environ 60 kW. Cela exclut la plupart des salles serveurs de bureau ordinaires, mais de nombreuses salles de colocation au Royaume-Uni peuvent le fournir.
- Refroidissement : le SGX30-2 est refroidi par air, aucune installation de refroidissement liquide n'est donc nécessaire, mais la salle doit pouvoir accueillir des racks haute densité avec confinement des allées chaudes.
- Espace : 40U d'espace en rack pour les quatre serveurs, plus les commutateurs réseau et le stockage.
- Délai : les GPU pour centre de données de NVIDIA sont alloués par NVIDIA et les fabricants de serveurs, et les délais se mesurent en mois. La préparation du site et la conception se font pendant l'attente, de sorte que l'usine peut être mise en service peu après la livraison.
- Formalités : les GPU avancés sont soumis aux contrôles à l'exportation britanniques et américains ; nous confirmons donc l'utilisateur final, l'usage prévu et le site d'installation avant de pouvoir confirmer la fourniture.
Qui l'exploite une fois en service
Une usine mal exploitée perd peu à peu de sa production à cause des pannes, des dérives et des failles de sécurité. Nous pouvons exploiter la vôtre dans la mesure que vous souhaitez. Notre service SysOps247 surveille 24 heures sur 24 la santé des GPU, les températures, les erreurs et la capacité, applique les mises à jour de firmware et de sécurité lors de fenêtres planifiées, et gère les pannes et les retours sous garantie. Vos équipes se concentrent sur le travail que produit l'usine.
Une façon raisonnable de commencer
- Décrivez le travail. Quelles questions, quelles décisions et quels documents confieriez-vous d'abord à l'IA, et combien de personnes l'utiliseraient ?
- Vérifiez le site. Disposez-vous, ou pouvez-vous louer, d'environ 60 kW d'espace en rack ? Nous pouvons l'étudier ou présélectionner des options de colocation.
- Commencez par un rack, voire un seul serveur. Tout est construit selon une conception de référence, de sorte que d'autres serveurs et racks peuvent s'ajouter plus tard sans refonte.
- Planifiez les trois premiers services. Généralement un assistant pour le personnel portant sur vos documents, un agent pour un processus bien défini et un modèle affiné. Démontrez la valeur sur ces points, puis développez.
Pour aller plus loin
- Pour l'architecture des nœuds, les quatre réseaux, la pile logicielle, les calculs de dimensionnement des modèles et les tests de réception, lisez l'article technique : Inside a 32-GPU HGX B300 AI factory.
- Découvrez les solutions d'usine d'IA que nous construisons, des serveurs RTX PRO au GB300 NVL72, ainsi que les pages Compal SGX30-2 et rack HGX B300 de 32 GPU.
- Le SGX30-2 est disponible à la commande dans notre boutique. Le prix est confirmé sur devis écrit.
- Vous prévoyez un projet similaire ? Parlez-nous.