Nach der Sandbox wandte sich Jensen Huangs Keynote auf der GTC Berlin dem zu, was einen Agenten spezifisch für ein Unternehmen macht: seinem Wissen. Die Folie hinter ihm zeigte die Agent Knowledge Foundation. Unstrukturierte Dokumente nehmen einen Weg. Strukturierte Datenbanken einen anderen. Dieser Artikel folgt dieser Folie und danach den Partnerbeispielen, die er für das Post-Training von Nemotron anführte, ohne eines davon als Fallstudie von Workstation zu behandeln.
Warum ein Basismodell nicht das Gedächtnis des Agenten ist
Huangs Reihenfolge der Bausteine war bewusst gewählt. Zuerst der Harness, der in einer OpenShell-Sandbox läuft. Zweitens Nemotron als Sprachmodell. Diese beiden, sagte er, sind nur der Anfang. Was einen Agenten zu dem macht, was er einen Super-Agenten nannte, ist der Zugriff auf das eigene Wissen des Unternehmens. Die Bibliotheken und Modelle für diese Aufgabe hat NVIDIA auf eine Folie gestellt und Agent Knowledge Foundation genannt.
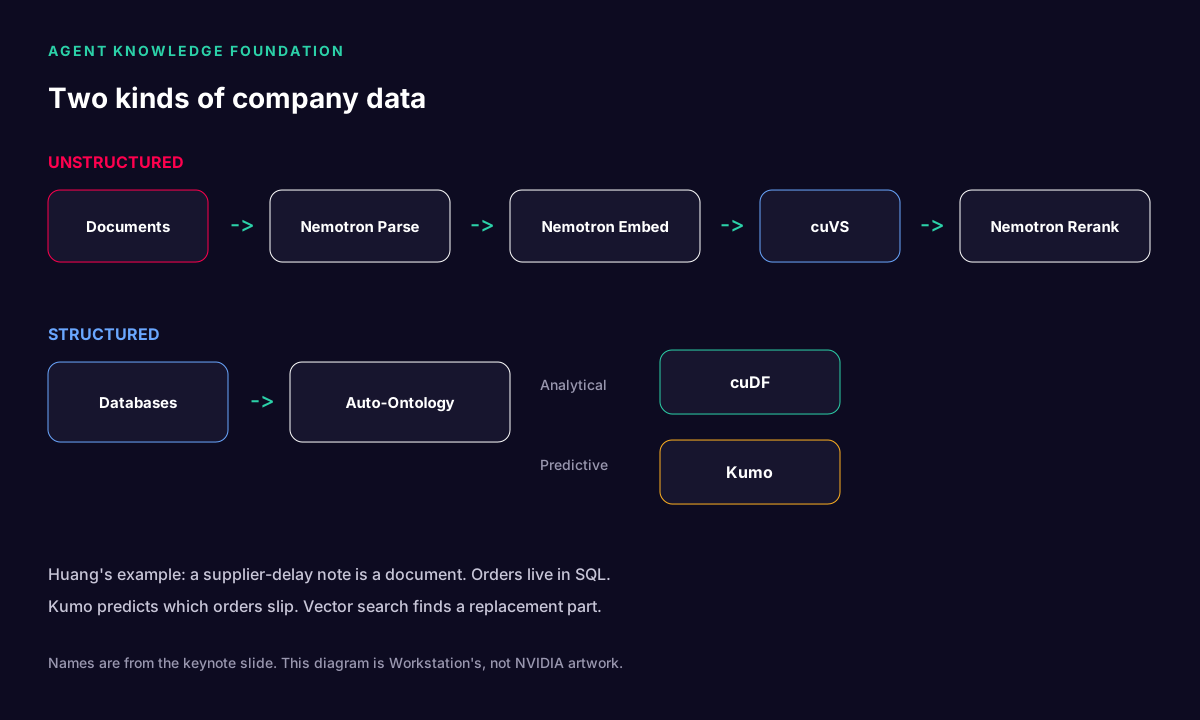
Unternehmensdaten kommen in zwei Formen. Dokumente, PDFs und andere Dateien, die eine KI lesen muss. Und Zeilen in einer Datenbank. Die Foundation ist die Sammlung von Bibliotheken, die aus beidem Bedeutung gewinnen.
Der Dokumentenpfad
Von links nach rechts in der unstrukturierten Zeile der Folie:
- Nemotron Parse liest die Dokumente. Huang nannte es Weltklasse und „top of leaderboard“. Welches Leaderboard, sagte er nicht. Wir erfinden keines.
- Nemotron Embed wandelt eine Anfrage und das geparste Wissen in Vektoren um, damit sie einander zugeordnet werden können. Er verwendete dieselbe Formulierung „top of leaderboard“.
- cuVS ist die Vektorsuche. Die Folie platziert sie zwischen Embed und Rerank. cuVS ist NVIDIAs Bibliothek für Ähnlichkeitssuche auf der GPU.
- Nemotron Rerank nimmt die vielen Passagen, die die Suche liefert, und ordnet sie nach Relevanz für die Frage.
Das ist eine Retrieval-Pipeline, dargestellt mit Produktnamen statt als generischer „RAG“-Kasten. Parsen, einbetten, suchen, neu ordnen. Der Agent muss trotzdem die Erlaubnis haben, sie aufzurufen. Im Bild mit den fünf Elementen ist diese gesamte Zeile das Wissenselement, erreichbar über ein Werkzeug, das die Sandbox-Richtlinie zulässt.
Der Datenbankpfad
Die strukturierte Zeile beginnt bei Auto-Ontology und teilt sich dann.
- Analytische Arbeit geht an cuDF, die GPU-Dataframe-Bibliothek.
- Prädiktive Arbeit geht an Kumo. Das Keynote-Transkript gibt diesen Namen als „QMO“ und „CUMA“ wieder. Die Folie im Saal schreibt Kumo. Wir folgen der Folie.
Huangs Beispiel ist das, was man sich merken sollte, weil es beide Zeilen nutzt. Eine Mitteilung, dass ein Lieferant knapp oder verspätet sein wird, kommt als Dokument. Die Aufträge, die dieser Lieferant beliefert, liegen in SQL. Mit Kumo, sagte er, sagen Sie voraus, welche Aufträge sich verzögern und um wie viel. Ein Ersatzbauteil zu finden ist eine Vektorsuche zurück in die Konstruktionsdokumente. Eine Entscheidung, zwei Datenformen, zwei Werkzeuge.
Offene Gewichte, dann Ihre Daten
Vor der Folie warb Huang für offene Modelle, die Sie prüfen können. Nemotron für Sprache. Cosmos als World Foundation Model. GR00T für humanoide Robotik. Alpamayo für autonomes Fahren. Earth-2 für Physik. Er sagte, NVIDIA veröffentliche die Gewichte, die zum Bau des Modells verwendeten Daten und die Skripte zur Reproduktion, damit ein Labor die Herkunft nachvollziehen kann. „Providence“ im Rohtranskript bedeutet Provenienz, also Herkunft.
Zur Rangfolge äußerte er sich ebenfalls unverblümt. Diese Sprachmodelle sind nicht automatisch die Spitze der Spitze. Anpassung mit Partnern, sagte er, sei der Weg, sie zu einem Spitzenmodell für eine bestimmte Aufgabe zu machen und proprietäre Daten in das zu verwandeln, was er souveräne Intelligenz nannte. „Super Intelligence“ später in derselben Passage ist seine Bezeichnung für das Ergebnis dieses Post-Trainings. Es ist eine Aussage über die Eignung für eine Aufgabe, kein gemessener IQ.
Die Beispiele, die er laut veröffentlichtem Transkript von der Bühne aus nannte, waren diese. Über die Tatsache hinaus, dass er sie genannt hat, haben wir die Kundenprojekte nicht überprüft:
- A21 unterstützt Alice und macht aus Nemotron ein Modell, das nach seinen Worten bei deren Aufgabe Spitzenfähigkeiten übertrifft.
- Base10 unterstützt CodeRabbit und führt ein Fine-Tuning von Nemotron auf den Daten dieses Kunden durch.
- Trajectory und Harvey führen ein Post-Training von Nemotron durch.
- Scale arbeitet mit Skydance zusammen, nach demselben Muster.
- Palantir mit dem Tampa General Hospital.
Das Neocloud-Rad später in der Keynote schreibt ein Unternehmen Baseten. Das Transkript dieser Passage sagt Base10. Wir führen diese nicht zu einer Firma zusammen. Wenn Sie CodeRabbit, Harvey, Skydance oder Tampa General sind: Der obige Satz stammt von Huang und ist kein Ergebnis, das wir reproduziert haben.
Werkzeuge sind das letzte Element
Wissen ohne Werkzeuge lässt den Agenten immer noch nur lesen. Huangs letzter Punkt war CUDA-X: Fachbibliotheken, die in Wissenschaft, Ingenieurwesen, Forschung und kreativer Arbeit eingesetzt werden. Er nannte sie die Kronjuwelen, weil ein Assistent, der konstruiert oder berechnet, einen Algorithmus aufrufen muss und nicht nur eine Chat-API. Die RTX-Spark-Demo später in der Keynote fasste das in einem Atemzug zusammen: Hermes als Harness, Nemotron und ein Modell, das das Transkript „OpenAI's GPT-6 Astra“ nennt, sowie CUDA-X-Werkzeuge wie FreeCAD, Blender, Isaac Sim, die Physik-Engine Newton und Isaac Lab. Diese Demo war NVIDIAs, auf der Bühne, für einen Hugging-Face-Roboter namens Microduck. Sie ist kein Benchmark von Workstation.
Was Sie zuerst bauen sollten
Wenn Sie einen Agenten mit Ihren eigenen Dateien ausstatten, ist die Berliner Folie eine Checkliste und keine Bestellung.
- Setzen Sie den Harness in eine Sandbox, bevor Sie ihn mit dem Dateispeicher verbinden. Der OpenShell-Artikel behandelt diese Hälfte.
- Entscheiden Sie, welches Wissen ein Dokument und welches eine Tabelle ist. Schicken Sie nicht beides durch dieselbe Pipeline in der Hoffnung, dass es klappt.
- Parsen und betten Sie die Dokumente ein. Suchen Sie mit einer Vektorbibliothek. Ordnen Sie neu, bevor das Modell den Stapel sieht.
- Lassen Sie SQL SQL sein. Nutzen Sie eine Dataframe-Bibliothek für Analysen und ein prädiktives Modell nur dort, wo Sie eine Frage wie Huangs Lieferantenbeispiel haben.
- Führen Sie ein Post-Training eines offenen Modells nur durch, wenn das generische Modell auf eine Weise falsch liegt, die Ihre Daten beheben können. Er sagte, die Technologie existiere. Er sagte nicht, dass sie günstig sei oder dass jedes Fine-Tuning gewinne.
Das Lieferantenbeispiel Schritt für Schritt
Bringen Sie Huangs Geschichte in die Reihenfolge, in der ein System sie tatsächlich ausführen würde.
- Ein PDF oder eine E-Mail besagt, dass ein Lieferant sich verspätet. Diese Datei landet bei Nemotron Parse.
- Nemotron Embed wandelt die Verzögerungsmitteilung und die Anfrage „Welche Aufträge betrifft das?“ in Vektoren um.
- cuVS durchsucht den Vektorspeicher. Nemotron Rerank behält die Passagen, die tatsächlich von diesem Lieferanten handeln.
- Das Auftragsbuch liegt nicht in diesem Speicher. Es ist SQL. Auto-Ontology ist der Name auf der Folie dafür, diese strukturierte Welt für den Agenten lesbar zu machen. cuDF ist der analytische Schritt über diese Zeilen. Kumo ist der prädiktive Schritt: Wer ist knapp und wie lange.
- Ein Ersatzteil ist wieder unstrukturiert: eine Zeichnung oder eine Spezifikation. Die Suche liefert es. Der Harness schlägt eine Aktion vor. Die Sandbox entscheidet, ob diese Aktion erlaubt ist.
Lassen Sie Schritt 5 weg, und Sie haben ein belesenes Modell mit einer Shell. Genau für dieses Versagen gibt es OpenShell.
Wann Sie kein Post-Training durchführen sollten
Huangs Partnerliste ist eine Liste von Teams, die bereits eine Aufgabe und Daten hatten. Sie ist kein Grund, am ersten Tag ein Fine-Tuning durchzuführen. Wenn das generische Modell falsch liegt, weil es Ihre Dateien nicht sehen kann, beheben Sie zuerst das Retrieval. Wenn es die Dateien sehen kann und trotzdem die falschen Begriffe, die falschen Einheiten oder die falsche Richtlinie verwendet, dann ist Post-Training der Schritt, den er beschrieben hat: Beginnen Sie mit Nemotron, bewahren Sie das Rezept auf, damit Sie wissen, was Sie geändert haben, und testen Sie mit Ihren eigenen Traces. Er sagte, das Ergebnis könne für diese Aufgabe die Spitze erreichen. Die Werte hat er nicht veröffentlicht. Wir tun es auch nicht.
CUDA-X ist das Werkzeugregal darunter. Er sagte, ein Computer führe Strömungsdynamik, Teilchenphysik, Quantenchemie, Datenverarbeitung und Raytracing aus, und der GPU-Pfad liege in der Größenordnung des 10-, 50- oder 100-Fachen eines nativen CPU-Laufs. Diese Spanne wurde auf der Bühne genannt. Sie ist kein einzelner Benchmark mit einem benannten Datensatz. Verstehen Sie sie als sein Argument dafür, warum Werkzeuge auf eine GPU gehören, und messen Sie dann die Bibliothek, die Sie tatsächlich aufrufen.
Quellen
- Keynote-Transkript, einschließlich der Passage zur Knowledge Foundation und der Partnernamen: SB61112
- Bei der Keynote fotografierte Folie: unstrukturierter Pfad Nemotron Parse, Nemotron Embed, cuVS, Nemotron Rerank; strukturierter Pfad Auto-Ontology, cuDF, Kumo.
- Begleitartikel: der Überblick über die Keynote


