Am 21. Oktober 2026 sagte Jensen Huang auf der GTC Berlin vor dem Saal, dass das Infrastrukturargument nicht mehr das interessante sei. Die Fabriken, der CUDA-Stack und die GPUs seien das Fundament. Die Frage, die er als Nächstes stellte, war, was man damit tut. Ingenieure von Workstation waren in der Halle im STATION-Berlin. Hier steht, was er sagte, abgeglichen mit NVIDIAs veröffentlichtem Keynote-Transkript, und was es bedeutet, wenn Sie Rechner kaufen und nicht einen Gigawatt-Campus.
KI ist in diesem Jahr produktiv geworden
Huangs Satz war schlicht. Im vergangenen Jahr ist KI produktiv geworden. Er verwies auf den Jahresbeginn, als NVIDIA über OpenClaw sprach, einen Open-Source-Agenten. Damit, sagte er, habe das Muster begonnen, das heute überall sichtbar ist: Agenten, die denken, schlussfolgern, iterieren und Werkzeuge nutzen.
Nützliche Agenten sind auf eine bestimmte Weise teuer. Sie antworten nicht einmal. Sie arbeiten in Schleifen. Jede Schleife verbraucht Tokens. Mehr Agenten, genutzt von mehr Menschen, die jeweils viele Tokens zum Denken verbrauchen: Deshalb, sagte er, seien sowohl der Token-Verbrauch als auch die GPU-Nachfrage durch die Decke gegangen. In dieser Passage zeigte er kein Token-Diagramm. Die Aussage gibt eine Richtung an: Agenten-Workloads sind die Nachfrage, nicht ein einzelnes Chatfenster.
Fünf Elemente, nicht ein Modell
Anschließend definierte er einen Agenten als fünf Dinge. Das Modell ist das Sprachmodell, das auf GPUs läuft und Tokens erzeugt, die der Agent verbraucht. Er nannte es das Exoskelett. Der Harness ist das Programm, das plant und Werkzeuge aufruft. Der Harness sitzt in einer Sandbox, die ihn vom Rest des Systems isoliert. Die anderen beiden Elemente sind Wissen und Werkzeuge.
Seine eigene Liste, in der Reihenfolge, auf die er sich festlegte: Modelle, Sandbox, Harness, Wissen und Werkzeuge.
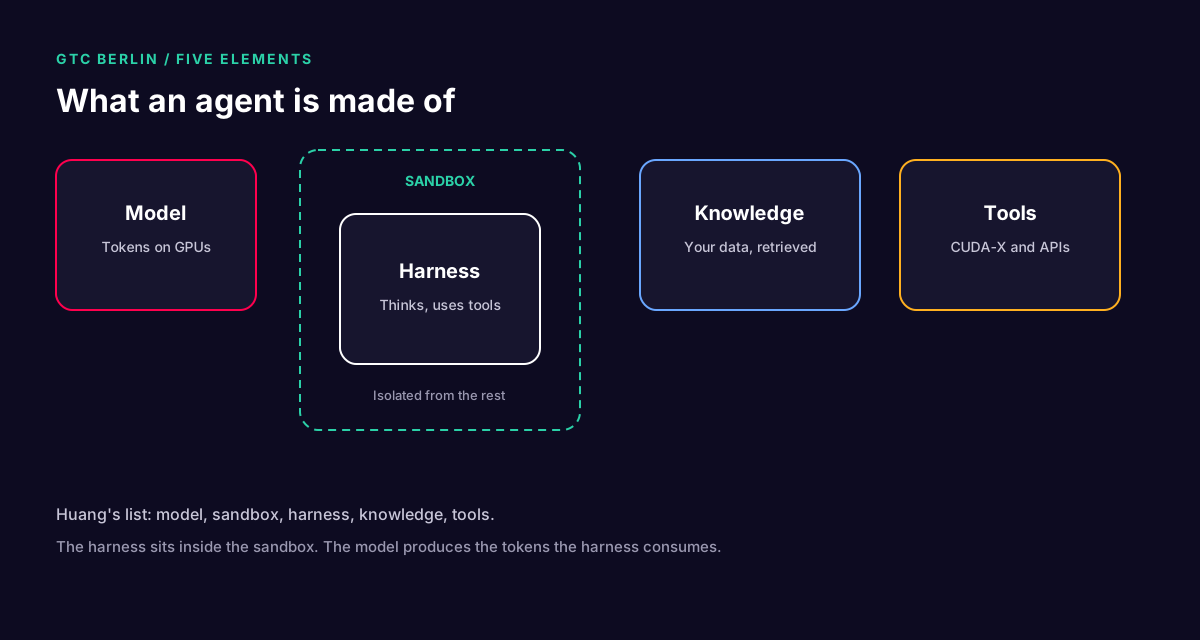
Diese Aufteilung ist der nützliche Teil für einen Käufer. Eine größere GPU versorgt nur das Modell. Sie entscheidet nicht, worauf der Harness zugreifen darf, welches Wissen er sehen kann oder welche Werkzeuge er aufrufen darf. Das sind getrennte Systeme. Huangs nächster Satz lautete, dass der Agent sicher sein muss, bevor er nützlich ist, weil er autonom ist und Dateien, Netzwerke und Werkzeuge erreichen kann. Die Rechte sollten minimal sein, und jemand muss ihn überwachen. Das ist die OpenShell-Ankündigung, die im Begleitartikel behandelt wird.
Was der Rest der Keynote daran aufhängte
Drei weitere Ideen bauten auf demselben Rahmen auf.
- Offene Modelle, die Sie nachtrainieren können. Nemotron für Sprache, Cosmos für Weltmodelle, GR00T für Robotik, Alpamayo für autonomes Fahren und Earth-2 für Physik. Huang sagte, NVIDIA liefere Gewichte, Daten und Skripte, damit ein Labor sehen kann, woher das Modell stammt. Er stellte ausdrücklich klar, dass die Sprachmodelle nicht automatisch an der Spitze stehen, bis ein Partner sie per Post-Training auf privaten Daten anpasst.
- Eine Wissensgrundlage. Unstrukturierte Dokumente laufen durch Nemotron Parse, Nemotron Embed, cuVS und Nemotron Rerank. Strukturierte Daten laufen durch Auto-Ontology, dann durch cuDF für die Analyse und Kumo für die Vorhersage. Sein ausgearbeitetes Beispiel war eine Lieferverzögerung in einem Dokument, Aufträge in SQL und die Suche nach einem Ersatzteil.
- Die Fabrik darunter. NVIDIA DSX ist das Full-Stack-Referenzdesign für KI-Fabriken: Compute, Netzwerk, Speicher, Software, Stromversorgung und Kühlung, ausgehend von einem digitalen Zwilling. Die Europa-Folie stapelte Anwendungen, Modelle, KI-Fabriken, NVIDIA-Compute und Energie.
Was das auf einer Workstation bedeutet
Die meisten Unternehmen im Saal werden in diesem Jahr keine Halle mit Vera Rubin NVL72 bauen. Sie werden einen Harness, eine Sandbox und ein Modell betreiben, das auf einen Schreibtisch oder in ein einzelnes Rack passt. Das Bild der fünf Elemente gilt trotzdem.
- Das Modell kann Nemotron sein, eine geschlossene API oder beides. Huang sagte, jedes Unternehmen werde geschlossene und offene Modelle nutzen und dort anpassen, wo die Arbeit proprietär ist.
- Der Harness kann OpenClaw, Hermes, OpenHands, ein LangChain- oder Deep-Agents-Stack oder selbst geschriebenes Python sein. Er nannte diese als Möglichkeiten, den Harness zu bauen, der nun in OpenShell sitzt.
- Wissen sind Ihre Dokumente und Ihre Datenbank, nicht ein generischer Crawl des Webs.
- Bei den Werkzeugen ist CUDA-X weiterhin wichtig: die Bibliotheken, die ein Agent aufruft, wenn die Aufgabe Wissenschaft, Ingenieurwesen oder eine Konstruktionsdatei ist, nicht ein weiterer Absatz Chat.
Ein Workstation-System für diese Konstellation ist ein Linux- oder Mac-Studio-Rechner mit genug Speicher für das Modell, einer Sandbox-Laufzeitumgebung und einem Ort für die Dokumente und die SQL-Daten. Die Fabrikgeschichte gilt dann, wenn die Token-Rate nicht mehr in ein Gerät passt. Huangs eigener Schluss zur Referenzarchitektur lautete, dass Agenten auf Rubin denken, auf Vera handeln und auf BlueField gesteuert werden. Das ist ein Satz für das Rechenzentrum. Die fünf Elemente sind der Teil, mit dem Sie auf einem Rechner beginnen können.
Zahlen, die wir nicht als unsere behandeln
NVIDIAs Newsroom erklärte am selben Tag, dass Vera Rubin NVL72 bei Agenten-Workloads den 30-fachen Durchsatz pro Megawatt der vorherigen Generation liefert, dass Vera-CPUs die doppelte Leistung von x86 bei höherer Effizienz liefern und dass Sentry auf BlueField-4 die Agentenkapazität um bis zu 20 Prozent steigern kann. Das sind NVIDIAs Zahlen aus deren Pressemitteilung, kein Benchmark von Workstation. Die Keynote sagte außerdem, Vera Rubin sei in zwei Jahren noch einmal 30-mal Blackwell. Gleiche Regel: Zitieren Sie es als NVIDIAs Angabe.
Die ausführlichen technischen Beiträge im Anschluss an diesen behandeln OpenShell und Sentry, die Wissensgrundlage sowie DSX und den Europa-Stack.
Eine Schleife, keine Antwort
Eine Chat-Antwort ist ein Aufruf. Ein Agent ist eine Kette. Das Modell liest einen langen Prompt, schreibt einen Werkzeugaufruf, der Harness führt das Werkzeug aus, und das Ergebnis fließt in den nächsten Prompt zurück. Huangs „enorme Menge an Tokens“ ist diese Kette, multipliziert mit der Zahl der gleichzeitig laufenden Agenten. Er sagte nicht, dass ein Team zehnmal schneller wird. Er sagte, die Maschinen würden stärker ausgelastet, weil die Software endlich Arbeit erledigt.
Wenn Sie eine Planungszahl wollen, kennzeichnen Sie sie als Skizze. Angenommen, ein Agentenlauf besteht aus acht Modellaufrufen und eine Person startet zwanzig Läufe am Tag. Das sind 160 Aufrufe, wo ein Chatbot 20 gewesen wären. Die GPUs sind nicht langsamer geworden. Die Form der Arbeit hat sich geändert. Ändern Sie die 8 oder die 20, und die Skizze ändert sich. Zitieren Sie sie nicht als Benchmark.
Was Sie vor dem Kauf aufschreiben sollten
Übertragen Sie die fünf Elemente auf ein Blatt, bevor Sie eine GPU auswählen.
- Modell. Welche Gewichte, in welcher Präzision und wie lang der Kontext ist, den Sie tatsächlich senden werden. Der VRAM ergibt sich daraus. Ein Modell mit 70 Milliarden Parametern in 4 Bit ist ein anderer Rechner als dasselbe Modell in 16 Bit.
- Harness. OpenClaw, Hermes, OpenHands, ein Framework oder Ihr eigenes Python. Der Harness ist Software, die Sie ändern können. Er ist keine GPU-SKU.
- Sandbox. OpenShell oder eine andere Laufzeitumgebung, die Nein sagen kann. Wenn Sie diesen Punkt überspringen, teilen sich die anderen vier Elemente einen Satz von Rechten.
- Wissen. Welche Dokumente, welche Datenbank und wer sie abrufen darf.
- Werkzeuge. Die wenigen APIs und CUDA-X-Bibliotheken, die die Aufgabe braucht. Huang sagte, nützlich sei der Agent, der ein echtes Werkzeug aufrufen kann, und diese Werkzeuge seien der Grund, warum eine GPU schneller ist, als dieselbe Bibliothek auf einer CPU auszuführen. Er sprach vom 10-, 50- oder 100-Fachen. Das war eine Spanne von der Bühne, keine wissenschaftliche Veröffentlichung.
Wenn dieses Blatt auf eine Workstation passt, kaufen Sie die Workstation. Wenn die Token-Rate eine Halle braucht, sind Sie im DSX-Gespräch. Beides kann in einem Unternehmen zutreffen.
Quellen
- NVIDIA-On-Demand-Transkript, Keynote der GTC Berlin 2026, SB61112: nvidia.com
- NVIDIA-Newsroom, 21. Oktober 2026, OpenShell Reference Architecture: nvidianews.nvidia.com
- NVIDIA-Blog, Live-Notizen von der Keynote: blogs.nvidia.com


