Observability ist nicht optional: Machen Sie sie zum Unternehmensstandard
Für Führungskräfte und Inhaber: Telemetrie zentralisieren, Plattformen standardisieren und Monitoring als Release-Anforderung behandeln – nicht als Vorliebe eines Teams
 Balinder Walia8. Oktober 20263 min read
Für Führungskräfte und Unternehmensinhaber: Observability ist keine Frage der Tool-Vorliebe – sie ist die Art, wie das Unternehmen erkennt, ob Produkte, Zahlungen und KI-Agenten gesund sind. Machen Sie sie zu einem zentralen Standard, nicht zu einem optionalen Nebenprojekt. Technischer Begleitartikel: Big Prometheus, Vor- und Nachteile und MoSCoW der Tool-Landschaft. Verwandt: LLM-Engpässe & Kostenkontrolle.
Warum das eine Geschäftsentscheidung ist und kein SRE-Hobby
Wenn um 2 Uhr nachts ein Checkout ausfällt, fragt die Führungsebene nicht, welche Open-Source-Datenbank einen Benchmark gewonnen hat. Sie fragt: Wie lange dauert es, bis wir es wissen, wie lange, bis wir es beheben, und wie verhindern wir, dass es wieder passiert? Diese Antworten gibt es nur, wenn Metriken, Logs, Traces und Alerts in einem gemeinsamen System mit klarer Verantwortung liegen.
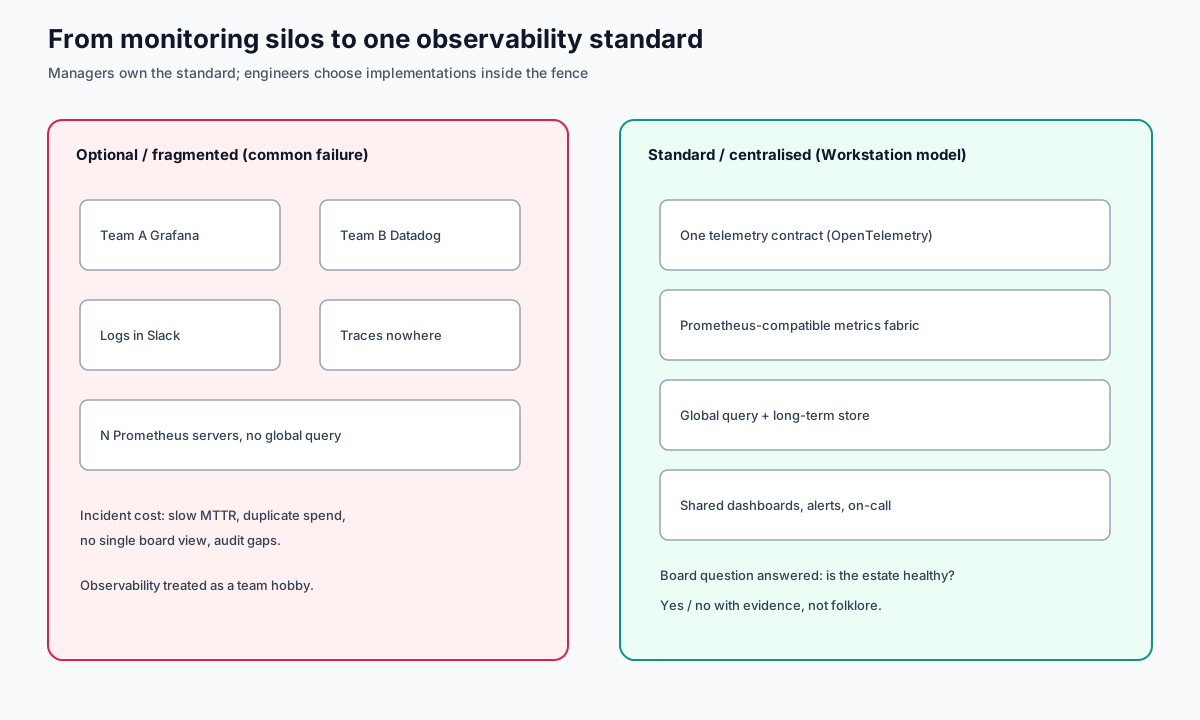
Optionale Observability erzeugt vorhersehbare Fehlerbilder:
- Blinde Flecken – ein kritischer Dienst „hatte keine Zeit“, Metriken einzubauen.
- Tool-Wildwuchs – drei APMs, zwei Log-Produkte, keine einheitliche Wahrheit für SLOs.
- Kostenüberraschungen – Labels mit hoher Kardinalität und ungesampelte Traces sprengen das Budget.
- Lücken im Audit – Aufsichtsbehörden und Unternehmenskunden verlangen Nachweise; Screenshots aus Slack zählen nicht.
Was „zentral und standardisiert“ in der Praxis bedeutet
Zentral heißt nicht: ein Anbieter für immer. Es bedeutet:
- Ein Telemetrie-Vertrag – jeder Produktionsdienst gibt Metriken, Logs und Traces in freigegebenen Formaten aus (typischerweise OpenTelemetry + Prometheus).
- Ein Ort für Fragen zur gesamten Landschaft – „Welche Cluster brennen?“ und „Wie hoch war die Fehlerrate vor sieben Wochen?“, ohne zwischen zehn Oberflächen zu springen.
- Eine Taxonomie für Bereitschaft und Alerts – Schweregrad, Verantwortung und Eskalation sind eine gemeinsame Sprache.
- Eine FinOps-Leine – Aufbewahrung, Sampling und Kardinalitätsbudgets sind Richtlinie, nicht Heldentum.
Angelehnt an die Open-Source-Diskussion um „Big Prometheus“ (Thanos, Cortex/Mimir, M3, VictoriaMetrics) ist die technische Entscheidung, wie Sie diesen Standard über viele Kubernetes-Cluster skalieren – nicht, ob Sie überhaupt einen Standard brauchen.
MoSCoW auf einer Folie für die Führungsebene
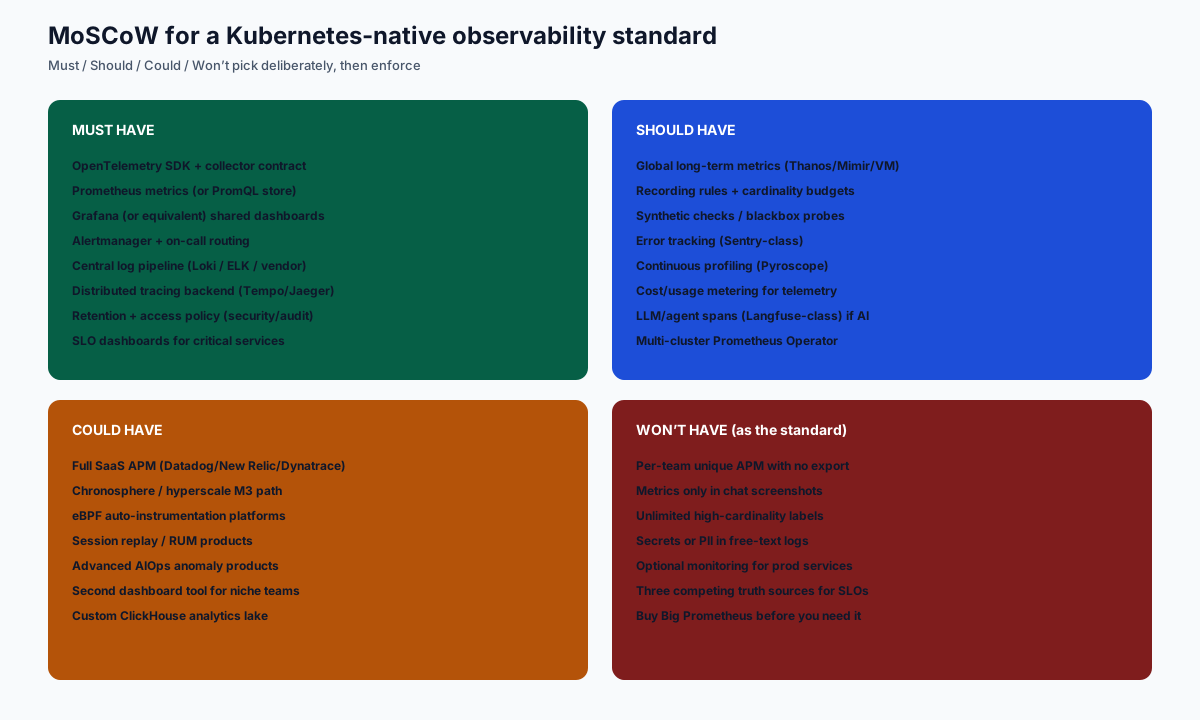
- Must – OpenTelemetry-Vertrag, PromQL-Metriken, gemeinsame Dashboards, Alerting/Bereitschaft, zentrale Logs, Tracing, Richtlinie für Aufbewahrung/Zugriff, SLOs für kritische Abläufe.
- Should – globaler Langzeitspeicher für Metriken, Kardinalitätsbudgets, synthetische Tests, Fehlertracking, Profiling, Kostenmessung der Telemetrie.
- Could – vollständiges SaaS-APM, kommerzielle Stacks im Hyperscale-Maßstab, eBPF-Auto-Instrumentierung, RUM/Session Replay.
- Won’t (als Standard) – eigene APMs pro Team ohne Export, Metriken als Screenshots, unbegrenzte Kardinalität, optionales Monitoring für die Produktion, drei konkurrierende SLO-Quellen.
Was Führungskräfte finanzieren und durchsetzen sollten
- Plattformverantwortung – ein kleines Team verantwortet den Standard; Produktteams nutzen ihn.
- Definition of Done – kein Produktions-Release ohne Golden Signals und mit Alerts verknüpfte Runbooks.
- Budget als Richtlinie – bezahlen Sie Aufbewahrung und Abfrageleistung bewusst; „sparen“ Sie kein Geld, indem Sie blind werden.
- Quartalsweise Reviews – Tool-Wildwuchs, Trends bei MTTA/MTTR und die größten Kardinalitätssünder.
Die Haltung von Workstation
Workstation betreibt GPU-Shops, KI-Agenten, Edge-Proxys und Promotion-Ringe. Diese Oberflächen bleiben nur vertrauenswürdig, wenn Observability über INT → TEST → ACC → PROD verpflichtend ist – dieselbe Disziplin, die wir bei Secrets und Releases anwenden. Für die technische Vertiefung – Big-Prometheus-Optionen, ehrliche Vor- und Nachteile und ein vollständiges MoSCoW der Tool-Landschaft – lesen Sie den technischen Artikel.
Sie möchten einen einheitlichen Observability-Standard für Ihre Cluster und KI-Workloads? Sprechen Sie mit Workstation.