Die erste Hälfte von Jensen Huangs Keynote auf der GTC Berlin am 21. Oktober 2026 galt der Fabrik. NVIDIA DSX ist das Referenzdesign, um eine zu bauen. Die Folien hinter ihm stellten anschließend Europas Unternehmen in Ebenen auf diese Fabrik und ein Rad von Märkten um eine einzige CUDA-Architektur. Ingenieure von Workstation haben diese Folien fotografiert. Dieser Artikel sagt, was darauf zu sehen ist, welche Zahlen von NVIDIA stammen und wo ein Rechner am Schreibtisch weiterhin seinen Platz hat.
Chips allein machen keine Fabrik
Huangs Einstiegssatz: Großartige Chips machen noch keine großartige KI-Fabrik. NVIDIA DSX ist eine Full-Stack-Referenzarchitektur, gemeinsam mit Infrastrukturunternehmen entwickelt, die Compute, Netzwerk, Speicher, Software, Stromversorgung und Kühlung als ein System abdeckt. Sie beginnt in einem digitalen Zwilling, sodass das Gebäude entworfen ist, bevor es gegossen wird. Er beschrieb außerdem DSX Max, eine Steuerungsebene, und ein Neudenken der Kühlung. Eine Zahl nannte er: Bei 2 Gigawatt kann DSX 54 Millionen Liter Wasser pro Tag einsparen. Das ist NVIDIAs Angabe aus der Keynote. Das Wassermodell haben wir nicht geprüft.
Am selben Tag kündigte er DSX Pod an: Vera-Rubin-Racks, in der Fabrik integriert und verkabelt, sodass ein Standort nicht eine Halle voller loser Switches verdrahten muss. Das Transkript erwähnt Spectrum-X-Kabel in einer Größenordnung in einem Vera Rubin DSX Pod. Er nannte das Ergebnis eine KI-Fabrik, die „responsible by design“ sei, und sagte, Pods ermöglichten es, Fabriken mit Lichtgeschwindigkeit zu bauen. Verstehen Sie „Lichtgeschwindigkeit“ als Slogan, nicht als Bauzeitplan.
Zum Generationssprung sagte er, Vera Rubin sei in zwei Jahren noch einmal 30-mal leistungsfähiger als Blackwell. Der Newsroom formuliert vorsichtiger, dass Vera Rubin NVL72 bei agentischen Workloads einen 30-fach höheren Durchsatz pro Megawatt liefert. Beide Sätze stammen von NVIDIA. Sie sind keine Messung von Workstation an einem benannten Modell.
Was die DSX-Plattformfolie zeigte
Eine Folie trug den Titel „The NVIDIA DSX Full-Stack AI Factory Platform“. Oben: CUDA-X-Bibliotheken, Plattformbibliotheken und offene Modelle. Unten waren die Racks laut Foto so beschriftet:
- Vera Rubin NVL72
- NVLink-6-Switch
- Vera BlueField-4 Compute
- Spectrum-6-Switch
- ein Rack mit der Beschriftung Groq 3 LPX
- Vera BlueField-4 Storage
- Vera RTX Compute
Die Seite des Rubin-Racks zeigte außerdem Rubin, Vera, BlueField-4 und ConnectX-9. Wir listen die Beschriftungen auf, die wir lesen konnten. Für diejenigen, bei denen die Folie auf dem Foto keine Angaben zeigte, erfinden wir keine Portgeschwindigkeiten oder Rack-Leistungen.
Eine CUDA-Architektur, sechs Märkte
Ein späteres Rad trug den Titel „One CUDA Architecture. Many Markets. Productive, Fungible, and Durable.“ In der Mitte stand „Full-Stack AI Factory“. Sechs Segmente lagen darum herum. Die Hinweiskästen nannten Unternehmen. Dies ist die Auswahl, die wir lesen konnten, keine Behauptung, dass die Liste vollständig war. Der Kasten für Start-ups selbst sagte „10K+“.
- Unternehmen und Industrie. Automobil, Verteidigung, Gesundheitswesen, Fertigung, Energie, Finanzdienstleistungen, Gaming, öffentlicher Sektor, Handel und Logistik, Medien und Unterhaltung, Supercomputing, Telekommunikation.
- Cloud-Anbieter. AWS, Google Cloud, Microsoft Azure, Oracle Cloud, Meta, SpaceX Super Intelligence.
- KI-native Unternehmen. Eine lange Start-up-Liste, darunter AMI Labs, Black Forest Labs, Cognition, Cohere, Cursor, ElevenLabs, Figure, Harvey, Hugging Face, Inception Labs, Ineffable, Inherent Labs, Lovable, Mistral, Perplexity, Physical Intelligence, Reflection, Runway, Sakana, SSI, Thinking Machines Lab.
- Neoclouds. Baseten, CoreWeave, Crusoe, Firebird, Fireworks, Firmus, GMI, IREN, Lambda, Mistral, Nebius, Nscale, Together AI, Volta.
- ODMs und OEMs. ASUS, Bull, Dell, Foxconn, Gigabyte, HPE, Inventec, Lenovo, Pegatron, Quanta, Supermicro, Wistron, Wiwynn und weitere auf derselben Karte.
- KI-Labore. Anthropic, Gemini, Meta, OpenAI, SpaceX Super Intelligence.
Fungibel bedeutet in Huangs früherer Erklärung, dass dieselbe installierte Basis Training, Inferenz und das nächste Modell ausführt, weil das Software-Ökosystem bereits vorhanden ist. Langlebig bedeutet, dass diese installierte Basis nicht mit jeder Generation weggeworfen wird. Produktiv war das Wort, das er sich für Agenten aufsparte.
Europa in fünf Ebenen
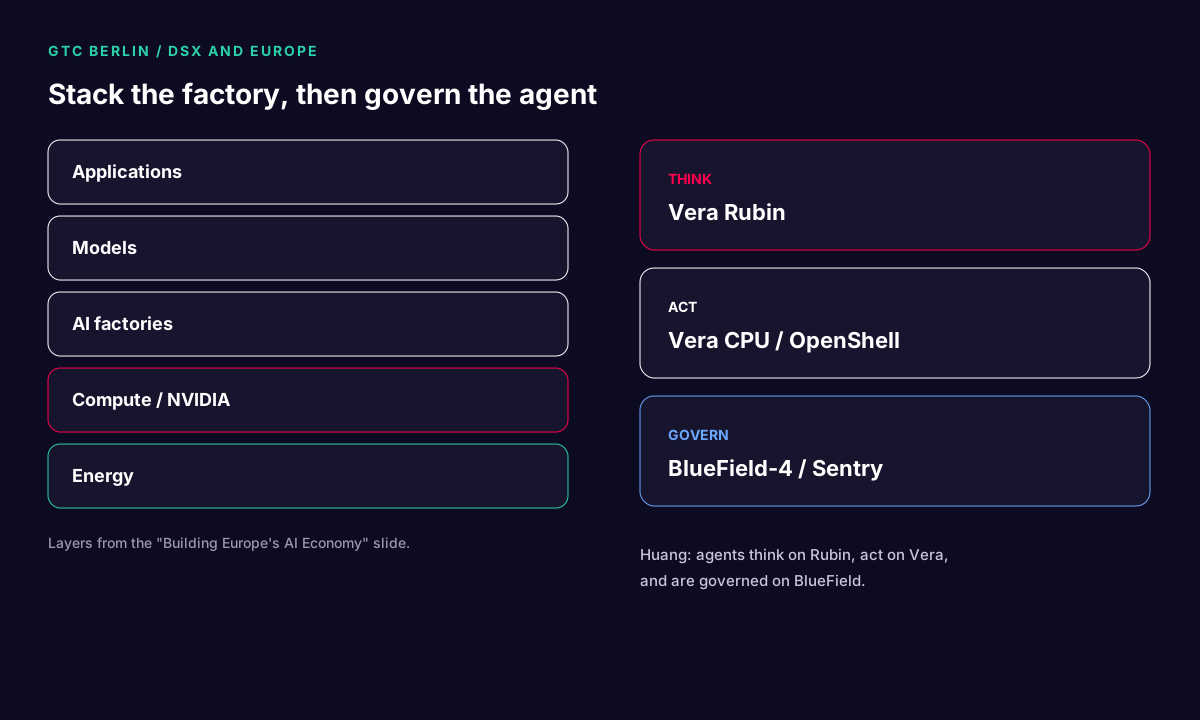
Die Folie mit dem Titel „Building Europe's AI Economy“ war ein Stack, keine Landkarte. Laut Foto:
- Anwendungen. Eine breite Auswahl europäischer und internationaler Produktunternehmen. Zu den lesbaren Namen gehörten unter vielen anderen DeepL, ElevenLabs, Helsing, Anwendungslogos aus dem Umfeld von Mistral, n8n, PhysicsX, Synthesia und Wayve. Das Foto ist dicht. Verstehen Sie jedes einzelne Logo als „war auf der Folie“, nicht als Partnerschaft mit Workstation.
- Modelle. Aleph Alpha und Mistral AI waren lesbar, daneben weitere Modelllabore.
- KI-Fabriken. Bull, Deutsche Telekom, Firebird, Mistral AI, Nebius, Nscale, Nokia, Radiant, Volta.
- Compute. NVIDIA, allein in dieser Ebene.
- Energie. Ein SMR-Zeichen, Schneider Electric, Siemens Energy.
Wo eine Workstation weiterhin hingehört
DSX Pod ist ein Fabrikprodukt. Die Edge-Liste der Keynote selbst ist das andere Ende: RTX Spark, DGX Spark, DGX Station, jeweils mit OpenShell. Huangs Demo eines Roboters auf RTX Spark, der einen Harness und lokale Werkzeuge nutzte und nur dann in die Cloud ausweichen ließ, wenn die Aufgabe groß war, ist das Muster zwischen diesen Enden.
Für ein Team im Vereinigten Königreich sieht die praktische Aufteilung so aus:
- Ein Rechner, wenn Agent, Sandbox und Wissen in den Speicher passen und die Token-Rate menschliches Maß hat. Das ist eine Workstation oder ein Gerät der DGX-Spark-Klasse.
- Ein Pod, wenn viele Agenten oder ein großer Trainingslauf die NVLink-Domäne, das Spectrum-Fabric und die Energieanlage brauchen. Das ist DSX, und es ist ein Bauprojekt.
- Eine Neocloud, wenn Sie die GPUs für einen Monat wollen und nicht das Gebäude. Das Neocloud-Segment des Rads ist NVIDIAs Liste der Orte, an denen diese Kapazität aufgebaut wird, darunter Firmen wie Nebius, Nscale, Lambda und CoreWeave.
Keine dieser Entscheidungen macht die Sandbox überflüssig. Eine Fabrik ohne OpenShell ist nach Huangs eigener Argumentation ein großer Ort, um einen Agenten zu betreiben, den Sie nur durch höfliches Bitten steuern können. Der Sicherheitsartikel ist hier. Der Wissenspfad ist hier. Der Überblick über die Keynote ist hier.
Wer das Gebäude entwirft
Huang nannte die Unternehmen auf dem Weg des digitalen Zwillings, und es lohnt sich, sie von der Logowand zu trennen. PTC macht aus Gerätekonstruktionen Assets, die eine Simulation nutzen kann. Dassault Systèmes verbindet Rack- und Gebäudeplanung mit modellbasiertem Systems Engineering. Schneider Electric simuliert Stromverteilung und Flüssigkeitskühlung. Jacobs führt die Teile in einem digitalen Zwilling in Omniverse zusammen. Siemens bewertet thermische, akustische und netzseitige Auswirkungen. Procore ist im Schritt der Bauplanung beteiligt. Das ist eine Planungskette für ein Gebäude, keine Softwareinstallation.
Zur Stromversorgung beschrieb er DSX Max als Regelkreis, der die Leistung an die Last anpasst, und sagte, es verbrauche bei gleicher Leistung 30 Prozent weniger Strom. Zur Kühlung: Vera-Rubin-Systeme sind für geschlossene Flüssigkeitskühlung mit Kühlmitteltemperaturen bis 45 Grad Celsius ausgelegt, sodass in einem geeigneten Klima Trockenkühler im Freien Wärme abgeben können, ohne Wasser zu verdunsten. Die 54 Millionen Liter pro Tag sind die Zahl, die er einem 2-Gigawatt-Standort zuordnete, der Verdunstung vermeiden kann. Alle drei Zahlen stammen von ihm, aus der Keynote. Ein Käufer außerhalb dieses Klimas oder unterhalb dieser Größenordnung sollte sie nicht in einen Business Case übernehmen.
Fragen, die Sie einem Fabrikanbieter stellen sollten
- Ist der Pod als Einheit verkabelt und getestet, oder terminiert der Standort Spectrum-X-Verbindungen noch von Hand?
- Wo ist der digitale Zwilling, und welche dieser sechs Firmen steht tatsächlich im Vertrag?
- Von welcher Kühlmitteltemperatur geht das Design aus, und erlaubt das lokale Klima Trockenkühler?
- Wo läuft OpenShell: auf den Vera-CPUs im Pod oder nur auf der Folie?
Wenn die Antworten vage sind, sehen Sie einen GPU-Kauf, an den das Wort Fabrik angehängt wurde. Der Maßstab der Keynote selbst lag höher.
Quellen
- Keynote-Transkript, Passagen zu DSX und Vera Rubin: SB61112
- Newsroom-Zahlen zu Durchsatz pro Megawatt, Vera gegenüber x86 und Sentry-Kapazität: 21. Oktober 2026
- Fotos der DSX-Plattformfolie, des CUDA-Marktrads und von „Building Europe's AI Economy“, aufgenommen bei der Keynote.


