Der Shop ist online

Wir bauen Workstation AI-Maschinen für Websites, KI-Agenten und LLM-Training – online konfigurieren und kaufen.

Händlerpreise erhalten
KI-Produkte
KI-LabsOpenAI-AgentenClaude-AgentenGrok-BotWorkstation AI-natives CRMMarketingAlle Produkte
KI-Lösungen
Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI-WorkstationsNVIDIA-Hardware & -SoftwareNVIDIA Accelerated ComputingPrivate KIGPU-Private-CloudGPU-ClusterEdge-KIKI nach Branche
KI-Services
PlattformmodernisierungDigital EngineeringDatengrundlagen & KIAutonomer BetriebKI-BeratungDevOps-AutomatisierungCybersicherheitSoftwareentwicklungAgentenentwicklungMLOps-EinrichtungGPU-LeasingGPU-Private-Cloud
Über uns
UnternehmenUnsere GeschichtePartnerKundengeschichten
KI-Rechenzentren
KI-RechenzentrenGPU-Private-CloudGPU-ClusterGPU-Leasing
KI-EinblickeJev-ReiheBenchmark LabModellauswahl
Technische Hinweise
Dokumentation
Linux-BetriebssystemeUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
KI-Cloud-PlattformenAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-Clouds & Marktplätze
Private KI-RechenzentrenFür AnwaltskanzleienFür Steuer- und WirtschaftsprüfungskanzleienOn-Premises-PlattformenVollständig abgesicherte Cloud
ToolsRing PromoterJobshout
News
Blog
KontaktAnmelden

KI-Workstations, Multi-Agenten-KI-Software, GPU-Infrastruktur und intelligente Agentenlösungen für moderne Unternehmen.

Kontakt

KI-Lösungen

Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI nach Branche

Produkte

Alle ProdukteWorkstation AI-natives CRM & ERPMarketingOpenAI-AgentenRing PromoterJobshout

Unternehmen

Über unsUnternehmenKI-RechenzentrenWarum WorkstationPartnerKundengeschichtenPreiseKontaktTenthMatrix

Ressourcen

KI-EinblickeTechnische HinweiseDokumentationLinux-BetriebssystemeKI-Cloud-PlattformenPrivate KI-RechenzentrenBlogSucheSitemap
Büro Belgien
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Mo – Fr: 9:00 – 18:00 Uhr MEZ
+32 492 45 67 46
Hauptsitz Großbritannien
77-79 Marlowes, Hemel Hempstead HP1 1LFAnfahrt – Ausfahrt 20 der M25 (Outer London)Handelsregisternr.: 11641870Mo – Fr: 9:00 – 18:00 Uhr GMT
+44 7515 356 146
Büro Indien
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Büro Taiwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Mo – Fr: 9:00 – 18:00 Uhr Taiwan-Zeit (GMT+8)
+886 926 892 701+32 492 45 67 46
Büro Estland
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaMo - Fr: 9:00 - 18:00 Uhr estnischer Zeit (EET)
+32 492 45 67 46

© 2026 Workstation AI. Alle Rechte vorbehalten.

DatenschutzDatenlöschungCookiesNutzungsbedingungenWebsite-Sitemap

NVIDIA, das NVIDIA-Logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX und HGX sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den USA und anderen Ländern. AMD, das AMD-Arrow-Logo, EPYC, Instinct, Ryzen und Threadripper sind Marken von Advanced Micro Devices, Inc. Dell und PowerEdge sind Marken der Dell Inc. oder ihrer Tochtergesellschaften. Intel und Xeon sind Marken der Intel Corporation oder ihrer Tochtergesellschaften. AMAX, AceleMax und LiquidMax sind Marken der AMAX Engineering Corporation. Alle anderen Produktnamen, Logos und Marken sind Eigentum ihrer jeweiligen Inhaber. Wir verwenden sie ausschließlich, um die Produkte zu kennzeichnen, die wir beschreiben, liefern oder unterstützen; ihre Verwendung bedeutet nicht, dass ihre Inhaber uns empfehlen.

GPU-Private-Cloud

Ihre eigene KI-Cloud: GPUs, Speicher und Software in einem Rechenzentrum unter Ihrer Kontrolle

Betreiben Sie KI-Assistenten, Agenten, Suche und Modelltraining auf GPUs, die nur Ihnen gehören, direkt neben Ihren Daten und zu planbaren Kosten. Wir entwerfen, bauen und betreiben GPU Private Clouds vom einzelnen Server bis zu kompletten Racks, in Ihren Räumlichkeiten oder in einem britischen Rechenzentrum.

Auf dieser Seite

  1. Was eine GPU Private Cloud ist
  2. Warum Organisationen ihre eigene GPU-Cloud bauen
  3. Die Hardware ansehen: offizielle Videos von NVIDIA, Dell und AMD
  4. GPUs, VRAM und Server
  5. Wie viel VRAM brauchen Sie?
  6. Speicher, der GPUs auslastet
  7. Das Netzwerk zwischen den GPUs
  8. Alles, was eine vollständige GPU Private Cloud umfasst
  9. Privat, öffentlich oder hybrid: im Vergleich
  10. Eine GPU Private Cloud von Grund auf bauen
  11. Ausprobieren: das Labor für private KI-Clouds
  12. FAQ zur GPU Private Cloud

Ausprobieren: das Labor für private KI-Clouds

Was eine GPU Private Cloud ist

Eine GPU Private Cloud bietet Ihren Teams das Self-Service-Erlebnis einer Public Cloud (Modell auswählen, Notebook starten, Assistenten bereitstellen) auf GPU-Servern, die nur Sie nutzen. Die Hardware steht in Ihren eigenen Räumlichkeiten oder in einem Colocation-Rechenzentrum, und Plattformsoftware, Sicherheitsrichtlinien und Daten bleiben vollständig unter Ihrer Kontrolle.

Die Public Cloud ist hervorragend, um Ideen auszuprobieren und kurze Spitzen abzudecken. Doch KI-Assistenten und Agenten laufen den ganzen Tag, jede Interaktion wird abgerechnet, und die benötigten Daten sind oft genau die, die Sie am wenigsten verschieben können. Sobald die Nutzung stetig ist, macht eine Private Cloud die Kosten in der Regel planbar, hält sensible Daten an einem Ort und verkürzt die Latenz zwischen Ihren Modellen und Ihren Systemen.

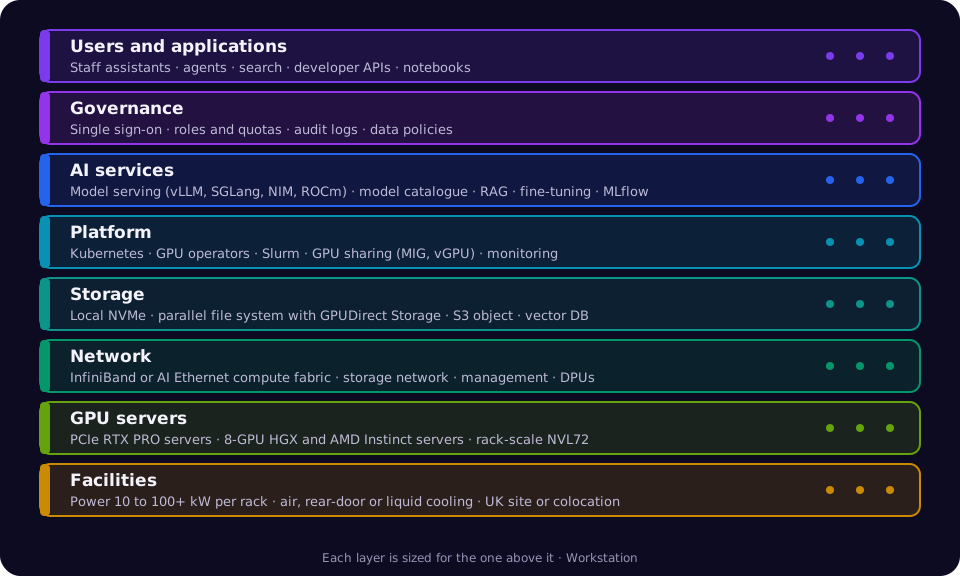
Sie ist kein einzelnes Produkt. Eine private KI-Cloud ist ein Stack: Strom und Kühlung, GPU-Server, ein schnelles Netzwerk, Speicher, der GPUs auslasten kann, eine Container- und Scheduling-Plattform, Model Serving und Datentools sowie die Governance darum herum. Der Rest dieser Seite geht jede Schicht durch und lässt Sie dann die Optionen für Ihre eigenen Workloads ausprobieren.

Diagramm des GPU-Private-Cloud-Stacks: unten die Infrastruktur, darüber GPU-Server, Netzwerk und Speicher, bis hin zu Plattform, KI-Diensten und Governance oben, mit Benutzern und Anwendungen darüber.
Die acht Schichten einer GPU Private Cloud. Jede muss für die Schicht darüber dimensioniert sein.

Zurück zum Inhalt

Warum Organisationen ihre eigene GPU-Cloud bauen

Die Gründe, die wir am häufigsten hören, und was sie in der Praxis bedeuten.

Planbare Kosten für KI im Dauerbetrieb

Assistenten, Agenten und APIs, die rund um die Uhr laufen, kosten auf eigener oder geleaster Hardware jeden Monat gleich viel – statt einer Rechnung, die mit jedem Token und jedem Benutzer wächst.

Die Daten bleiben, wo Sie es entscheiden

Halten Sie Kunden-, Patienten-, Rechts- oder Finanzdaten im Vereinigten Königreich, an Ihrem eigenen Standort oder komplett offline – und weisen Sie dies gegenüber Prüfern und Aufsichtsbehörden nach.

Geringe Latenz direkt bei Ihren Daten

Modelle laufen neben Ihren Datenbanken, Dokumenten und Anwendungen, sodass Retrieval und Tool-Aufrufe von Agenten nicht bei jedem Schritt das Internet durchqueren.

Freie Wahl bei Modellen und Tools

Betreiben Sie Open-Weight-Modelle, Ihre feinabgestimmten Modelle und kommerzielle Modelle nebeneinander und wechseln Sie sie ohne Plattformwechsel. Keine Bindung an den Katalog eines Anbieters.

Integrierte Governance

Single Sign-on, rollenbasierter Zugriff, Kontingente pro Team, Audit-Logs jedes Modellaufrufs und Richtlinien dazu, auf welche Daten jeder Assistent zugreifen darf.

Self-Service für jedes Team

Data Scientists starten Notebooks und Feintuning-Jobs, Entwickler stellen Modell-Endpunkte bereit, und die IT behält eine Konsole für Kapazität, Zustand und Kosten.

Garantierte GPU-Kapazität

Ihre GPUs sind da, wenn ein Projekt startet, und nicht in der benötigten Region ausverkauft. Das Scheduling entscheidet, welches Team sie erhält – nicht eine Warteschlange bei einem Anbieter.

Hardware, die sich dauerhaft auszahlt

Ältere GPUs wandern zu Inferenz, Entwicklung und Lehre, wenn neue eintreffen, sodass jede Generation jahrelang Nutzen bringt.

Zurück zum Inhalt

Die Hardware ansehen: offizielle Videos von NVIDIA, Dell und AMD

Abgespielt vom eigenen YouTube-Kanal des jeweiligen Herstellers. Jedes Video wird erst geladen, wenn Sie auf Play drücken.

The AI Factory. Wiedergabe vom offiziellen YouTube-Kanal von NVIDIA. Auf YouTube ansehenNVIDIA, Blackwell, DGX, Grace und RTX PRO sind Marken und/oder eingetragene Marken der NVIDIA Corporation. Sie werden zur Beschreibung der von uns gelieferten Produkte gezeigt; eine Empfehlung durch NVIDIA ist damit nicht verbunden.
How Dell Technologies Is Building the Engines of AI Factories With NVIDIA Blackwell. Wiedergabe vom offiziellen YouTube-Kanal von NVIDIA. Auf YouTube ansehenDie gezeigten Produktnamen sind Marken oder eingetragene Marken von NVIDIA and Dell Technologies. Sie werden zur Beschreibung der von uns gelieferten Produkte gezeigt; eine Empfehlung ist damit nicht verbunden.
AMD Helios Rackscale Solution: Open AI Infrastructure for the AI Factory Era. Wiedergabe vom offiziellen YouTube-Kanal von AMD. Auf YouTube ansehenDie gezeigten Produktnamen sind Marken oder eingetragene Marken von AMD. Sie werden zur Beschreibung der von uns gelieferten Produkte gezeigt; eine Empfehlung ist damit nicht verbunden.

Zurück zum Inhalt

GPUs, VRAM und Server

Der GPU-Speicher (VRAM) entscheidet, welche Modelle passen und wie viele Benutzer jede GPU bedienen kann; die Speicherbandbreite entscheidet, wie schnell sie antwortet. Dies sind die Rechenzentrums-GPUs, mit denen wir Private Clouds am häufigsten bauen.

Rechenzentrums-GPUs im Vergleich

GPUHerstellerSpeicher pro GPUSpeicherbandbreiteBauformGeeignet für
RTX PRO 6000 Blackwell Server EditionNVIDIA96 GB GDDR71,6 TB/sPCIe-Karte, luftgekühltInferenz, RAG, Feintuning kleiner und mittlerer Modelle, Grafik und Simulation
L40SNVIDIA48 GB GDDR6864 GB/sPCIe-Karte, luftgekühltInferenz kleiner Modelle, Vision, Rendering
H200NVIDIA141 GB HBM3e4,8 TB/s8-GPU-HGX-BoardInferenz und Feintuning großer Modelle
B200NVIDIA180 GB HBM3e8 TB/s8-GPU-HGX-BoardTraining und Inferenz mit hohem Durchsatz
B300 (Blackwell Ultra)NVIDIA288 GB HBM3e8 TB/s8-GPU-HGX-Board, Luft- oder FlüssigkühlungReasoning-Modelle, sehr große Modelle, Training
GB300 NVL72NVIDIA288 GB HBM3e pro GPU, 72 GPUs pro Rack8 TB/s pro GPUFlüssigkeitsgekühltes RackFrontier-Training und die größten Inferenzdienste
Instinct MI325XAMD256 GB HBM3E6 TB/s8-GPU-OAM-PlattformInferenz großer Modelle mit viel Speicher pro GPU
Instinct MI355XAMD288 GB HBM3E8 TB/s8-GPU-OAM-Plattform, FlüssigkühlungTraining und Inferenz sehr großer Modelle
DGX Spark (GB10)NVIDIA128 GB Unified Memory273 GB/sSystem für den SchreibtischEntwicklung, Prototyping und Pilotprojekte vor dem Cluster

Die Werte sind die veröffentlichten Spezifikationen der Hersteller. Partnerserver können GPUs mit anderen Leistungsgrenzen betreiben.

Server, die sie aufnehmen

PCIe-GPU-Server

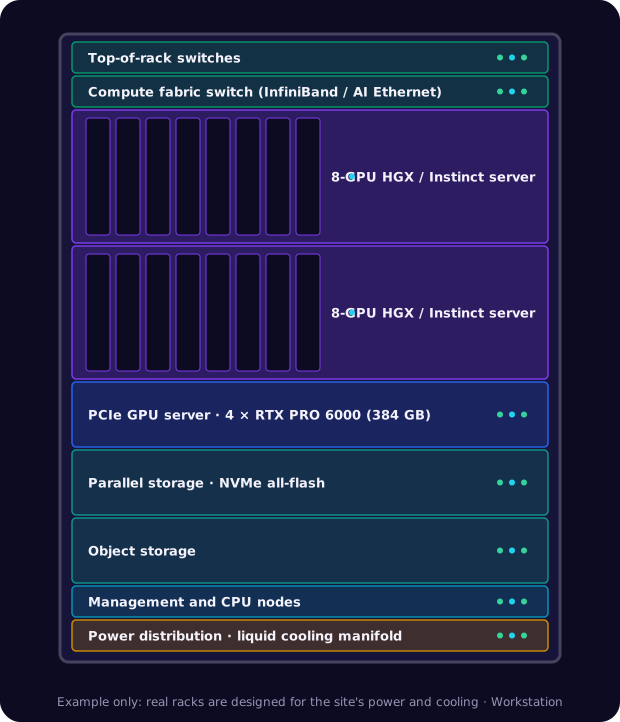
Zwei bis acht PCIe-GPUs wie RTX PRO 6000 oder L40S in einem luftgekühlten Standardserver, zum Beispiel Dell PowerEdge XE7745 oder R760xa. Der einfachste Einstieg in eine Private Cloud: passt in die meisten Racks und Strombudgets.

8-GPU-HGX- und OAM-Server

Acht GPUs, verbunden über NVLink oder AMD Infinity Fabric, zum Beispiel Dell PowerEdge XE9680 (H200 oder AMD Instinct MI300X), XE9780 (B300) und XE9785 (AMD Instinct MI355X) oder NVIDIA DGX B200 und DGX B300.

Systeme im Rack-Maßstab

Komplette flüssigkeitsgekühlte Racks, die wie eine einzige riesige GPU arbeiten, etwa NVIDIA GB300 NVL72 oder AMD Helios. Für Organisationen, die die größten Modelle trainieren oder bereitstellen, in einem dafür gebauten Rechenzentrum.

KI-Systeme für den Schreibtisch

DGX Spark und KI-Workstations für Entwickler und Pilotprojekte. Derselbe Software-Stack wie im Cluster, sodass die Arbeit unverändert übertragen werden kann.

Zurück zum Inhalt

Wie viel VRAM brauchen Sie?

Eine schnelle Methode, den GPU-Speicher zu dimensionieren, bevor Sie mit jemandem sprechen. Nutzen Sie den Sizer weiter unten für Ihre eigenen Zahlen.

  • Modellgewichte: etwa 2 GB pro Milliarde Parameter bei 16 Bit, 1 GB bei 8 Bit (FP8) und 0,5 GB bei 4 Bit.
  • KV-Cache: Auch die Konversation jedes Benutzers braucht Speicher, der mit der Kontextlänge und der Zahl gleichzeitig bedienter Benutzer wächst. Bei stark genutzten Diensten kann er so groß werden wie die Gewichte.
  • Reserve: Lassen Sie etwa 10 bis 20 % für Laufzeitumgebung, Aktivierungen und Spitzen frei.
  • Feintuning braucht mehr: Vollständiges Feintuning kann das Drei- bis Vierfache des Speichers für Inferenz benötigen; LoRA und QLoRA brauchen weit weniger.
  • Mixture-of-Experts-Modelle müssen alle ihre Experten im Speicher halten, auch wenn für jedes Wort nur einige genutzt werden.
ModellgrößeGenauigkeitSpeicher für GewichtePasst auf (mit Platz für Benutzer)
8 Milliarden Parameter16 Bitetwa 16 GBEine L40S oder RTX PRO 6000; DGX Spark
32 Milliarden Parameter8 Bitetwa 32 GBEine RTX PRO 6000
70 Milliarden Parameter8 Bitetwa 70 GBEine H200 oder zwei RTX PRO 6000
120 Milliarden Parameter (MoE)4 Bitetwa 60 bis 65 GBEine RTX PRO 6000 oder H200
405 Milliarden Parameter8 Bitetwa 405 GBEin 8-GPU-Server mit H200, B200 oder MI325X
670 Milliarden Parameter und mehr (MoE)8 Bitetwa 670 GB oder mehrEin 8-GPU-Server mit B300 oder MI355X oder mehrere Server

VRAM-Rechner

Zurück zum Inhalt

Speicher, der GPUs auslastet

GPUs, die auf Daten warten, verschwenden Geld. KI-Speicher besteht meist aus drei Stufen, dimensioniert für die Lesegeschwindigkeit, die das Training braucht, und die Kapazität, die Ihre Daten brauchen.

Lokaler NVMe-Speicher in jedem Server

Schneller Scratch-Speicher für Datensätze, Checkpoints und Modell-Caches, nah an den GPUs. Typischerweise mehrere NVMe-Laufwerke pro GPU-Server.

NVMe-SSDs in jedem GPU-Server

Gemeinsames Hochleistungs-Dateisystem

Ein Namespace, den alle Server parallel lesen, schnell genug, um das Training zu versorgen und Modelle in Sekunden zu laden. Achten Sie auf Unterstützung für GPUDirect Storage, das Daten direkt in den GPU-Speicher überträgt.

Dell PowerScale, VAST Data, WEKA, DDN, IBM Storage Scale, Lustre

Objektspeicher und Backup

Große, kostengünstige Kapazität für Rohdaten, Datensätze, Modellversionen und Backups, über die S3-Schnittstelle, die die meisten KI-Tools bereits beherrschen.

Dell ECS oder ObjectScale, Ceph, S3-kompatible Appliances, Band oder Cloud für externe Kopien

Vektor- und Dokumentenspeicher für RAG

Assistenten, die aus Ihren Dokumenten antworten, brauchen eine Vektordatenbank und die Originaldateien, mit denselben Zugriffskontrollen wie die Quellsysteme. Zum Beispiel pgvector, Milvus, Qdrant oder Elasticsearch.

Zurück zum Inhalt

Das Netzwerk zwischen den GPUs

Innerhalb eines Servers kommunizieren GPUs über NVLink oder Infinity Fabric. Zwischen Servern entscheidet das Netzwerk, ob viele GPUs wie eine arbeiten können.

Compute-Fabric

Für Training oder Serving über mehrere Server: NVIDIA Quantum InfiniBand (400 bis 800 Gbit/s pro Port), NVIDIA Spectrum-X Ethernet oder Ethernet mit AMD Pensando Pollara AI NICs. Meist ein Port mit 400 oder 800 Gbit/s pro GPU.

Speicher- und Frontend-Netzwerk

Ein separates Ethernet-Netzwerk für Speicherverkehr, Benutzer und Anwendungen, typischerweise 100 bis 400 Gbit/s pro Server, damit es nie mit dem Compute-Fabric konkurriert.

Management und Sicherheit

Out-of-Band-Management für jeden Server, DPUs wie NVIDIA BlueField zur Isolierung von Mandanten und Auslagerung von Sicherheitsfunktionen sowie Firewalls zwischen der KI-Cloud und dem restlichen Unternehmen.

Zurück zum Inhalt

Alles, was eine vollständige GPU Private Cloud umfasst

Unsere Checkliste für eine private KI-Cloud, die Teams tatsächlich nutzen. Wir haken diese Punkte bei Design, Aufbau und Übergabe ab.

Infrastruktur und Gebäude

  • Leistung pro Rack für GPU-Server dimensioniert (10 kW bis über 100 kW)
  • Passende Luft-, Rücktür- oder direkte Flüssigkühlung
  • Redundante Stromzuführungen und USV
  • Bodenbelastung, Zugangskontrolle und Brandschutz geprüft
  • Begehung eines britischen Rechenzentrums oder eines eigenen Standorts

Rechenleistung

  • GPU-Server passend zu Modellgrößen und Benutzern
  • Reine CPU-Knoten für Datenaufbereitung und Dienste
  • Reservekapazität oder Ersatzteile für Ausfälle
  • Firmware- und Treiber-Baselines gemeinsam getestet
  • Burn-in und Benchmark vor der Übergabe

Netzwerk

  • InfiniBand- oder KI-Ethernet-Compute-Fabric
  • Getrennte Speicher- und Frontend-Netzwerke
  • Out-of-Band-Management-Netzwerk
  • Segmentierung vom Unternehmensnetzwerk
  • Optionale DPUs zur Mandantenisolation

Speicher

  • Lokaler NVMe-Scratch in jedem Server
  • Gemeinsames paralleles Dateisystem mit GPUDirect Storage
  • S3-kompatibler Objektspeicher
  • Snapshots, Backup und externe Kopien
  • Vektordatenbank für RAG

Plattform

  • Kubernetes mit dem NVIDIA oder AMD GPU Operator
  • Slurm oder ein Kubernetes-Batch-Scheduler für Trainingsjobs
  • GPU-Sharing: MIG, Time-Slicing oder vGPU
  • Kontingente und Prioritäten pro Team
  • Image-Registry und Infrastructure as Code

KI-Dienste

  • Model Serving: vLLM, SGLang, NVIDIA Dynamo und NIM oder AMD-ROCm-Images
  • Ein Modellkatalog mit freigegebenen offenen und kommerziellen Modellen
  • Chat- und Assistenten-Frontend für Mitarbeitende
  • RAG-Pipelines, angebunden an Ihre Dokumentenspeicher
  • Notebooks, Feintuning und Experiment-Tracking (MLflow)

Sicherheit und Governance

  • Single Sign-on und rollenbasierter Zugriff
  • Secrets-Management und Verschlüsselung im Ruhezustand und bei der Übertragung
  • Audit-Logs jedes Modellaufrufs und Datenzugriffs
  • Richtlinien dazu, welche Daten jeder Assistent nutzen darf
  • Air-Gap-Option für eingestufte oder regulierte Arbeit

Betrieb

  • Überwachung von GPU-Zustand und -Auslastung (DCGM, Prometheus, Grafana)
  • Kosten- und Nutzungsberichte pro Team
  • Prozess für Patches, Treiber- und Modell-Upgrades
  • Kapazitätsplanung für die nächste GPU-Generation
  • Optionaler Managed Service und Bereitschaftssupport

Zurück zum Inhalt

Privat, öffentlich oder hybrid: im Vergleich

Die üblichen Abwägungen. Die meisten Organisationen landen bei hybrid: eine private Basis für stetige Arbeit und die Public Cloud oder geleaste Kapazität für Spitzen.

KI-Dienste in der Public CloudGPU Private Cloud in einem Colocation-RechenzentrumGPU Private Cloud in Ihren RäumlichkeitenHybrid
Wie Sie bezahlenPro Token, pro Stunde oder pro Benutzer, monatlichHardware gekauft, finanziert oder geleast, plus Rackfläche und StromHardware gekauft, finanziert oder geleast; eigener Strom und eigene KühlungEine private Basis plus nutzungsbasierte Cloud für Spitzen
Am besten, wennIdeen ausprobieren, schwankende oder kurze WorkloadsStetige KI-Nutzung, aber kein geeigneter Serverraum vorhandenStetige Nutzung, strenge Datenvorgaben und ein Standort mit Strom und KühlungStetige Grundlast mit gelegentlichen großen Spitzen
Wo die Daten liegenDie Regionen des AnbietersEin britisches Rechenzentrum Ihrer WahlIhr eigenes Gebäude, auch mit Air Gap möglichSensible Daten privat, der Rest dort, wo es am günstigsten ist
Zeit bis zum StartMinutenWochen bis Monate: Lieferzeiten der Hardware und InstallationWochen bis Monate, länger, wenn am Standort Strom- oder Kühlungsarbeiten nötig sindIn der Cloud starten, stetige Arbeit verlagern, sobald die Hardware eintrifft
Kosten bei wachsender NutzungSteigen mit jedem Benutzer und jedem AufrufKonstant, bis Sie mehr GPUs brauchenKonstant, bis Sie mehr GPUs brauchenKonstante Basis, nutzungsbasierte Spitzen
Latenz zu Ihren SystemenÜber das Internet oder eine private VerbindungGering, mit privater Verbindung zu Ihren StandortenAm geringsten, in Ihrem eigenen NetzwerkGering für private Workloads
Wahl von Modellen und ToolsKatalog und Grenzen des AnbietersAlles, was Sie betreiben könnenAlles, was Sie betreiben könnenBeides
Benötigte KompetenzenCloud- und AnwendungskompetenzPlattform- und GPU-Betrieb oder ein Managed ServicePlattform-, GPU- und Gebäudebetrieb oder ein Managed ServiceBeides, plus Platzierung der Workloads
GPU-VerfügbarkeitNeueste GPUs oft ausverkauft oder rationiertGarantiert nach der InstallationGarantiert nach der InstallationGarantierte Basis, Spitzen nach Verfügbarkeit
Hardware-ErneuerungEntscheidung des AnbietersIhre Entscheidung, alle 3 bis 5 Jahre; ältere GPUs übernehmen leichtere AufgabenIhre Entscheidung, alle 3 bis 5 JahreIhre Entscheidung für die Basis

Zurück zum Inhalt

Eine GPU Private Cloud von Grund auf bauen

Die acht Phasen, die wir mit jeder Private Cloud durchlaufen – vom ersten Workshop bis zu einer Plattform, die Ihre Teams täglich nutzen.

  1. 1

    Workloads und Dimensionierung

    Listen Sie die Assistenten, Agenten, Suchen und Trainingsjobs auf, die Sie betreiben möchten, sowie Modelle, Benutzer und Daten. Wir übersetzen das in GPUs, VRAM, Speicher und Netzwerk.

    Sie entscheiden: Welche Workloads zuerst kommen und wie Erfolg aussieht

  2. 2

    Standort

    Ihr eigener Serverraum, Ihr Rechenzentrum oder eine britische Colocation-Halle. Wir prüfen Strom, Kühlung, Bodenbelastung und Konnektivität oder finden Colocation-Fläche, die für GPU-Racks gebaut ist.

    Sie entscheiden: On-Premises oder Colocation

  3. 3

    Hardware-Design

    GPU-Server (NVIDIA oder AMD, Dell oder NVIDIA DGX), CPU-Knoten, Speicherstufen, Compute-Fabric und Management-Netzwerk, mit Ersatzteilen und Raum für Wachstum.

    Sie entscheiden: GPU-Familie, Hersteller und wie viel Wachstum eingeplant wird

  4. 4

    Finanzierung

    Direkt kaufen, die Kosten per Finanzierungsleasing oder Mietkauf verteilen oder Kapazität leasen, bis Ihre eigene Hardware eintrifft.

    Sie entscheiden: Investition, Finanzierungsleasing oder geleaste Kapazität

  5. 5

    Aufbau und Burn-in

    Lieferung, Einbau ins Rack, Verkabelung und Inbetriebnahme, danach Firmware-Baselines, Fabric-Tests, Speicher-Benchmarks und ein mehrtägiger Burn-in jeder GPU.

    Sie entscheiden: Abnahmetests und Termine

  6. 6

    Plattform

    Kubernetes und die GPU-Operatoren, Scheduler, GPU-Sharing, Image-Registry, Identität, Secrets und Monitoring – alles als Code, damit es neu aufgebaut werden kann.

    Sie entscheiden: Kubernetes, Slurm oder beides

  7. 7

    KI-Dienste

    Model Serving, der Modellkatalog, ein Assistent für Mitarbeitende, RAG über Ihre Dokumente, Notebooks und Feintuning, angebunden an Ihre Systeme.

    Sie entscheiden: Freigegebene Modelle und welche Daten jeder Dienst nutzen darf

  8. 8

    Übergabe und Betrieb

    Runbooks, Schulungen für Ihr Team, Kosten- und Nutzungsberichte sowie entweder Ihr eigener Betrieb oder unser Managed Service.

    Sie entscheiden: Wer sie im Alltag betreibt

Zurück zum Inhalt

Ausprobieren: das Labor für private KI-Clouds

Vier Wege, die Optionen für Ihre eigenen KI-Workloads zu erkunden. Ihre Eingaben verlassen Ihren Browser nur, wenn Sie sie uns bewusst senden.

Sechs Fragen, eine pro Station. Am Ende erhalten Sie ein Ausgangsdesign: Hardware, VRAM, Speicher, Netzwerk, Strom und Plattform, dazu die nächsten Schritte.

1Workload2Umfang3Modelle4Daten5Standort6Bezahlung

1 of 6

Was soll zuerst darauf laufen?

Zurück zum Inhalt

FAQ zur GPU Private Cloud

Wie klein kann eine GPU Private Cloud sein?
Ein einzelner PCIe-Server mit einigen RTX PRO 6000 GPUs, auf dem dieselbe Plattform läuft wie auf einem großen Cluster, ist eine echte private Cloud. Viele Kunden beginnen so oder mit DGX Spark für die Entwicklung und ergänzen Server, wenn die Nutzung wächst.
NVIDIA oder AMD?
Beides funktioniert. NVIDIA hat die breiteste Softwareunterstützung und die meisten sofort einsetzbaren KI-Dienste. AMD Instinct bietet viel Speicher pro GPU, was gut zur Inferenz großer Modelle passt, und führt die wichtigsten Open-Source-Frameworks auf ROCm aus. Wir dimensionieren beide und empfehlen die Lösung, die zu Ihren Modellen und Ihrem Team passt.
Können wir Open-Source-Modelle nutzen?
Ja. Open-Weight-Modelle laufen auf vLLM, SGLang und ähnlichen Servern neben kommerziellen Modellen und Ihren eigenen feinabgestimmten Modellen. Wir helfen Ihnen bei der Modellauswahl und beim Aufbau eines freigegebenen Katalogs.
Muss sie in unseren Räumlichkeiten stehen?
Nein. Viele private Clouds laufen in einem Colocation-Rechenzentrum im Vereinigten Königreich mit der Stromversorgung und Kühlung, die GPU-Racks brauchen, und sind privat mit Ihren Standorten verbunden. Die Hardware gehört trotzdem exklusiv Ihnen.
Wie lange dauert es?
Eine Private Cloud für den Einstieg kann wenige Wochen nach Eintreffen der Hardware laufen. Größere Cluster hängen von GPU-Lieferzeiten und Arbeiten am Standort ab; Sie erhalten in der Designphase einen terminierten Plan, und wir können in der Zwischenzeit Kapazität leasen.
Können Sie sie für uns betreiben?
Ja. Wir können die gesamte Plattform als Managed Service betreiben oder sie aufbauen, Ihr Team schulen und es unterstützen.
Wie bezahlen wir dafür?
Direkt kaufen, die Kosten mit einem Finanzierungsleasing oder Mietkauf verteilen oder Kapazität monatlich leasen. Die Optionen finden Sie unter GPU-Leasing.

Verwandte Seiten

KI-Rechenzentren · GPU-Cluster · GPU-Leasing · Private KI · AI Factory · MLOps-Einrichtung

Zurück zum Inhalt

Planen Sie Ihre GPU Private Cloud

Nennen Sie uns Workloads, Nutzer und Datenregeln oder senden Sie Ihre Antworten aus dem Konfigurationsweg, und wir melden uns mit einem Design, einem terminierten Plan und den Kosten für Kauf, Finanzierung oder Leasing.

Sprechen Sie mit uns über eine Private CloudGPU-Server ansehen