Der Shop ist online

Wir bauen Workstation AI-Maschinen für Websites, KI-Agenten und LLM-Training – online konfigurieren und kaufen.

Händlerpreise erhalten
KI-Produkte
KI-LabsOpenAI-AgentenClaude-AgentenGrok-BotWorkstation AI-natives CRMMarketingAlle Produkte
KI-Lösungen
Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI-WorkstationsNVIDIA-Hardware & -SoftwareNVIDIA Accelerated ComputingPrivate KIGPU-Private-CloudGPU-ClusterEdge-KIKI nach Branche
KI-Services
PlattformmodernisierungDigital EngineeringDatengrundlagen & KIAutonomer BetriebKI-BeratungDevOps-AutomatisierungCybersicherheitSoftwareentwicklungAgentenentwicklungMLOps-EinrichtungGPU-LeasingGPU-Private-Cloud
Über uns
UnternehmenUnsere GeschichtePartnerKundengeschichten
KI-Rechenzentren
KI-RechenzentrenGPU-Private-CloudGPU-ClusterGPU-Leasing
KI-EinblickeJev-ReiheBenchmark LabModellauswahl
Technische Hinweise
Dokumentation
Linux-BetriebssystemeUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
KI-Cloud-PlattformenAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-Clouds & Marktplätze
Private KI-RechenzentrenFür AnwaltskanzleienFür Steuer- und WirtschaftsprüfungskanzleienOn-Premises-PlattformenVollständig abgesicherte Cloud
ToolsRing PromoterJobshout
News
Blog
KontaktAnmelden

KI-Workstations, Multi-Agenten-KI-Software, GPU-Infrastruktur und intelligente Agentenlösungen für moderne Unternehmen.

Kontakt

KI-Lösungen

Angewandte KIKI-AgentenGenerative KIKI-AutomatisierungKI-WeiterbildungKI-Pakete für KMUEnterprise AI LabKI nach Branche

Produkte

Alle ProdukteWorkstation AI-natives CRM & ERPMarketingOpenAI-AgentenRing PromoterJobshout

Unternehmen

Über unsUnternehmenKI-RechenzentrenWarum WorkstationPartnerKundengeschichtenPreiseKontaktTenthMatrix

Ressourcen

KI-EinblickeTechnische HinweiseDokumentationLinux-BetriebssystemeKI-Cloud-PlattformenPrivate KI-RechenzentrenBlogSucheSitemap
Büro Belgien
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Mo – Fr: 9:00 – 18:00 Uhr MEZ
+32 492 45 67 46
Hauptsitz Großbritannien
77-79 Marlowes, Hemel Hempstead HP1 1LFAnfahrt – Ausfahrt 20 der M25 (Outer London)Handelsregisternr.: 11641870Mo – Fr: 9:00 – 18:00 Uhr GMT
+44 7515 356 146
Büro Indien
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Büro Taiwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Mo – Fr: 9:00 – 18:00 Uhr Taiwan-Zeit (GMT+8)
+886 926 892 701+32 492 45 67 46
Büro Estland
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaMo - Fr: 9:00 - 18:00 Uhr estnischer Zeit (EET)
+32 492 45 67 46

© 2026 Workstation AI. Alle Rechte vorbehalten.

DatenschutzDatenlöschungCookiesNutzungsbedingungenWebsite-Sitemap

NVIDIA, das NVIDIA-Logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX und HGX sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den USA und anderen Ländern. AMD, das AMD-Arrow-Logo, EPYC, Instinct, Ryzen und Threadripper sind Marken von Advanced Micro Devices, Inc. Dell und PowerEdge sind Marken der Dell Inc. oder ihrer Tochtergesellschaften. Intel und Xeon sind Marken der Intel Corporation oder ihrer Tochtergesellschaften. AMAX, AceleMax und LiquidMax sind Marken der AMAX Engineering Corporation. Alle anderen Produktnamen, Logos und Marken sind Eigentum ihrer jeweiligen Inhaber. Wir verwenden sie ausschließlich, um die Produkte zu kennzeichnen, die wir beschreiben, liefern oder unterstützen; ihre Verwendung bedeutet nicht, dass ihre Inhaber uns empfehlen.

NVIDIA-Partner · UK

NVIDIA Accelerated Computing Lösungen

Von einer einzelnen Rechenzentrums-GPU bis zur flüssigkeitsgekühlten KI-Fabrik im Rack-Maßstab: Workstation dimensioniert, liefert, baut, installiert und betreut das gesamte NVIDIA-Accelerated-Computing-Sortiment für Organisationen in Großbritannien.

Sortiment ansehenMit einem Engineer sprechen
  • 34NVIDIA-Systeme, GPUs, Networking- und Softwareprodukte
  • 5Schritte, von der Dimensionierung bis zum langfristigen Support
  • UKEngineering, Aufbau und Burn-in-Tests

Accelerated Computing ohne Integrationsrisiko

Accelerated Computing verlagert die rechenintensivsten Teile eines Workloads, etwa KI-Training, Inferenz, Simulation, Analytik und Rendering, von universellen CPUs auf GPUs und spezialisierte Prozessoren. Das Ergebnis: mehr Arbeit pro Rack und pro Watt und Ergebnisse in Stunden statt Tagen.

Dafür braucht es mehr als eine GPU. Jeder Beschleuniger benötigt einen Server, der ihn mit Strom versorgen und kühlen kann, ein Netzwerk, das ihn mit Daten versorgt, und Software, die lizenziert und unterstützt ist. Als NVIDIA-Partner mit eigenen Ingenieuren fügen wir diese Bausteine zu einem getesteten System zusammen und bleiben auch nach der Inbetriebnahme an Ihrer Seite.

  • Unabhängige Beratung, welche NVIDIA-Plattform zu Ihren Workloads passt
  • Vollständige, NVIDIA-zertifizierte Konfigurationen statt Einzelteilen
  • In unserer Werkstatt in Großbritannien gebaut, mit Image versehen und Burn-in-getestet
  • Bei Ihnen vor Ort installiert, verkabelt und in Betrieb genommen
  • Ein Ansprechpartner in Großbritannien für Support, Upgrades und Garantie

Woraus ein beschleunigtes System besteht

Vier Schichten arbeiten zusammen. Wir spezifizieren alle vier, damit keine davon zum Engpass wird.

GPUs

Erledigen die parallele Mathematik hinter KI, Simulation und Grafik. Speichergröße und Bandbreite entscheiden meist, welche GPU Sie brauchen.

CPUs und Systeme

Versorgen die GPUs mit Daten, führen das Betriebssystem aus und halten Daten im Arbeitsspeicher. Das Gehäuse bestimmt Stromversorgung, Kühlung und wie viele GPUs hineinpassen.

Networking und DPUs

Übertragen Daten zwischen GPUs, Servern und Storage. DPUs nehmen der CPU Netzwerk-, Storage- und Sicherheitsaufgaben ab.

Software

Treiber, CUDA, KI-Frameworks und Cluster-Tools machen aus Hardware eine Plattform, die Ihre Teams nutzen können.

Warum Organisationen auf Accelerated Computing umsteigen

Workloads wachsen den CPUs über den Kopf

KI-Modelle und Datensätze wachsen schneller als die CPU-Leistung. Jobs überschreiten ihre Laufzeit, Service-Levels sinken und die Stromrechnungen steigen.

Workflows werden kompliziert

Datenaufbereitung, Training, Inferenz und Visualisierung laufen oft auf getrennter Hardware. Eine beschleunigte Plattform vereinfacht die Pipeline.

Neue Anwendungen schaffen neue Silos

KI neben bestehenden Anwendungen einzuführen, kann zu Hardware-Inseln führen. Eine gemeinsame, zertifizierte Plattform hält alles beherrschbar.

Das Sortiment

NVIDIA Accelerated Computing Produkte

Jedes der unten aufgeführten Systeme, GPUs, Netzwerkprodukte und Softwarelizenzen ist einzeln oder als Teil eines Komplettsystems erhältlich. Filtern Sie nach Typ, vergleichen Sie die wichtigsten Spezifikationen und fordern Sie ein Angebot an.

Systeme und Plattformen

NVIDIA Vera Rubin NVL72

Rack-Scale-System für agentische KI und die größten Modelle

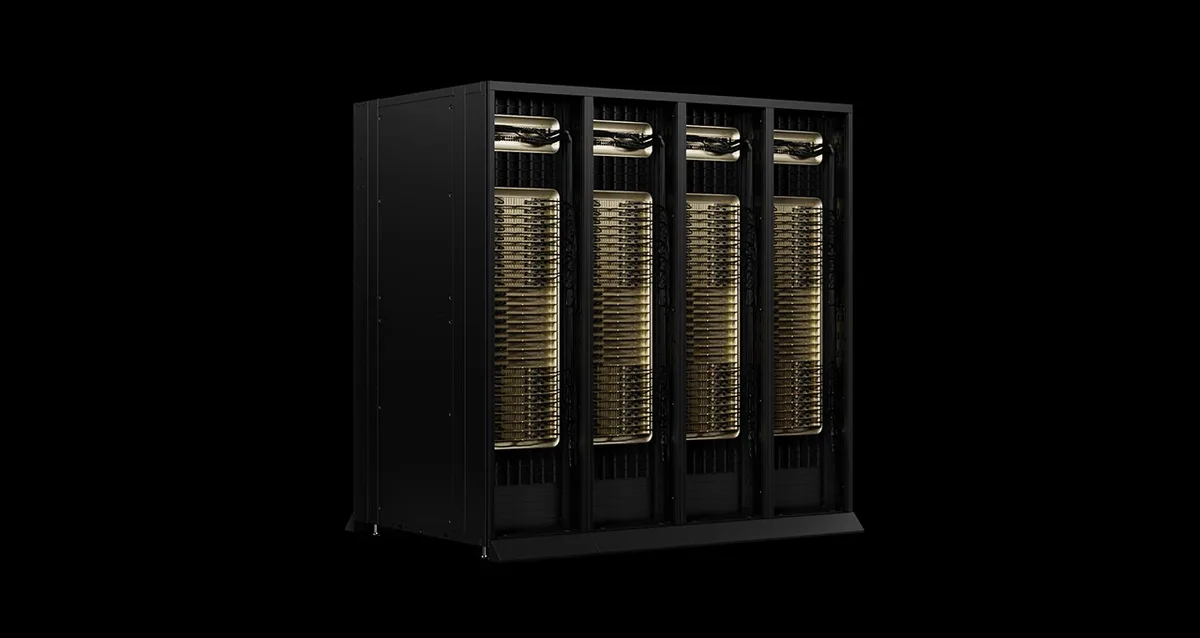
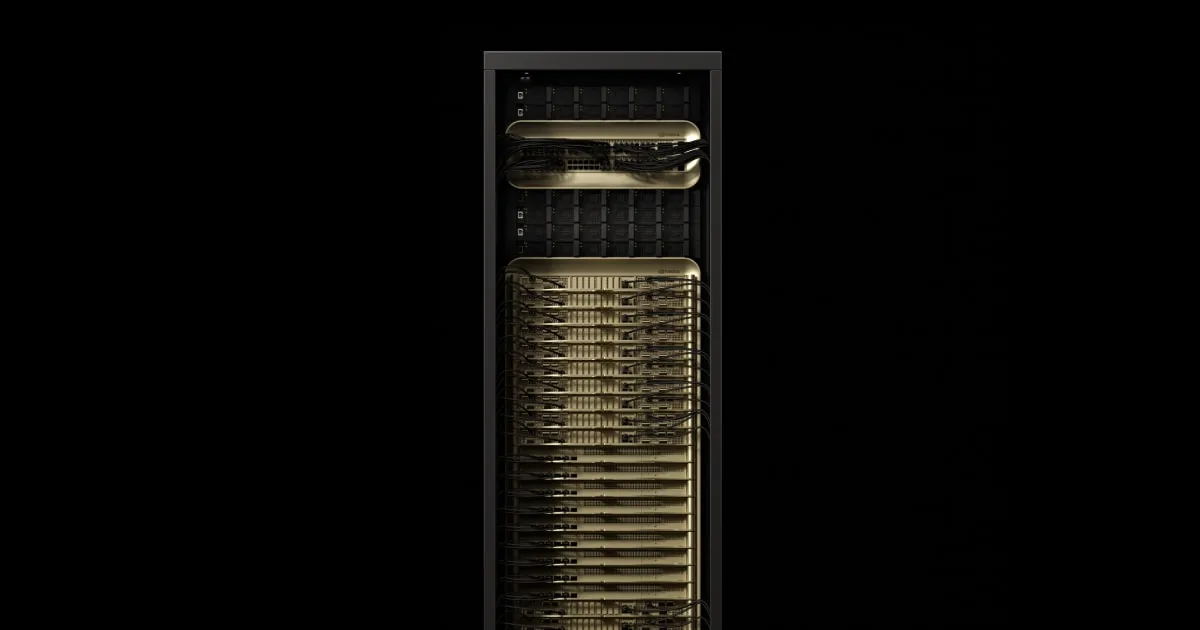
NVIDIAs neueste Rack-Scale-Generation verbindet 72 Rubin-GPUs und 36 Vera-CPUs in einer NVLink-Domäne, sodass sich ein einzelnes Rack wie ein einziger sehr großer Beschleuniger verhält.

Für wen es passt: KI-Fabriken, Modellentwickler und Service-Provider, die ihre nächste große Installation planen

Vorteile

  • Laut NVIDIA weit mehr Tokens pro Megawatt als die Grace-Blackwell-Generation
  • HBM4-Speicher, ausgelegt für Modelle mit Billionen Parametern und langem Kontext
  • Modulare, kabellose Einschübe, die die Wartung im Rack vereinfachen

Wichtige Spezifikationen

Konfiguration72× Rubin GPU, 36× Vera CPU
GPU-Speicher20.7 TB HBM4 | 1,400 TB/s
NVFP4-Inferenz3,600 PFLOPS (sparse)
NVLink-Bandbreite216 TB/s (sixth generation)
CPU-SpeicherUp to 54 TB LPDDR5X
FormfaktorRack, third-generation MGX NVL72

Was Workstation leistet: Wir prüfen frühzeitig Stromversorgung, Kühlung und Bodenbelastbarkeit am Standort, sichern die Zuteilung und planen Lieferung, Installation und Inbetriebnahme rund um Ihren Rechenzentrumsraum.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

NVIDIA GB300 NVL72 (DGX GB300)

Flüssigkeitsgekühltes Blackwell-Ultra-Rack für KI-Reasoning

36 Grace-CPUs und 72 Blackwell-Ultra-GPUs teilen sich eine NVLink-Fabric in einem einzigen flüssigkeitsgekühlten Rack. NVIDIA liefert es auch als DGX GB300.

Für wen es passt: Organisationen, die Reasoning-Modelle für viele Nutzer bereitstellen, und Teams, die im Frontier-Maßstab trainieren

Vorteile

  • Ein großer Sprung bei Tokens pro Sekunde und Nutzer gegenüber Hopper-basierten Systemen
  • 37 TB schneller Speicher halten lange Kontexte und große Modelle in einer Domäne
  • ConnectX-8 SuperNICs geben jeder GPU einen 800-Gb/s-Pfad ins Netzwerk

Wichtige Spezifikationen

GPUs72× Blackwell Ultra
CPUs36× Grace (2,592 Arm Neoverse V2 cores)
GPU-Speicher20 TB | up to 576 TB/s
Schneller Speicher37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
NVLink-Bandbreite130 TB/s

Was Workstation leistet: Wir planen Flüssigkeitskühlung und Stromversorgung mit Ihrem Facility-Team, koordinieren die Lieferung des integrierten Racks und nehmen es auf eine validierte Basiskonfiguration in Betrieb.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

NVIDIA GB200 NVL72 (DGX GB200)

Grace-Blackwell-System im Rack-Maßstab in einer NVLink-Domäne

Das erste Grace-Blackwell-Rack: 72 Blackwell-GPUs und 36 Grace-CPUs, über NVLink verbunden und flüssigkeitsgekühlt, für sehr große Trainingsläufe und Echtzeit-Inferenz.

Für wen es passt: Teams, die Modelle mit Billionen Parametern trainieren oder bereitstellen und einen großen, gemeinsamen GPU-Speicherpool benötigen

Vorteile

  • Echtzeit-Inferenz bei sehr großen Sprachmodellen, laut NVIDIA um ein Vielfaches schneller als H100
  • Flüssigkeitskühlung erhöht Dichte und Energieeffizienz
  • NVLink der fünften Generation bietet 1,8 TB/s zwischen zwei beliebigen GPUs

Wichtige Spezifikationen

Konfiguration72× Blackwell GPU, 36× Grace CPU
GPU-Speicher13.4 TB HBM3E | 576 TB/s
NVFP4-Tensor-Core1,440 PFLOPS sparse | 720 PFLOPS dense
NVLink-Bandbreite130 TB/s
CPU-Speicher17 TB LPDDR5X | 14 TB/s
KühlungLiquid cooled

Was Workstation leistet: Wir prüfen Ihren Standort auf Flüssigkeitskühlung, steuern Lieferung und Integration in Ihr Netzwerk und Storage und betreuen das Rack nach der Inbetriebnahme.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

NVIDIA DGX B300

Acht Blackwell-Ultra-GPUs in einem DGX-System

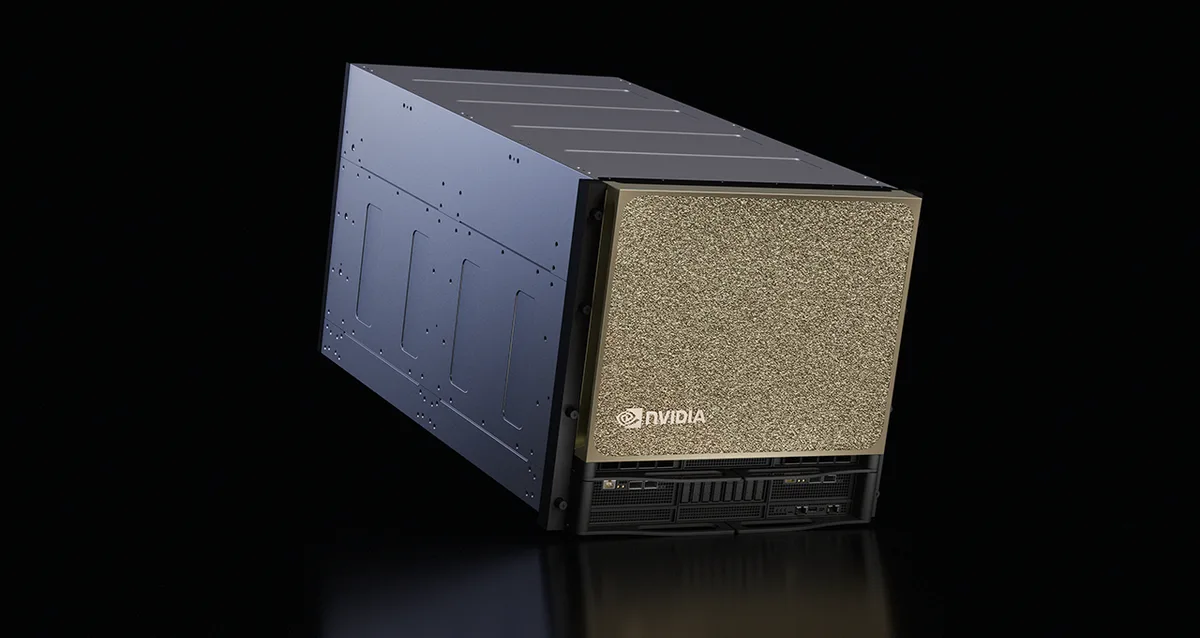
Ein eigenständiger DGX-Server mit acht Blackwell-Ultra-GPUs, NVIDIA-Networking und dem vollständigen DGX-Software-Stack, bereit für den Einzelbetrieb oder die Einbindung in einen BasePOD oder SuperPOD.

Für wen es passt: Unternehmen, die ihre erste ernsthafte KI-Fabrik aufbauen, und Teams, die NVIDIAs Referenzdesign statt eines individuellen Aufbaus wünschen

Vorteile

  • 2,3 TB GPU-Speicher in einem einzigen Knoten für große Modelle
  • Integriertes ConnectX-8- und BlueField-3-Networking für die Skalierung
  • Die DGX-Software hält jeden Knoten in einem Cluster vom ersten Tag an konsistent

Wichtige Spezifikationen

GPUs8× Blackwell Ultra
GPU-Speicher2.3 TB total
KI-Leistung72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
Netzwerk8× ConnectX-8, 2× BlueField-3 DPU

Was Workstation leistet: Wir prüfen Rack-Stromversorgung und Luftstrom, liefern das System, bauen es ins Rack ein, binden es an Ihre Fabric an und übergeben es mit validiertem DGX OS und validierten Treibern.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

NVIDIA DGX B200

Bewährtes Blackwell-DGX für Training und Inferenz

Acht per NVLink verbundene Blackwell-GPUs in einem einzigen DGX-Gehäuse, ein weit verbreiteter Baustein für On-Premises-KI.

Für wen es passt: Teams, die von Hopper oder Cloud-GPUs auf eine eigene Blackwell-Plattform umsteigen

Vorteile

  • Eine Plattform für Training, Feintuning und Inferenz
  • 1.440 GB GPU-Speicher über acht per NVLink verbundene GPUs
  • Passt beim Wachstum in BasePOD- und SuperPOD-Referenzdesigns

Wichtige Spezifikationen

GPUs8× Blackwell
GPU-Speicher1,440 GB total
KI-Leistung72 PFLOPS training, 144 PFLOPS inference
Netzwerk8× ConnectX-7, 2× BlueField-3 DPU

Was Workstation leistet: Wir dimensionieren es anhand Ihrer Modelle, liefern und installieren es und richten Treiber, CUDA und NVIDIA AI Enterprise vor der Übergabe ein.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

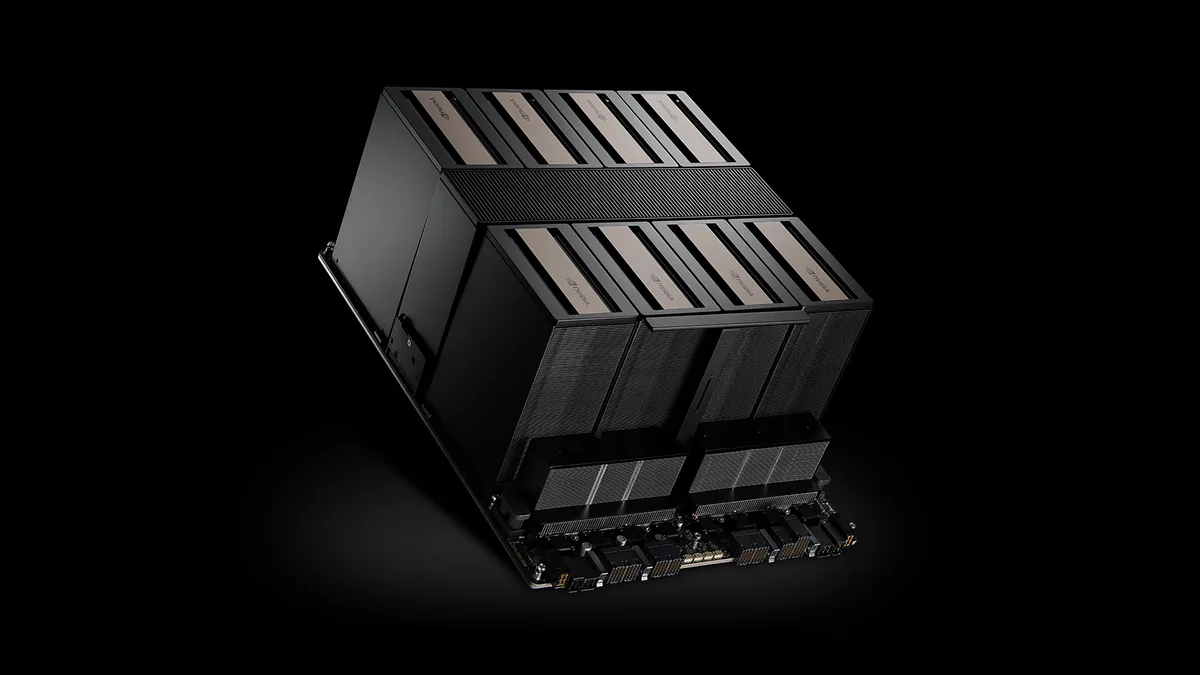
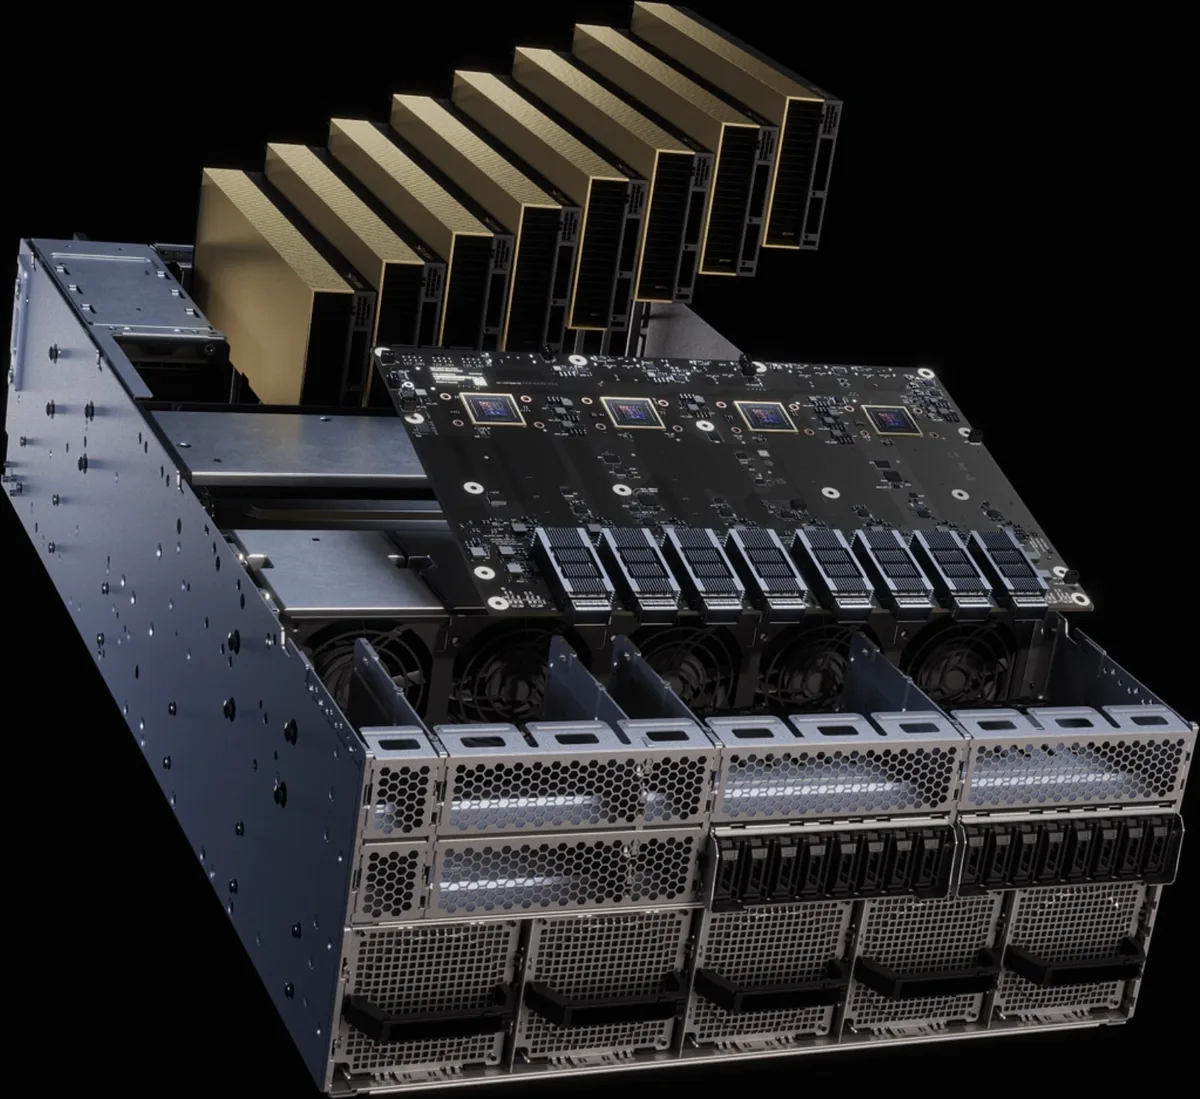
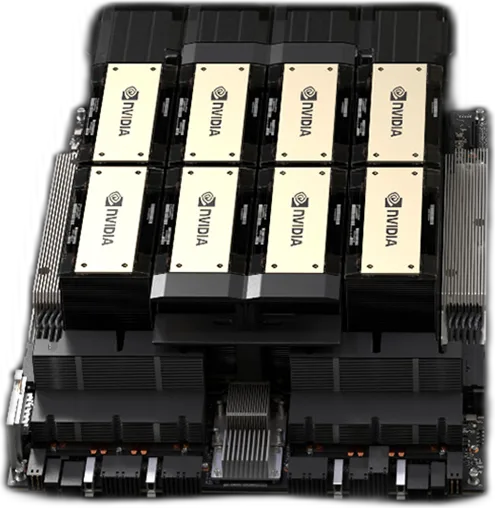
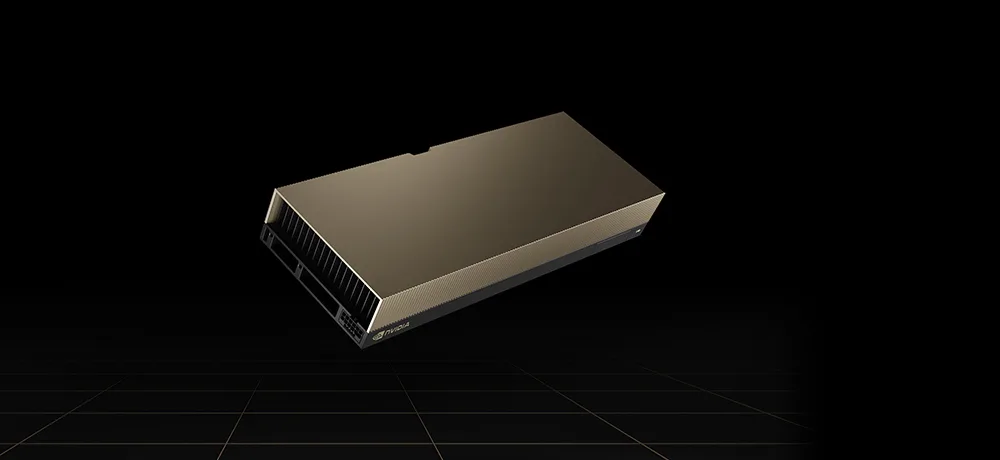
NVIDIA HGX

Baseboard mit acht GPUs in Partner-Servern

HGX ist NVIDIAs per NVLink verbundenes GPU-Baseboard, das Serverhersteller in ihre eigenen Systeme einbauen. So erhalten Sie Spitzen-GPUs mit dem Gehäuse, der CPU und der Support-Marke Ihrer Wahl.

Für wen es passt: Organisationen, die Flaggschiff-GPUs von ihrem bevorzugten Serverhersteller möchten

Vorteile

  • Wählen Sie die Servermarke, CPU und den Storage, die zu Ihrer Umgebung passen
  • NVLink und NVSwitch verbinden alle acht GPUs mit voller Geschwindigkeit
  • Umfasst die Generationen Blackwell, Blackwell Ultra und Rubin

Wichtige Spezifikationen

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
NVLink-Bandbreite14.4 TB/s total (HGX B300 and B200)

Was Workstation leistet: Wir beschaffen den HGX-Server von der Marke Ihrer Wahl, führen in unserer Werkstatt einen Burn-in unter Volllast durch und installieren ihn mit Ihrem Netzwerk.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

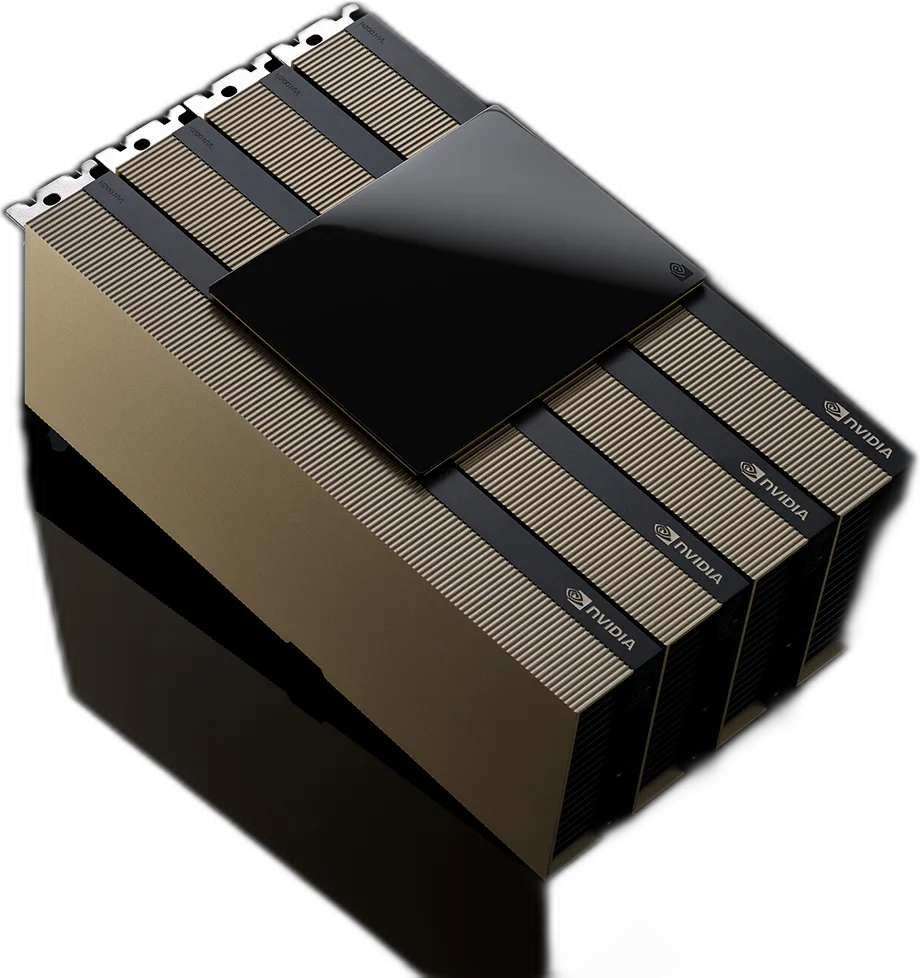
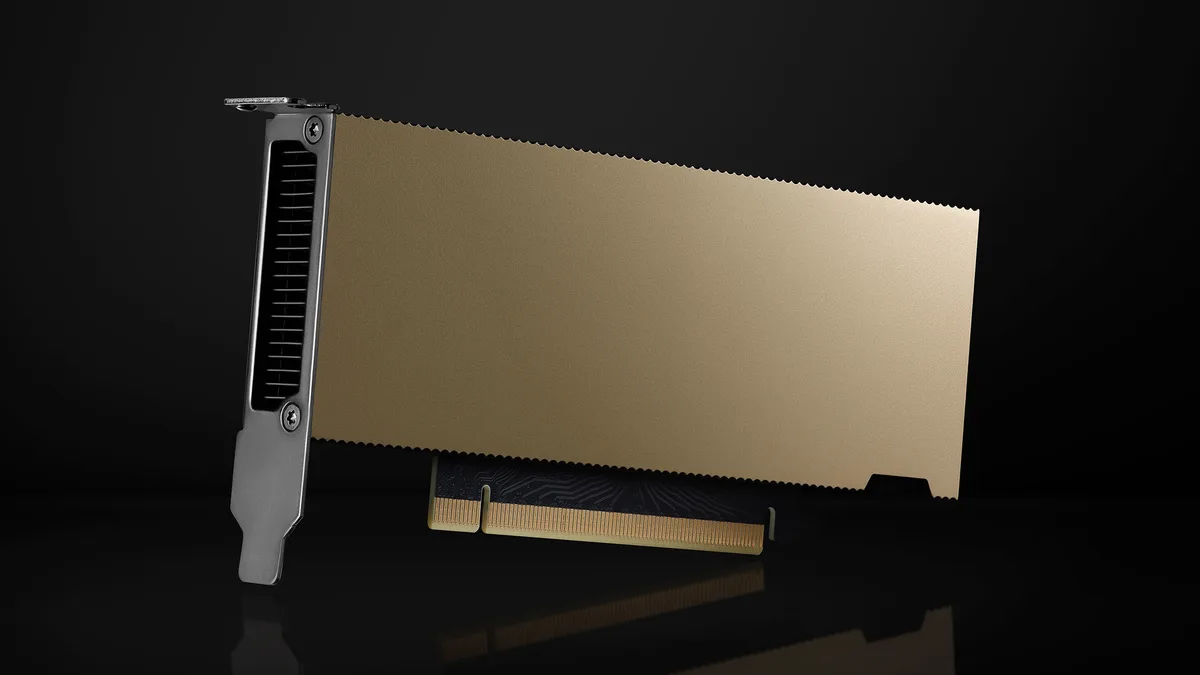
NVIDIA RTX PRO Server

Universeller Blackwell-Server für Enterprise-KI und Grafik

Ein Rechenzentrumsserver mit bis zu acht RTX PRO 6000 Blackwell Server Edition GPUs, der KI, Simulation, Rendering und virtuelle Workstations auf einer Plattform ausführt. Er ist NVIDIAs Mainstream-Server für Accelerated Computing, und die EGX-Seite verweist jetzt hierher.

Für wen es passt: Unternehmen, die bestehende Rechenzentrums-Workloads neben neuen KI-Diensten auf GPUs verlagern

Vorteile

  • Ein Servertyp für KI-Inferenz, Visual Computing und Data Science
  • Luftgekühlte Optionen passen in die meisten bestehenden Serverräume
  • Validiert mit NVIDIA AI Enterprise und Omniverse

Wichtige Spezifikationen

GPUsUp to 8× RTX PRO 6000 Blackwell Server Edition
GPU-Speicher800 GB (8-GPU configuration)
Speicherbandbreite13 TB/s (8-GPU configuration)
RTX-Grafik3 PFLOPS
KonfigurationenMGX 2U, 4U and 6U (6U liquid cooled)

Was Workstation leistet: Wir spezifizieren Gehäuse und GPU-Anzahl anhand Ihrer Workloads, prüfen die NVIDIA-Zertifizierung und bauen, testen per Burn-in und installieren das System.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

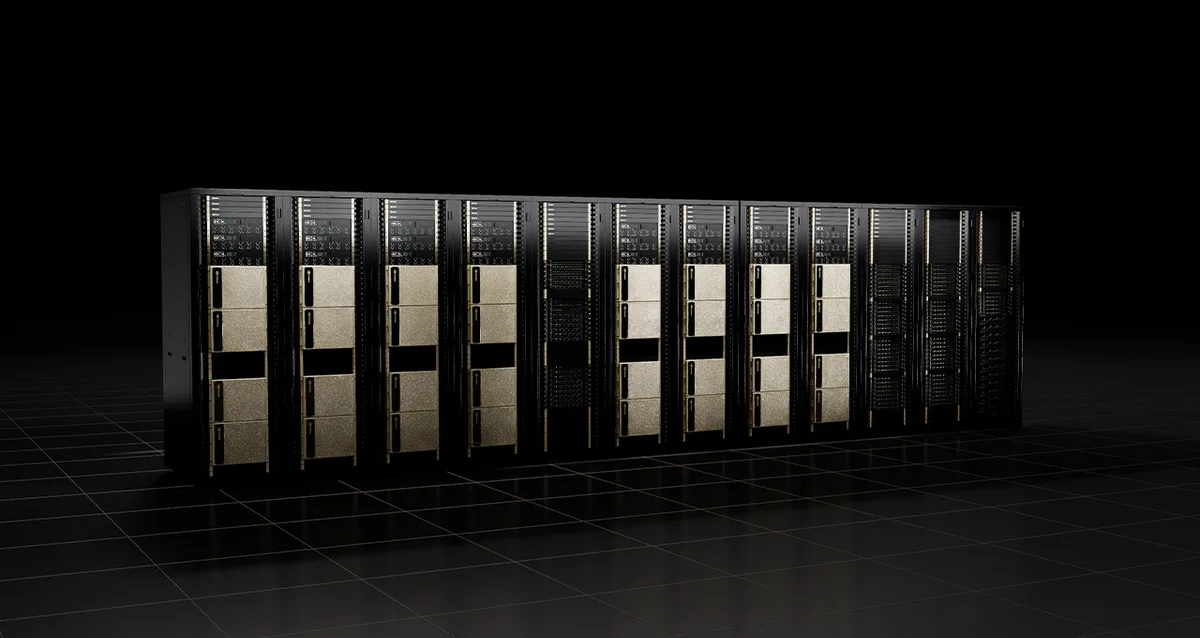
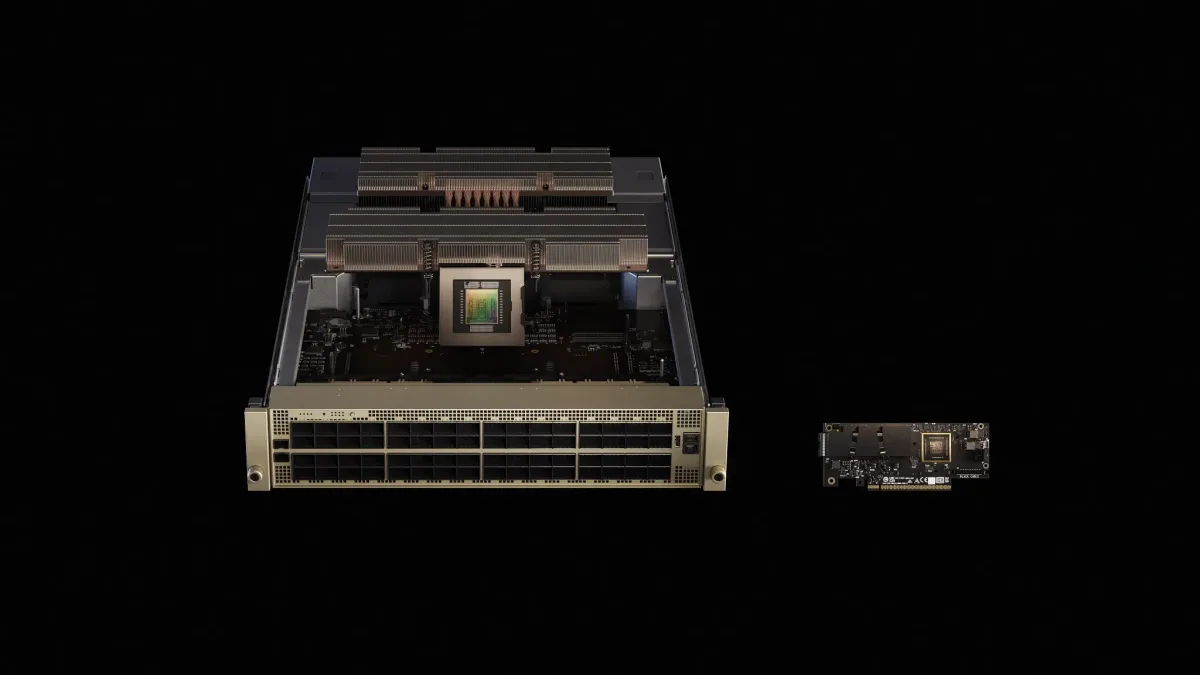
NVIDIA DGX SuperPOD

Schlüsselfertiger Bauplan für KI-Fabriken im großen Maßstab

Eine Full-Stack-Referenzarchitektur, die DGX-Systeme, NVIDIA-Networking, zertifizierten Storage und Management-Software in wiederholbaren skalierbaren Einheiten kombiniert.

Für wen es passt: Forschungslabore, Großunternehmen und KI-Service-Provider, die Cluster mit Hunderten oder Tausenden von GPUs aufbauen

Vorteile

  • Ein getestetes Design beseitigt einen Großteil des Integrationsrisikos
  • Skaliert in wiederholbaren Einheiten auf Zehntausende GPUs
  • Enthält Mission Control und Base Command Manager für den Betrieb

Wichtige Spezifikationen

TypReference architecture
BausteinScalable units of DGX systems
UmfangUp to tens of thousands of GPUs
SpeicherNVIDIA-certified partner storage
SoftwareNVIDIA AI Enterprise, Base Command Manager, Mission Control

Was Workstation leistet: Wir leiten das Design gemeinsam mit NVIDIA und Storage-Partnern, führen den Projektplan, installieren die skalierbaren Einheiten und bleiben Ihr Support-Ansprechpartner.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

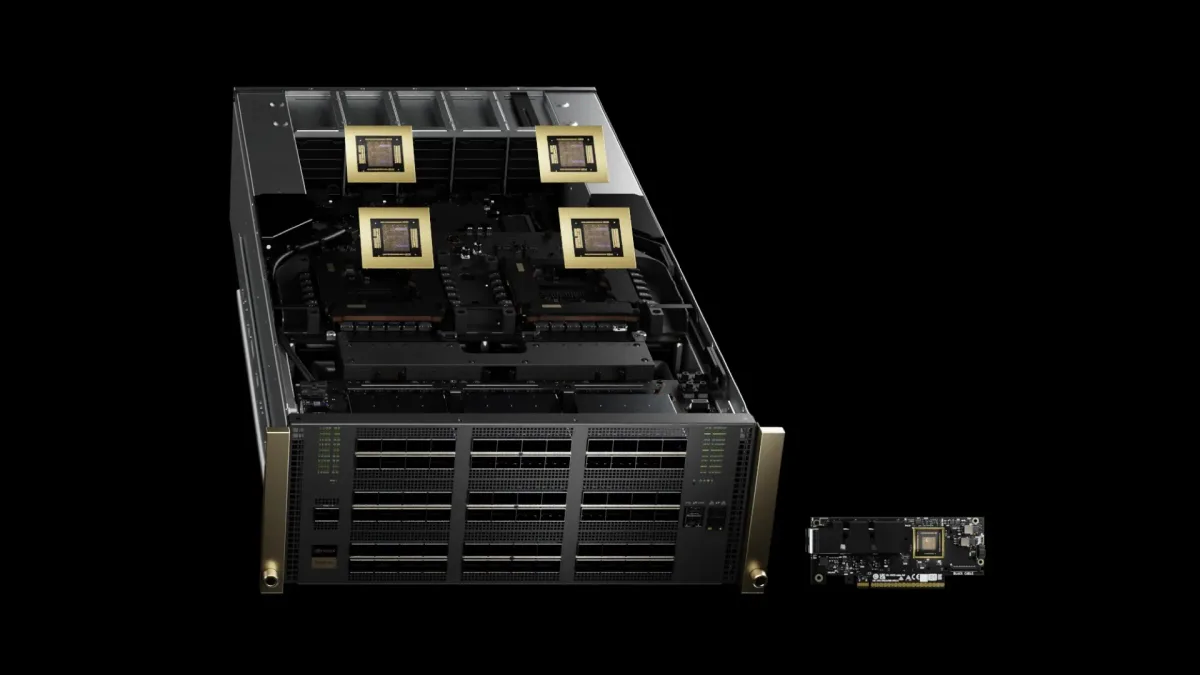
NVIDIA DGX BasePOD

Referenzdesign für Ihren ersten DGX-Cluster

Ein bewährtes Design für zwei oder mehr DGX-Systeme mit passendem Networking, Storage und Cluster-Software: kleiner als ein SuperPOD, aber genauso aufgebaut.

Für wen es passt: Teams, die von einem DGX-System zu einem kleinen gemeinsam genutzten Cluster wachsen

Vorteile

  • Mit zwei Systemen beginnen und weitere ohne Neukonzeption hinzufügen
  • Networking und Storage passend zu den GPUs
  • Cluster-Software für Scheduling und Monitoring inklusive

Wichtige Spezifikationen

TypReference architecture
Umfang2 or more DGX systems
NetzwerkPer reference architecture
SpeicherPartner storage
SoftwareNVIDIA AI Enterprise, Base Command

Was Workstation leistet: Wir dimensionieren den Cluster, liefern alle Komponenten, bauen ihn ins Rack ein, verkabeln ihn und richten das Scheduling ein, damit Ihre Teams ihn vom ersten Tag an gemeinsam nutzen können.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
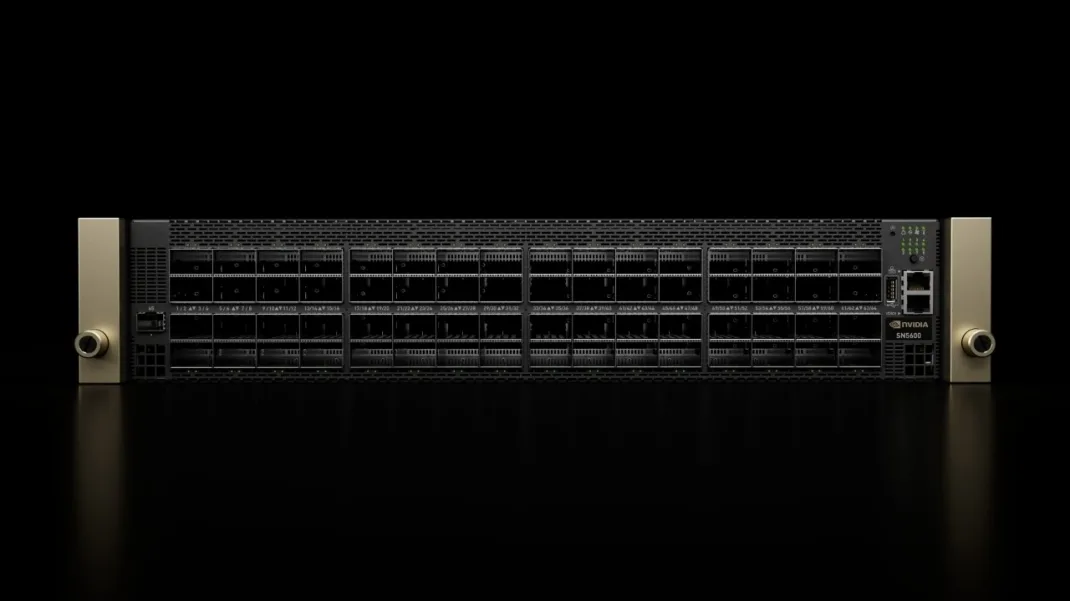
Systeme und Plattformen

NVIDIA Grace und Vera CPUs

Arm-Rechenzentrums-CPUs für KI-Fabriken

NVIDIAs eigene CPUs sind über NVLink-C2C mit den GPUs verbunden. Der Grace CPU Superchip wird heute in Partner-Servern ausgeliefert, und sein Nachfolger Vera zielt auf agentische KI.

Für wen es passt: HPC-Zentren, Cloud-Anbieter und alle, die CPU-lastige Pipelines neben GPUs betreiben

Vorteile

  • Hohe Speicherbandbreite durch LPDDR5X
  • Laut NVIDIA doppelte Leistung bei gleicher Leistungsaufnahme wie führende herkömmliche CPUs
  • Eine kohärente Hochgeschwindigkeitsverbindung zu NVIDIA-GPUs

Wichtige Spezifikationen

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Grace-SpeicherbandbreiteUp to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Was Workstation leistet: Wir finden den Partner-Server, der zu Ihrem Software-Stack passt, testen Ihre Anwendungen gemeinsam mit Ihnen auf Arm und bauen und betreuen dann das Ergebnis.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
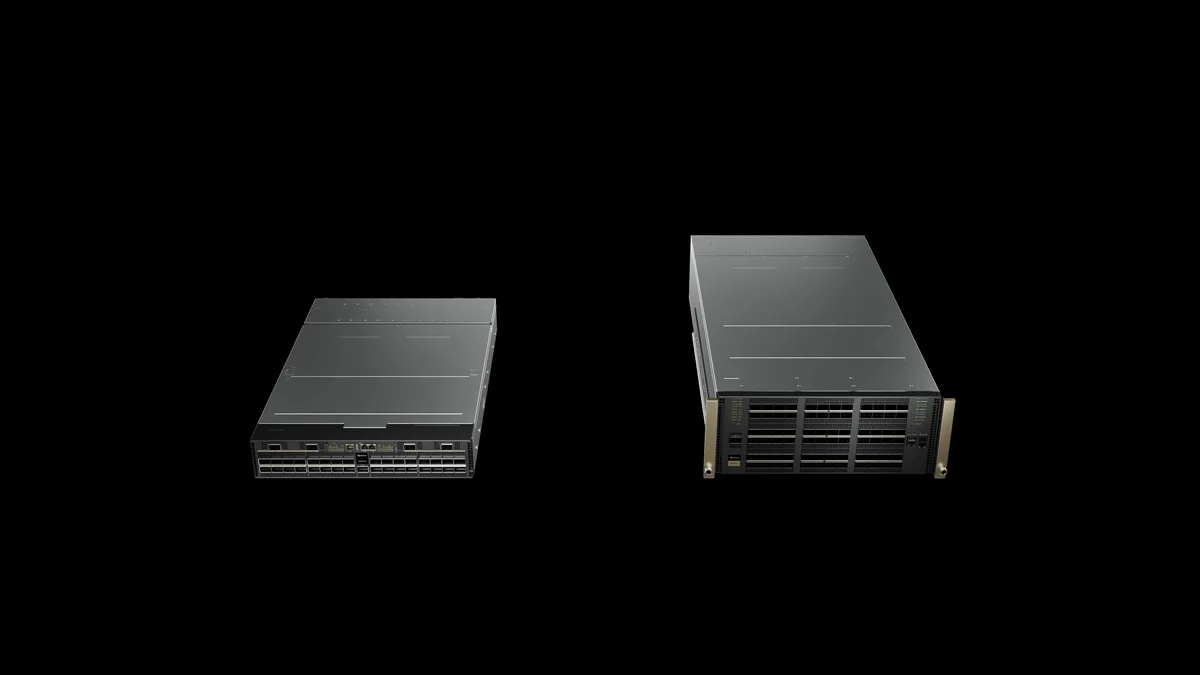
Systeme und Plattformen

NVIDIA OVX

L40S-Server für Omniverse und digitale Zwillinge

OVX ist NVIDIAs validiertes Serverdesign für Omniverse und kombiniert L40S-GPUs mit ConnectX-7- oder BlueField-3-Networking für Simulation, Rendering und KI.

Für wen es passt: Hersteller, Architekten und Engineering-Teams, die industrielle digitale Zwillinge aufbauen

Vorteile

  • Ein Server für Grafik, Simulation und KI-Inferenz
  • Validiert für Omniverse und NVIDIA AI Enterprise
  • Skaliert über Hunderte Server auf einer Hochgeschwindigkeits-Fabric

Wichtige Spezifikationen

GPUs4× or 8× NVIDIA L40S
CPUs2× Intel Xeon Gold or 2× AMD EPYC
Host-Speicher384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
Speicher1 TB NVMe boot, 2× 4 TB NVMe
NetzwerkConnectX-7 or BlueField-3

Was Workstation leistet: Wir bauen Server nach dem OVX-Muster von zertifizierten Partnern, richten Omniverse und Treiber ein und verbinden sie mit Ihren Design-Tools.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

NVIDIA AGX (Jetson AGX Thor)

KI-Computer für Roboter und autonome Maschinen

AGX ist NVIDIAs Plattform für autonome Maschinen. Ihr aktuelles Flaggschiff, Jetson AGX Thor, bringt eine Blackwell-GPU in Roboter, Fahrzeuge und intelligente Maschinen.

Für wen es passt: Robotik-, Automobil- und Industrieteams, die KI in Maschinen bringen

Vorteile

  • Führt Wahrnehmungs- und generative KI-Modelle direkt auf der Maschine aus
  • Geringe Leistungsaufnahme eignet sich für mobile und eingebettete Designs
  • Nutzt dieselbe CUDA-Software wie NVIDIAs Rechenzentrumsplattformen

Wichtige Spezifikationen

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
KI-Leistung2070 TFLOPS (FP4)
OptionenDeveloper kit, or T5000 and T4000 production modules

Was Workstation leistet: Wir liefern Entwicklerkits und Produktionsmodule, helfen bei der Auswahl von Trägerplatinen und Gehäusen und begleiten Sie vom Prototyp bis zum Rollout.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

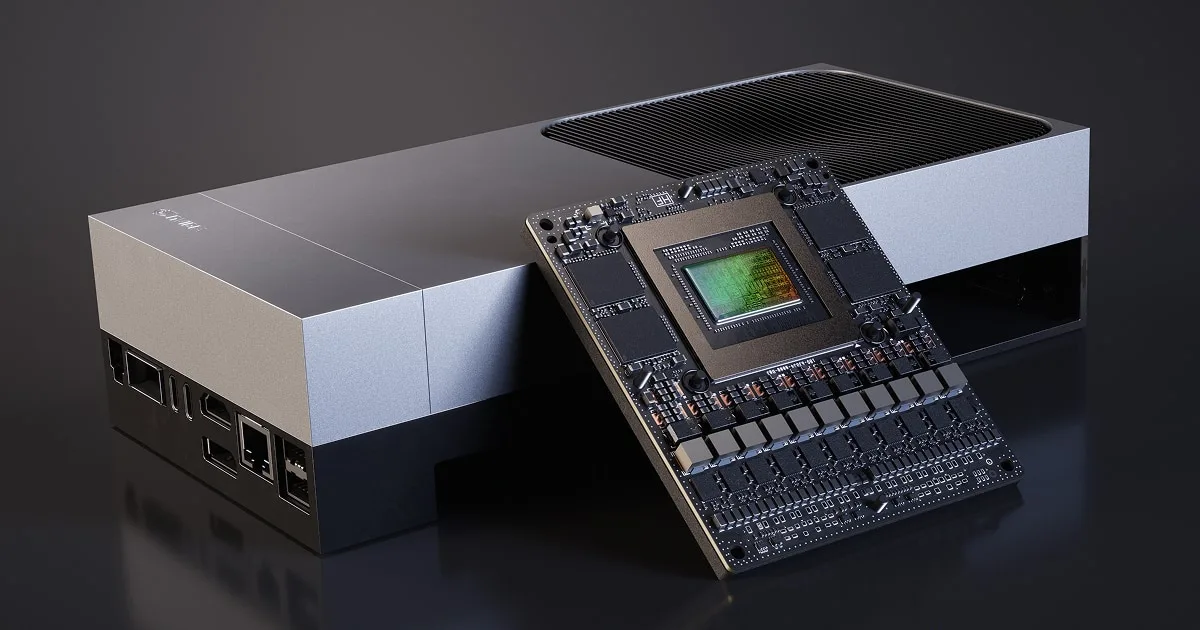
NVIDIA IGX Thor

Industrielle Edge-KI mit funktionaler Sicherheit

IGX ist NVIDIAs Enterprise-Plattform für physische KI am industriellen und medizinischen Edge, mit einer dedizierten Safety Island und langfristigem Software-Support.

Für wen es passt: Medizingerätehersteller, Fabriken und Infrastrukturbetreiber, die eine Sicherheitszertifizierung und eine lange Supportdauer benötigen

Vorteile

  • Design für funktionale Sicherheit, ausgerichtet auf ISO 26262 und IEC 61508
  • Zehn Jahre NVIDIA-Enterprise-Software-Support
  • Optionale RTX PRO Blackwell GPU für anspruchsvollere Modelle

Wichtige Spezifikationen

KI-LeistungUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
Integrierte GPU2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
Arbeitsspeicher128 GB LPDDR5X, 273 GB/s
Stromverbrauch40–130 W, up to 300 W for the discrete GPU

Was Workstation leistet: Wir liefern Entwicklerkits und Produktionssysteme, helfen Ihnen bei der Planung der Zertifizierungsnachweise und unterstützen die Bereitstellung an Ihrem Standort.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Systeme und Plattformen

NVIDIA Groq 3 LPX

Inferenz-Rack mit niedriger Latenz für Vera Rubin

LPX ist ein Rack mit 256 LPU-Inferenzbeschleunigern, das zusammen mit Vera Rubin NVL72 arbeitet, um Tokens schnell und vorhersehbar für interaktive und agentische KI zu erzeugen.

Für wen es passt: KI-Service-Provider, deren Nutzer schnelle, gleichbleibende Antwortzeiten benötigen

Vorteile

  • Deterministische Token-Erzeugung mit niedriger Latenz
  • Laut NVIDIA-Prognosen deutlich höherer Durchsatz pro Megawatt für Modelle mit Billionen Parametern
  • Eine direkte Verbindung mit niedriger Latenz zu NVL72-Racks

Wichtige Spezifikationen

Beschleuniger256 LPUs per rack
On-Chip-Speicher128 GB SRAM per rack (500 MB per LPU)
SRAM-Bandbreite40 PB/s per rack
Scale-up-Bandbreite640 TB/s per rack
FormfaktorNVIDIA MGX ETL rack

Was Workstation leistet: Wir bewerten, wie es zu Ihren Vera-Rubin-Plänen passt, bestätigen die Verfügbarkeit mit NVIDIA und planen die Installation zusammen mit Ihren anderen Racks.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Rechenzentrums-GPUs

NVIDIA H200 (SXM)

Hopper-GPU mit 141 GB HBM3e

Die H200 behält die Hopper-Architektur bei, bietet aber deutlich mehr und schnelleren Speicher, was der Inferenz großer Modelle und speichergebundenem HPC zugutekommt. Die SXM-Version wird in HGX-Server eingebaut.

Für wen es passt: Teams, die große Sprachmodelle und HPC-Codes auf HGX-Servern ausführen

Vorteile

  • 141 GB pro GPU fassen größere Modelle, ohne sie aufzuteilen
  • Höhere Speicherbandbreite beschleunigt speichergebundene Aufgaben
  • Nutzt dieselbe CUDA-Software wie die H100

Wichtige Spezifikationen

ArchitekturNVIDIA Hopper
GPU-Speicher141 GB HBM3e
FormfaktorSXM (HGX)
KühlungPassive (server airflow)

Was Workstation leistet: Wir liefern die H200 in einem zertifizierten HGX-Server, führen den Burn-in durch und installieren sie mit Ihren Treibern und Ihrem Software-Stack.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Rechenzentrums-GPUs

NVIDIA H200 NVL

141-GB-Hopper-GPU für luftgekühlte PCIe-Server

Die PCIe-Version der H200 für Standard-Enterprise-Racks. NVLink-Bridges können Karten für Modelle koppeln, die mehr Speicher benötigen.

Für wen es passt: Unternehmen, die bestehende luftgekühlte Serverräume um Inferenz für große Modelle erweitern

Vorteile

  • Großer GPU-Speicher ohne Umstieg auf Flüssigkeitskühlung
  • NVLink-Bridges verbinden GPUs für größere Modelle
  • Passt in gängige NVIDIA-zertifizierte Server

Wichtige Spezifikationen

ArchitekturNVIDIA Hopper
GPU-Speicher141 GB HBM3e
FormfaktorPCIe, dual slot
KühlungPassive (server airflow)

Was Workstation leistet: Wir prüfen Ihr Gehäuse auf Stromversorgung, Luftstrom und Steckplatzbelegung und bauen, testen und liefern dann die Karten oder einen kompletten Server.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Rechenzentrums-GPUs

NVIDIA H100 PCIe 80 GB

Hopper-GPU für Training und Inferenz in PCIe-Servern

Die PCIe-H100 bringt die Transformer Engine und Confidential Computing von Hopper in Standardserver.

Für wen es passt: Teams mit bestehenden PCIe-GPU-Servern, die bewährte Hopper-Leistung benötigen

Vorteile

  • Die Transformer Engine beschleunigt Training und Inferenz von Sprachmodellen
  • Multi-Instance GPU teilt eine Karte in isolierte Instanzen auf
  • Hardware-Unterstützung für Confidential Computing

Wichtige Spezifikationen

ArchitekturNVIDIA Hopper
GPU-Speicher80 GB HBM2e
FormfaktorDual-slot, full height, full length
KühlungPassive (server airflow)
SchnittstellePCIe

Was Workstation leistet: Wir bauen die H100 in Server ein, für die sie zertifiziert ist, führen den Burn-in durch und richten CUDA, Treiber sowie etwaige vGPU- oder AI-Enterprise-Lizenzen ein.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Rechenzentrums-GPUs

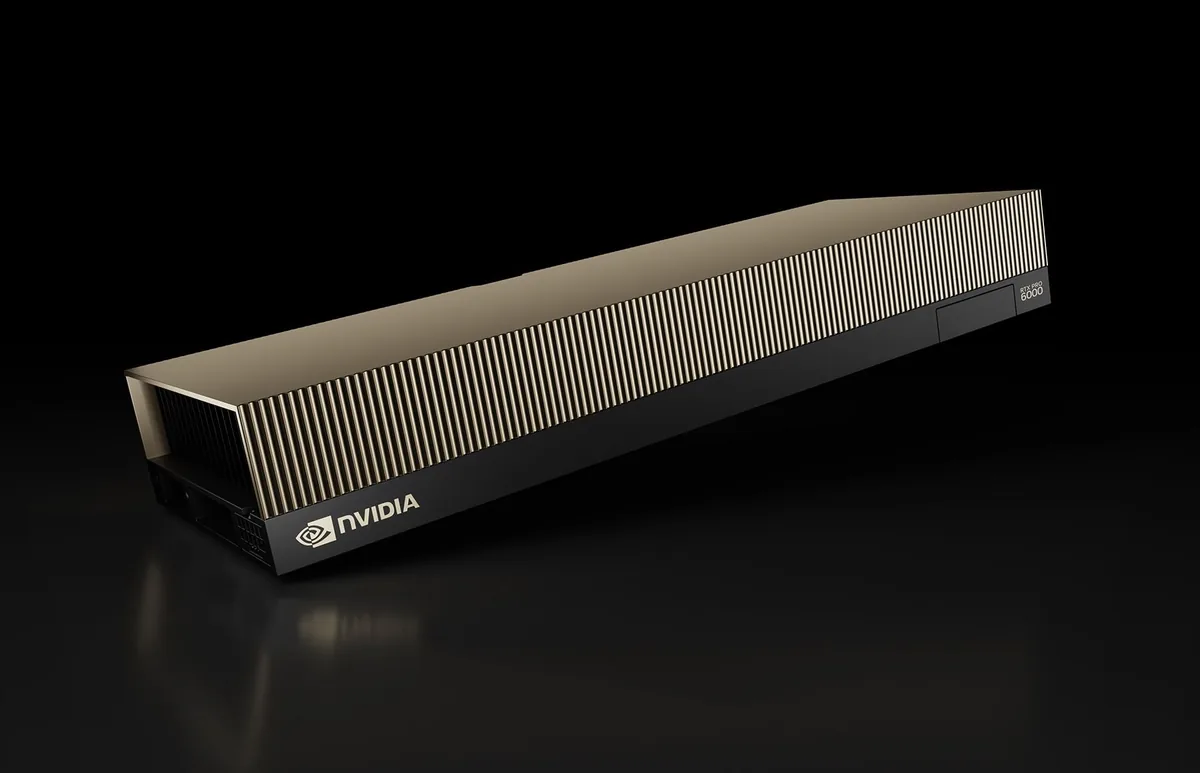
NVIDIA RTX PRO 6000 Blackwell Server Edition

96-GB-Blackwell-GPU für Rack-Server

Eine passiv gekühlte Blackwell-Karte mit 96 GB Speicher für KI-Inferenz, Rendering, Simulation und virtuelle Workstations im Rechenzentrum.

Für wen es passt: Unternehmen, die KI- und Grafik-Workloads auf einem GPU-Typ konsolidieren

Vorteile

  • 96 GB pro GPU bewältigen große Modelle und umfangreiche Szenen
  • Bewältigt sowohl KI als auch professionelle Grafik
  • Konfigurierbare Leistungsaufnahme passend zum Server

Wichtige Spezifikationen

ArchitekturNVIDIA Blackwell
GPU-Speicher96 GB GDDR7 with ECC
Max. LeistungsaufnahmeUp to 600 W (configurable)
SchnittstellePCIe 5.0 x16
FormfaktorDual-slot, passive (server airflow)

Was Workstation leistet: Wir liefern die Karten einzeln oder in einem RTX PRO Server und testen sie vor der Auslieferung unter Volllast.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗
Rechenzentrums-GPUs

NVIDIA RTX PRO 4500 Blackwell Server Edition

Single-Slot-Blackwell-GPU für dichte Server

Eine kompakte, passiv gekühlte 32-GB-Blackwell-GPU, mit der Sie viele Karten in einem Server für Inferenz, Video und virtuelle Desktops unterbringen können.

Für wen es passt: Teams, die Inferenz oder virtuelle Desktops für viele Nutzer zu geringeren Kosten pro GPU skalieren

Vorteile

  • Single-Slot-Design bringt mehr GPUs pro Server unter
  • 32 GB GDDR7 für mittelgroße Modelle
  • Geringere Leistungsaufnahme passt zu bestehenden Racks

Wichtige Spezifikationen

ArchitekturNVIDIA Blackwell
GPU-Speicher32 GB GDDR7
FormfaktorSingle slot, 4.4" H × 10.5" L
KühlungPassive (server airflow)

Was Workstation leistet: Wir ermitteln, wie viele Karten Ihre Server mit Strom versorgen und kühlen können, und bauen und testen dann die Konfiguration.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Rechenzentrums-GPUs

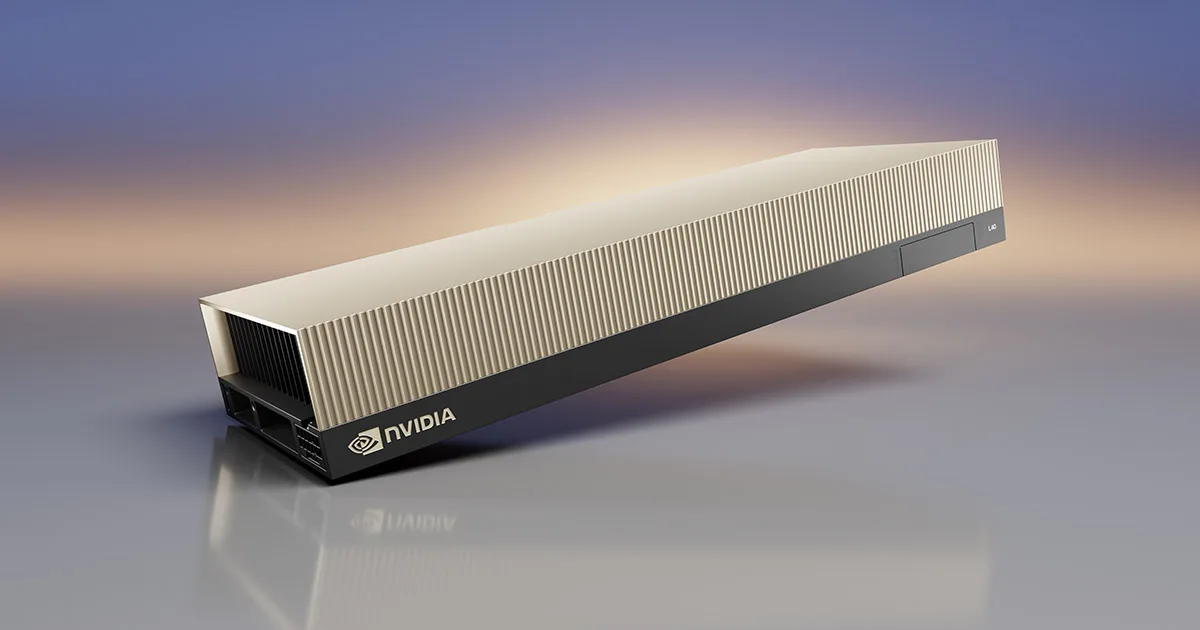
NVIDIA L40S

48-GB-Allrounder für KI und Grafik

Eine Ada-Lovelace-Rechenzentrums-GPU, ausgewogen für Inferenz, Feintuning und 3D-Grafik, und die GPU in NVIDIAs OVX-Design.

Für wen es passt: Teams, die eine GPU für KI- und visuelle Workloads gleichermaßen benötigen

Vorteile

  • Starke Inferenz- und Feintuning-Leistung im Verhältnis zu den Kosten
  • Hardware-Raytracing für Rendering und Omniverse
  • Eine Standard-PCIe-Karte für gängige Server

Wichtige Spezifikationen

ArchitekturNVIDIA Ada Lovelace
GPU-Speicher48 GB GDDR6 with ECC
FormfaktorDual-slot, 4.4" H × 10.5" L
KühlungPassive (server airflow)
SchnittstellePCIe

Was Workstation leistet: Wir kombinieren die L40S mit zertifizierten Servern, führen den Burn-in durch und installieren sie mit eingerichteten Treibern und Lizenzen.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Rechenzentrums-GPUs

NVIDIA L40

48-GB-GPU für Rendering und virtuelle Workstations

Die L40 konzentriert sich auf Grafik: Rendering, Omniverse und virtuelle Workstations im Rechenzentrum.

Für wen es passt: Design- und Medienteams, die Workstations ins Rechenzentrum verlagern

Vorteile

  • 48 GB für große Szenen und Assets
  • Unterstützt NVIDIA Virtual-GPU-Software
  • Passive Kühlung für Standardserver

Wichtige Spezifikationen

ArchitekturNVIDIA Ada Lovelace
GPU-Speicher48 GB GDDR6 with ECC
FormfaktorDual-slot, 4.4" H × 10.5" L
KühlungPassive (server airflow)
SchnittstellePCIe

Was Workstation leistet: Wir richten vGPU-Profile und -Lizenzen ein, damit Ihre Nutzer Remote-Workstations erhalten, die sich wie lokale anfühlen.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Rechenzentrums-GPUs

NVIDIA L4

Low-Profile-GPU für effiziente Inferenz und Video

Eine kleine, sparsame Ada-Lovelace-Karte für Video-KI, Inferenz und virtuelle Desktops – vom Edge bis ins Rechenzentrum.

Für wen es passt: Organisationen, die KI auf viele Server bringen oder an Edge-Standorte mit knappem Energiebudget

Vorteile

  • Geringer Stromverbrauch und Low-Profile-Bauform passen in nahezu jeden Server
  • Gut geeignet für Videoanalyse und Inferenz
  • Skaliert wirtschaftlich über viele Knoten

Wichtige Spezifikationen

ArchitekturNVIDIA Ada Lovelace
GPU-Speicher24 GB GDDR6
FormfaktorSingle-slot, low profile
KühlungPassive (server airflow)
SchnittstellePCIe

Was Workstation leistet: Wir prüfen die Kompatibilität mit Ihren vorhandenen Servern, liefern die Karten und richten Treiber und Inferenzsoftware ein.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Netzwerk

NVIDIA Spectrum-X Ethernet-Plattform

Ethernet, abgestimmt auf KI-Fabriken

Spectrum-X kombiniert Spectrum-Ethernet-Switches mit Spectrum-X SuperNICs und liefert KI-Clustern vorhersehbares Ethernet mit hohem Durchsatz.

Für wen es passt: Organisationen, die ein KI-Fabric wünschen, das ihr Netzwerkteam bereits zu betreiben weiß

Vorteile

  • Höhere effektive Bandbreite für GPU-zu-GPU-Verkehr als Standard-Ethernet
  • Nutzt vertraute Ethernet-Tools und -Kenntnisse
  • Teil der validierten KI-Fabrik-Designs von NVIDIA

Wichtige Spezifikationen

TypEthernet networking platform
KomponentenNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
AnwendungsfallAI clusters and AI factories

Was Workstation leistet: Wir planen das Fabric, liefern Switches, SuperNICs und Kabel, installieren und testen es und dokumentieren es für Ihr Team.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Netzwerk

NVIDIA Quantum-X800 InfiniBand-Plattform

InfiniBand der nächsten Generation für Training im großen Maßstab

Quantum-X800-Switches und ConnectX-8 SuperNICs bilden das leistungsstärkste InfiniBand-Fabric von NVIDIA für KI-Training und HPC.

Für wen es passt: HPC-Zentren und KI-Teams, die im großen Maßstab trainieren

Vorteile

  • Sehr geringe Latenz für eng gekoppelte Jobs
  • Ausgelegt für die größten Trainings- und HPC-Cluster
  • Verwaltet und überwacht mit UFM

Wichtige Spezifikationen

TypInfiniBand networking platform
KomponentenNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
AnwendungsfallLarge-scale AI training and HPC

Was Workstation leistet: Wir planen die Topologie, liefern und verkabeln jede Verbindung und nehmen das Fabric mit eingerichtetem UFM-Monitoring in Betrieb.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Netzwerk

NVIDIA Spectrum Ethernet-Switches

Rechenzentrums-Ethernet-Switches mit bis zu 800 Gb/s

Spectrum-Switches transportieren KI-, Storage- und Cloud-Verkehr – eigenständig oder als Teil von Spectrum-X.

Für wen es passt: Rechenzentrums- und Netzwerkteams, die ihr Leaf- und Spine-Switching erneuern

Vorteile

  • Portgeschwindigkeiten bis zu 800 Gb/s
  • Funktioniert in KI-Fabrics und allgemeinen Rechenzentrumsnetzen
  • Kombinierbar mit NetQ für Netzwerkbetrieb und Telemetrie

Wichtige Spezifikationen

TypEthernet switch family
PortgeschwindigkeitUp to 800 Gb/s
EinsatzAI and cloud data-centre fabrics

Was Workstation leistet: Wir dimensionieren Ports und Optiken, konfigurieren die Switches und integrieren sie in Ihr bestehendes Netzwerk.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Netzwerk

NVIDIA Quantum InfiniBand-Switches

Switching mit geringer Latenz für HPC und KI

Quantum InfiniBand-Switches bilden die latenzarmen Fabrics, auf die HPC- und KI-Cluster angewiesen sind.

Für wen es passt: Forschungsrechen- und KI-Teams mit eng gekoppelten Workloads

Vorteile

  • Sehr geringe Latenz zwischen Knoten
  • Bewährt in HPC- und KI-Clustern
  • Zentrale Verwaltung mit UFM

Wichtige Spezifikationen

TypInfiniBand switch family
EinsatzHPC and AI data centres

Was Workstation leistet: Wir planen die Topologie, liefern Kabel und Optiken und installieren und prüfen das Fabric.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Netzwerk

NVIDIA ConnectX NICs und SuperNICs

Netzwerkadapter für Ethernet und InfiniBand

ConnectX-Adapter verbinden Server mit dem Fabric. SuperNICs wie ConnectX-8 sind auf GPU-zu-GPU-Verkehr in KI-Clustern abgestimmt.

Für wen es passt: Alle, die GPU-Server oder Storage an ein Hochgeschwindigkeitsnetz anbinden

Vorteile

  • Eine Produktfamilie für Ethernet und InfiniBand
  • SuperNICs geben jeder GPU einen eigenen Hochgeschwindigkeitspfad
  • Hardware-Offloads entlasten die CPU

Wichtige Spezifikationen

TypNetwork adapter and SuperNIC family
FabricsEthernet and InfiniBand
Höchstgeschwindigkeit800 Gb/s per GPU (ConnectX-8 SuperNIC)

Was Workstation leistet: Wir stimmen Adapter, Kabel und Transceiver auf Ihre Switches und Server ab und installieren Firmware und Treiber.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Netzwerk

NVIDIA BlueField DPUs

Data Processing Units für Netzwerk, Storage und Sicherheit

BlueField DPUs nehmen der Server-CPU Netzwerk-, Storage- und Sicherheitsaufgaben ab und isolieren sie in dedizierter Hardware.

Für wen es passt: Cloud-Anbieter, KI-Fabriken und sicherheitsbewusste Organisationen

Vorteile

  • Gibt CPU-Kerne für Anwendungen frei
  • Isoliert Infrastrukturdienste von Mandanten-Workloads
  • Programmierbar mit NVIDIA DOCA

Wichtige Spezifikationen

TypData processing unit (DPU) family
GenerationenBlueField-3, BlueField-4
SoftwareNVIDIA DOCA

Was Workstation leistet: Wir liefern und verbauen BlueField-Karten und unterstützen Sie beim Bereitstellen der benötigten DOCA-Dienste.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Software

NVIDIA AI Enterprise

Unterstützte Software für produktive KI

NVIDIAs Suite aus KI-Frameworks, NIM-Microservices und Tools, mit Enterprise-Support und langlebigen Release-Branches.

Für wen es passt: Jede Organisation, die KI produktiv auf NVIDIA-GPUs betreibt

Vorteile

  • Enterprise-Support und stabile Release-Branches
  • NIM-Microservices machen Modelle schneller einsatzbereit
  • Läuft auf NVIDIA-Certified Systems vor Ort oder in der Cloud

Wichtige Spezifikationen

LizenzierungPer GPU subscription
EnthältAI frameworks, NIM microservices, pretrained models
SupportNVIDIA Enterprise Business Standard Support
Testversion90-day evaluation

Was Workstation leistet: Wir erstellen Angebote, aktivieren Lizenzen, installieren die Software mit Ihrer Hardware und erinnern Sie rechtzeitig vor der Verlängerung.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Software

NVIDIA Mission Control

Betriebssoftware für KI-Fabriken

Mission Control automatisiert den täglichen Betrieb großer GPU-Cluster – von der Workload-Orchestrierung bis zu Health-Checks und Wiederherstellung.

Für wen es passt: Betreiber von DGX SuperPOD und anderen großen KI-Clustern

Vorteile

  • Automatisiert routinemäßige Cluster-Aufgaben
  • Erhöht die Ausfallsicherheit durch Erkennen und Beheben von Fehlern
  • Eine Gesamtsicht auf Workloads und Infrastruktur

Wichtige Spezifikationen

TypAI-factory operations and cluster management software
FunktionenWorkload orchestration, infrastructure resiliency, cluster automation
LizenzbasisConfirmed on quote

Was Workstation leistet: Wir stellen Mission Control mit Ihrem Cluster bereit und schulen Ihre Betreiber im Umgang damit.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Software

NVIDIA Run:ai

GPU-Orchestrierung und -Scheduling

Run:ai bündelt GPUs teamübergreifend und weist sie bei Bedarf zu, damit teure Hardware ausgelastet bleibt statt brachzuliegen.

Für wen es passt: Organisationen, die GPUs zwischen vielen Data Scientists oder Projekten teilen

Vorteile

  • Höhere GPU-Auslastung durch dynamisches Pooling
  • Kontingente, Prioritäten und Zugriffskontrolle für eine faire Verteilung
  • Funktioniert in On-Premises-, Hybrid- und Cloud-Umgebungen

Wichtige Spezifikationen

TypGPU orchestration and scheduling platform
Läuft aufKubernetes
BereitstellungOn premises, hybrid or cloud
LizenzbasisConfirmed on quote

Was Workstation leistet: Wir installieren Run:ai auf Ihrem Kubernetes-Cluster, richten mit Ihren Teams Kontingente ein und betreuen die Lösung.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Software

NVIDIA Base Command Manager

Cluster-Provisionierung und -Monitoring

Base Command Manager provisioniert, überwacht und verwaltet GPU-Cluster – von einer Handvoll Knoten aufwärts.

Für wen es passt: IT-Teams, die GPU-Cluster jeder Größe betreiben

Vorteile

  • Automatisiert die Provisionierung auf Arm und x86
  • Health-Dashboards und Echtzeit-Monitoring
  • Weboberfläche, Kommandozeile und API

Wichtige Spezifikationen

TypCluster management software
Kostenlose LizenzUp to 8 accelerators per system
Aktuelles ReleaseBase Command Manager 11
SchnittstellenBaseView web UI, CLI, API

Was Workstation leistet: Wir installieren und konfigurieren Base Command Manager als Teil der Cluster, die wir aufbauen.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Software

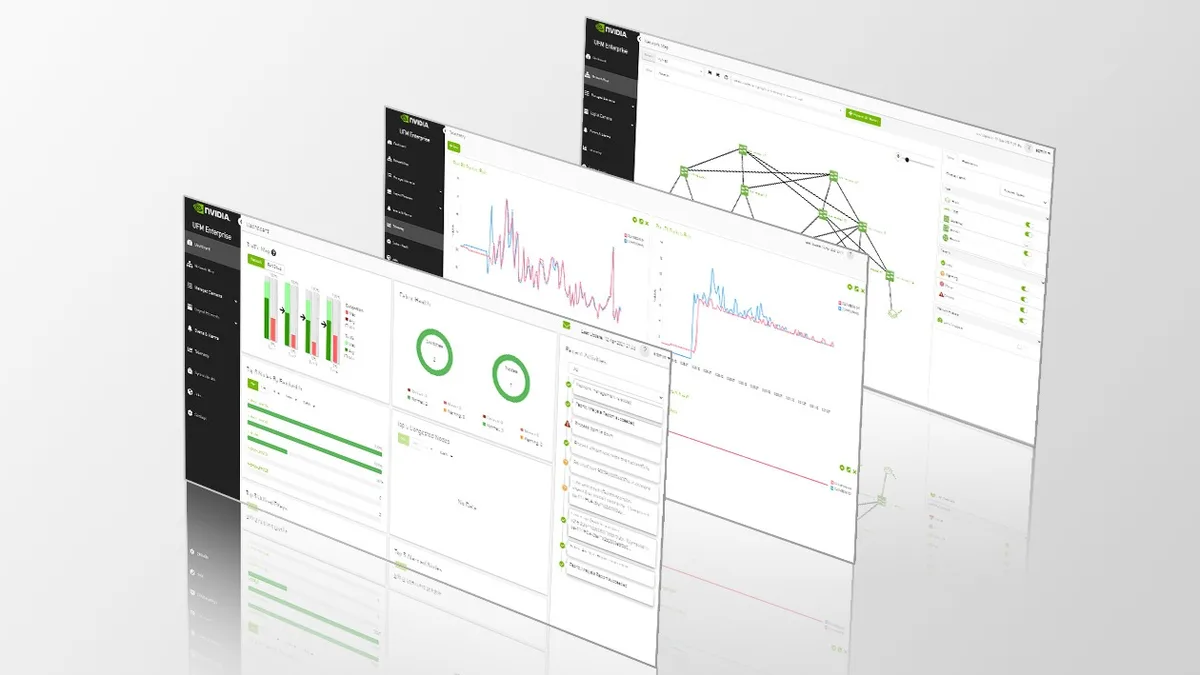
NVIDIA UFM

Unified Fabric Manager für InfiniBand

UFM überwacht und verwaltet InfiniBand-Fabrics und hilft bei der Fehlersuche.

Für wen es passt: Teams, die InfiniBand-Cluster betreiben

Vorteile

  • Fabric-Telemetrie in Echtzeit
  • Schnellere Fehlersuche
  • Zentrale Verwaltung von Switches und Verbindungen

Wichtige Spezifikationen

TypInfiniBand fabric management and telemetry software
Funktioniert mitNVIDIA Quantum InfiniBand switches

Was Workstation leistet: Wir stellen UFM mit Ihrem Fabric bereit und richten Alarme ein, die zu Ihren Betriebsabläufen passen.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Software

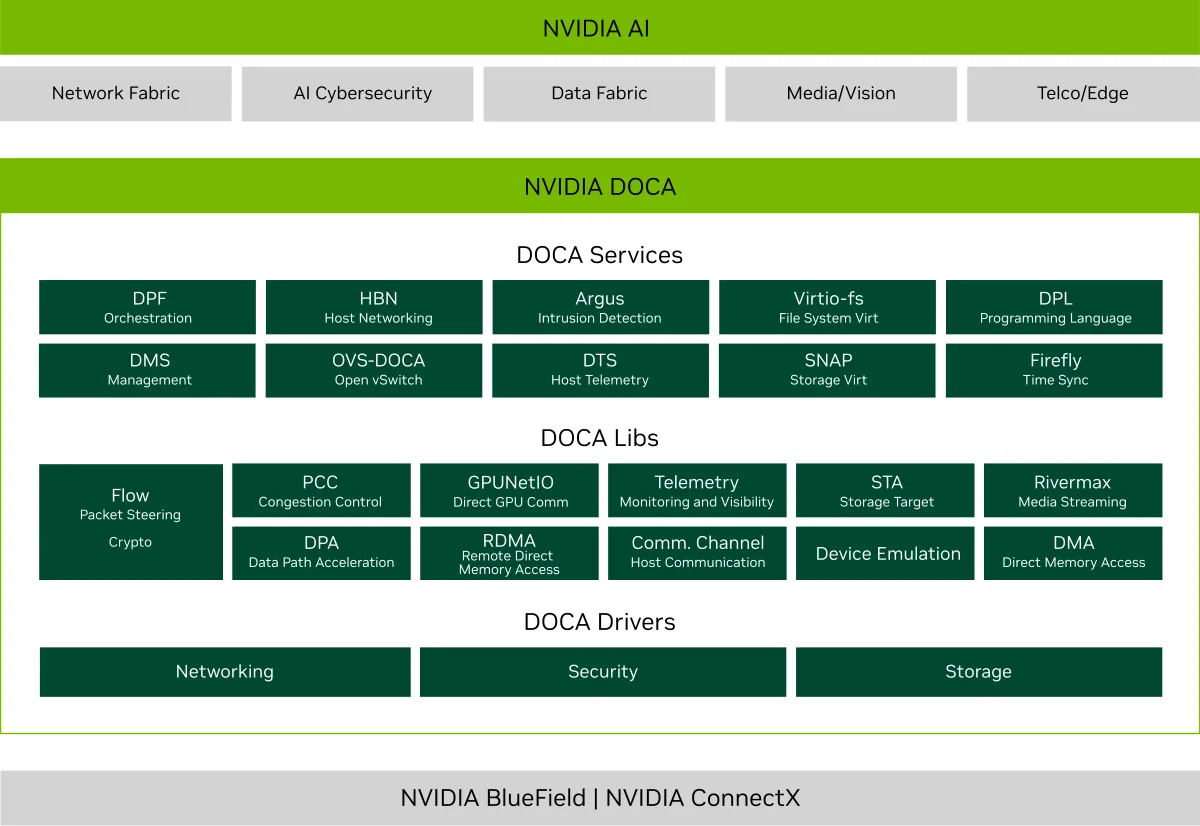
NVIDIA DOCA

Software-Framework für BlueField und SuperNICs

DOCA ist das SDK und die Laufzeitumgebung für Dienste, die auf BlueField DPUs und SuperNICs laufen.

Für wen es passt: Entwickler und Plattformteams, die auf BlueField aufbauen

Vorteile

  • Ein Framework über alle DPU- und SuperNIC-Generationen
  • Beschleunigt die Entwicklung ausgelagerter Dienste
  • Eine Laufzeitumgebung für den produktiven Einsatz dieser Dienste

Wichtige Spezifikationen

TypSDK and runtime framework
Läuft aufNVIDIA BlueField DPUs and SuperNICs

Was Workstation leistet: Wir helfen beim Einrichten von DOCA-Umgebungen und stellen Dienste auf den von uns gelieferten BlueField-Karten bereit.

Preis auf AnfrageAngebot anfordern ↗
Auf NVIDIA.com ansehen ↗

Die Spezifikationen sind aus den veröffentlichten Angaben von NVIDIA zusammengefasst und können sich zwischen Revisionen ändern. Mit „sparse“ gekennzeichnete Werte setzen Sparsity voraus. Die genaue Konfiguration, den Preis und die Lieferzeit bestätigen wir in jedem Angebot.

Was Workstation bei jeder Bestellung leistet

Dieselben fünf Schritte, ob Sie eine GPU kaufen oder eine ganze Rackreihe

Dimensionierung

Wir gehen von Ihren Modellen, Daten, Nutzern und Ihrem Standort aus und dimensionieren dann Rechenleistung, Speicher, Netzwerk, Stromversorgung und Kühlung.

Beschaffung

Wir beschaffen über NVIDIA und seine Serverpartner, bestätigen Lieferzeiten und halten Sie bis zur Auslieferung auf dem Laufenden.

Aufbau und Burn-in

Die Systeme werden in unserer britischen Werkstatt montiert, mit Images bespielt und unter Volllast getestet, bevor sie versendet werden.

Installation

Unsere Techniker liefern, bauen ins Rack ein, verkabeln und nehmen vor Ort in Betrieb und übergeben anschließend mit Dokumentation.

Support

Dasselbe Team kümmert sich um Softwareprobleme, Upgrades, Lizenzverlängerungen und Garantiefälle.

Alle NVIDIA-Kategorien

Trade-Mitgliedschaft

Fachhandelsmitglieder erhalten bei jeder Bestellung kostenlosen technischen Support und unbegrenzte Ingenieurszeit — Hilfe bei Konfiguration, Treibern, Software und Fehlerbehebung, solange Sie die Hardware besitzen.

Trade-Mitgliedschaft entdecken

NVIDIA Blackwell, vom Chip bis zum Rechenzentrum

NVIDIA Blackwell: The Journey From Die to Data Center. Wiedergabe vom offiziellen YouTube-Kanal von NVIDIA. Auf YouTube ansehenNVIDIA, Blackwell, DGX, Grace und RTX PRO sind Marken und/oder eingetragene Marken der NVIDIA Corporation. Sie werden zur Beschreibung der von uns gelieferten Produkte gezeigt; eine Empfehlung durch NVIDIA ist damit nicht verbunden.

Die NVIDIA RTX PRO 6000 Blackwell Server Edition ansehen

NVIDIA RTX PRO: KI und Visual Computing auf der RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. Wiedergabe vom offiziellen YouTube-Kanal von NVIDIA. Auf YouTube ansehenMehr über die RTX PRO 6000 Server Edition →NVIDIA, RTX PRO und Blackwell sind Marken und/oder eingetragene Marken der NVIDIA Corporation. Sie werden zur Beschreibung der von uns gelieferten Produkte gezeigt; eine Empfehlung durch NVIDIA ist damit nicht verbunden.

Häufig gestellte Fragen

Warum gibt es alle Preise nur auf Anfrage?

Preise und Zuteilungen im Accelerated Computing ändern sich schnell, und die meisten Bestellungen hängen von der genauen Konfiguration, dem Standort und der Software ab. Mit einem Angebot können wir aktuellen Preis, Verfügbarkeit und Lieferzeit für genau das bestätigen, was Sie benötigen.

Können Sie eine einzelne GPU statt eines kompletten Systems liefern?

Ja. Wir liefern einzelne Rechenzentrums-GPUs, prüfen aber immer, ob Ihr Server für deren Stromversorgung und Kühlung zertifiziert ist, und können sie für Sie einbauen und testen.

Installieren Sie Rack-Scale- und flüssigkeitsgekühlte Systeme?

Ja. Bei Systemen wie GB300 NVL72 arbeiten wir lange vor der Lieferung mit Ihrem Facility-Team an Stromversorgung, Kühlung und Bodenbelastung und installieren und nehmen sie dann vor Ort in Betrieb.

Mit welcher NVIDIA-Plattform sollten wir beginnen?

Das hängt von Ihren Modellen, Nutzern und Ihrem Standort ab. Viele Teams beginnen mit RTX PRO Server oder L40S für gemischte KI- und Grafik-Workloads und wechseln für Training im großen Maßstab zu HGX oder DGX. Sprechen Sie mit einem Techniker, und wir empfehlen Ihnen einen Ausgangspunkt.

Planen Sie Ihr NVIDIA Accelerated-Computing-Projekt

Sagen Sie uns, was Sie betreiben müssen und wo es stehen soll. Ein Techniker meldet sich mit einer empfohlenen Konfiguration und einem Angebot.

Mit einem Engineer sprechen