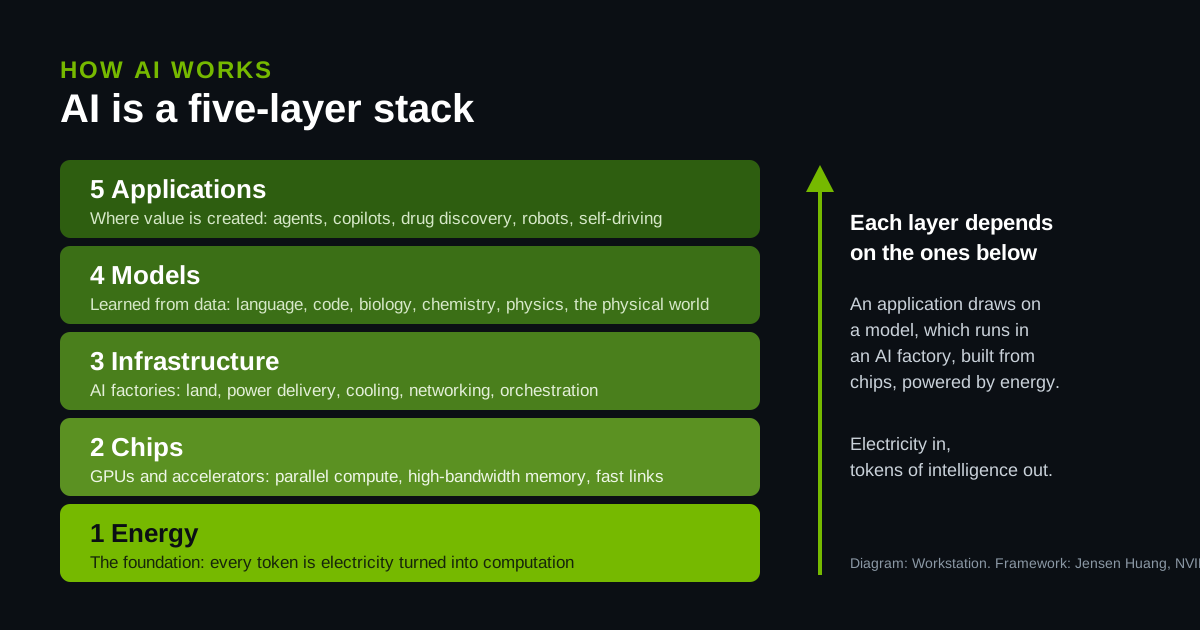
Le terme « IA » désigne aussi bien un chatbot qu'un robot ou un contrat de centrale électrique, ce qui le rend difficile à expliquer. Jensen Huang, fondateur de NVIDIA, en a donné l'une des images les plus claires : l'IA est un gâteau à cinq étages, composé de l'énergie, des puces, de l'infrastructure, des modèles et des applications. Il l'a présentée au Forum économique mondial de Davos en janvier 2026, puis détaillée en mars dans un article du blog NVIDIA, « AI Is a 5-Layer Cake ». Cette note explique ce qu'est l'IA, comment elle fonctionne de la centrale électrique jusqu'à l'application sur votre écran, et pourquoi chaque étage compte pour quiconque achète ou construit de l'IA. Le cadre et les idées que nous lui attribuons sont les siens ; les explications et les conseils pratiques sont les nôtres.
Sommaire
- Ce qu'est l'IA : de la recherche de réponses à leur génération
- Étage 1 : l'énergie
- Étage 2 : les puces
- Étage 3 : l'infrastructure, l'usine d'IA
- Étage 4 : les modèles
- Étage 5 : les applications
- Pourquoi les étages comptent ensemble
- Ce que cela signifie pour l'emploi
- Ce que cela signifie pour votre entreprise
1. Ce qu'est l'IA : de la recherche de réponses à leur génération
Pendant la plus grande partie de l'histoire de l'informatique, les logiciels étaient écrits à l'avance. Une personne définissait les étapes, l'ordinateur les suivait, et les données étaient rangées dans des tables bien ordonnées que l'on interrogeait par des requêtes précises. Si vous demandiez un fichier, l'ordinateur allait chercher le fichier qui existait déjà.
L'IA fonctionne autrement. Un modèle apprend des motifs à partir d'énormes quantités d'exemples : texte, code, images, sons et, de plus en plus, protéines, molécules et relevés de capteurs du monde physique. Lorsque vous l'interrogez, il ne va pas chercher une réponse stockée. Il en génère une nouvelle, morceau par morceau, à partir de ce qu'il a appris et du contexte que vous lui avez fourni. Ces morceaux s'appellent des tokens : des fragments de mots, des pixels, des sons ou tout autre type de données.
C'est le point de départ de Huang. Comme chaque réponse est créée à neuf, au moment où l'on en a besoin, l'IA a besoin de puissance de calcul et d'électricité au moment où elle est utilisée, et pas seulement d'un endroit où conserver des fichiers. C'est pourquoi il ne décrit pas l'IA comme une application ou un modèle unique, mais comme une infrastructure essentielle, à l'image de l'électricité et d'Internet, construite en cinq étages.
| Informatique traditionnelle | IA | |
|---|---|---|
| Ce que fait l'ordinateur | Suit les étapes écrites par une personne | Utilise les motifs appris à partir des données |
| Données qu'il comprend | Tables et champs structurés | Texte, images, son, vidéo, code, données scientifiques |
| Comment il répond | Récupère quelque chose de déjà stocké | Génère une nouvelle réponse adaptée à votre contexte |
| Où il s'exécute | Centres de données conçus pour stocker et servir des fichiers | Usines d'IA conçues pour produire des tokens |
2. Étage 1 : l'énergie
Tout commence par l'électricité. Chaque token produit par une IA résulte de la transformation d'électricité en calcul et de l'évacuation de la chaleur. Huang qualifie l'énergie de premier principe de l'infrastructure d'IA et de contrainte déterminante : c'est elle qui fixe le plafond de la quantité d'intelligence pouvant être produite.
Pourquoi c'est important : au Royaume-Uni, la partie la plus difficile d'un nouveau centre de données d'IA n'est souvent pas les GPU, mais le raccordement au réseau électrique, qui peut prendre des années. Pour des déploiements plus modestes, la question est locale : votre bâtiment ou votre salle serveurs peut-il alimenter et refroidir une baie qui consomme bien plus qu'une baie informatique ordinaire ? Le coût de l'énergie se répercute aussi directement sur le prix de chaque réponse fournie par une IA.
3. Étage 2 : les puces
Au-dessus de l'énergie se trouvent les puces qui transforment l'électricité en calcul. L'IA a besoin d'un type particulier de puces : des processeurs qui effectuent des milliers de calculs à la fois (parallélisme), une mémoire assez rapide pour les alimenter (mémoire à haut débit) et des liaisons assez rapides pour que de nombreuses puces fonctionnent comme une seule. Les GPU répondent à ces besoins, c'est pourquoi ils sont devenus le moteur de l'IA moderne.
Pourquoi c'est important : les progrès à cet étage déterminent la vitesse à laquelle l'IA peut se développer et le coût de chaque réponse. Chaque génération de GPU produit davantage de tokens pour la même puissance. Choisir du matériel, c'est trouver un équilibre entre la mémoire (qui détermine la taille du modèle que vous pouvez exécuter), la vitesse, la consommation électrique et la disponibilité. Un système de bureau de 128 Go comme DGX Spark, un serveur RTX PRO 6000 de 96 Go et une baie des derniers GPU pour centres de données conviennent chacun à des usages très différents.
4. Étage 3 : l'infrastructure, l'usine d'IA
Les puces seules ne font pas l'IA. Il leur faut du terrain, des bâtiments, une alimentation électrique, du refroidissement, du réseau et le logiciel qui fait fonctionner des dizaines de milliers de processeurs comme une seule machine. Huang appelle ces installations des usines d'IA : elles ne sont pas construites pour stocker de l'information, mais pour fabriquer de l'intelligence.
Pourquoi c'est important : c'est ici que la plupart des projets réussissent ou échouent en pratique. Les questions sont physiques et opérationnelles : puissance par baie et refroidissement liquide, réseau entre les serveurs, stockage assez rapide pour les données d'entraînement, ordonnancement, supervision, sécurité, et qui exploite l'ensemble. Vous pouvez posséder cet étage, le louer en leasing ou le louer auprès d'un cloud. La bonne réponse dépend du taux d'utilisation du matériel et de l'endroit où vos données doivent rester.
5. Étage 4 : les modèles
Au-dessus de l'infrastructure se trouvent les modèles, la partie que la plupart des gens considèrent comme « l'IA ». Huang souligne que les modèles de langage ne sont qu'une catégorie parmi d'autres. Les modèles comprennent désormais la biologie, la chimie, la physique, la finance, la médecine et le monde physique, et certains des travaux les plus importants portent sur la conception de protéines, la chimie, la simulation, la robotique et les systèmes de conduite autonome.
Un modèle passe par deux étapes. L'entraînement est la phase où il apprend à partir des données ; elle exige le plus de calcul et n'a lieu qu'occasionnellement. L'inférence est la phase où il est utilisé pour répondre à des questions ou effectuer un travail ; elle a lieu à chaque utilisation et, à grande échelle, consomme au total davantage de calcul. Huang évoque aussi les modèles ouverts, que l'on peut télécharger et exécuter gratuitement : lorsqu'un modèle ouvert atteint la frontière de l'état de l'art, comme l'a fait DeepSeek-R1, il fait croître la demande à tous les étages situés en dessous.
Pourquoi c'est important : le modèle que vous choisissez détermine vos coûts, votre matériel et vos risques liés aux données. Un grand modèle de pointe accessible par API permet de démarrer rapidement. Un modèle ouvert exécuté sur votre propre matériel garde les données en interne et peut coûter moins cher à fort volume. La plupart des organisations finissent par utiliser les deux.
6. Étage 5 : les applications
Au sommet se trouvent les applications, là où la valeur économique est créée : plateformes de découverte de médicaments, robots industriels, copilotes juridiques, agents de service client, assistants de programmation, voitures autonomes. Selon Huang, une voiture autonome est une application d'IA incarnée dans une machine, et un robot humanoïde est une application d'IA incarnée dans un corps : même pile, résultats différents.
Le grand changement, dit-il, s'est produit au cours de l'année écoulée : les modèles sont devenus suffisamment bons pour être utiles à grande échelle. Le raisonnement s'est amélioré, les erreurs et les « hallucinations » ont diminué, et les réponses se sont mieux appuyées sur des sources réelles. L'IA est passée de la réponse aux questions à l'exécution de tâches, sous la forme d'agents qui planifient des étapes et utilisent des outils.
Pourquoi c'est important : c'est le seul étage que voient vos clients, et celui qui doit financer tout ce qui se trouve en dessous. Partez d'un problème métier qui mérite d'être résolu, puis descendez dans la pile jusqu'à ce dont il a besoin.
7. Pourquoi les étages comptent ensemble
L'intérêt de l'image du gâteau, c'est qu'aucun étage n'existe isolément. Chaque application réussie sollicite tous les étages situés en dessous, « jusqu'à la centrale électrique qui la maintient en vie », comme le dit Huang. De meilleures puces rendent les réponses moins chères ; des réponses moins chères rendent davantage d'applications rentables ; davantage d'applications exigent davantage d'infrastructure et d'énergie. Chaque étage renforce les autres.
C'est pourquoi Huang parle du plus grand chantier d'infrastructure de l'histoire de l'humanité, et pourquoi il estime que nous n'en sommes qu'au début : quelques centaines de milliards de dollars investis, et des milliers de milliards de dollars d'infrastructure encore à construire. C'est aussi pourquoi l'IA touche tant de secteurs à la fois, de la production d'électricité et de la construction jusqu'au logiciel et à la santé.
8. Ce que cela signifie pour l'emploi
Huang fait deux remarques sur le travail. D'abord, le chantier lui-même nécessite un très grand nombre de personnes qualifiées : électriciens, plombiers, tuyauteurs, ouvriers de la charpente métallique, techniciens réseau, installateurs et opérateurs. Il n'est pas nécessaire d'avoir un doctorat en informatique pour y participer.
Ensuite, l'IA prend en charge des tâches plutôt que des métiers entiers. Son exemple est la radiologie : l'IA aide désormais à lire les clichés, et pourtant la demande de radiologues ne cesse de croître, car la raison d'être d'un radiologue est de soigner des patients, pas de lire des clichés. Quand l'IA se charge du travail routinier, les hôpitaux prennent en charge davantage de patients et embauchent davantage de personnel. Selon ses termes, la productivité crée de la capacité, et la capacité crée de la croissance.
9. Ce que cela signifie pour votre entreprise
Vous n'avez pas besoin de posséder les cinq étages. Mais vous devez savoir desquels vous dépendez, et faire un choix délibéré à chacun d'eux :
| Étage | La question à se poser | Comment Workstation vous aide |
|---|---|---|
| Applications | Quel problème métier mérite d'être résolu en premier, et comment allons-nous mesurer le résultat ? | Agents d'IA, conseil en IA, conception d'agents |
| Modèles | API de pointe, modèle ouvert, ou les deux ? Où les données doivent-elles rester ? | IA privée, mise en place MLOps |
| Infrastructure | Acheter, louer en leasing ou louer ? Qui l'exploite ? | Clusters GPU, leasing de GPU, centre de données d'IA |
| Puces | Quelle quantité de mémoire GPU et quelle vitesse la charge de travail exige-t-elle ? | Stations de travail IA, DGX Spark et serveurs RTX PRO dans notre boutique |
| Énergie | Notre site peut-il l'alimenter et la refroidir ? Combien coûtera chaque réponse à produire ? | Planification de l'alimentation et du refroidissement dans chaque projet de serveur et de cluster |
Parlez-nous de la place de votre organisation sur le gâteau, et de ce qu'il convient de construire ou d'acheter ensuite.
Sources
- Jensen Huang, « AI Is a 5-Layer Cake », blog NVIDIA, 10 mars 2026.
- Blog NVIDIA, « Largest Infrastructure Buildout in Human History »: Jensen Huang on AI's « Five-Layer Cake » at Davos, janvier 2026.
Jensen Huang a démissionné de ses fonctions de président-directeur général de NVIDIA le 12 novembre 2026 ; les propos cités ici ont été tenus lorsqu'il dirigeait l'entreprise. NVIDIA et DGX sont des marques commerciales et/ou des marques déposées de NVIDIA Corporation aux États-Unis et dans d'autres pays.


