Dieser Leitfaden richtet sich an die Ingenieure, die Systeme mit der RTX PRO 6000 Blackwell Server Edition spezifizieren, ins Rack einbauen und betreiben: Infrastrukturverantwortliche, MLOps- und Plattformteams sowie diejenigen, die das Strombudget freigeben. Er behandelt, was die Karte ist, wie Sie den GPU-Speicher für reale Modelle dimensionieren, MIG, PCIe-Topologie und Netzwerk, Stromversorgung und Kühlung in Großbritannien, den Software-Stack, die Validierung eines neuen Servers und einen Rollout-Plan. Die Spezifikationen stammen von NVIDIAs Produktseite und Datenblatt; das Rack-Scale-Design stammt aus dem von AMAX veröffentlichten RackScale-32-Material. Alles andere ist unsere eigene technische Erfahrung, und wir weisen darauf hin, wo eine Zahl eine Schätzung ist.

1. Die Karte in einer Tabelle
| Merkmal | RTX PRO 6000 Blackwell Server Edition |
|---|---|
| Architektur | NVIDIA Blackwell |
| CUDA-Kerne | 24.064 |
| Tensor Cores | 752, fünfte Generation, mit FP4, FP6, FP8, FP16, BF16 und TF32 sowie der Transformer Engine der zweiten Generation |
| RT Cores | 188, vierte Generation; 355 TFLOPS RT-Spitzenleistung |
| Tensor-Spitzendurchsatz (NVIDIA) | FP4 4 PFLOPS · FP8 2 PFLOPS · FP16/BF16 1 PFLOPS · TF32 234 TFLOPS |
| FP32 | 120 TFLOPS |
| Speicher | 96 GB GDDR7 mit ECC, 512 Bit, 1.597 GB/s |
| Partitionierung | MIG, bis zu 4 isolierte Instanzen |
| Medien | 4 × NVENC (9. Gen., ergänzt 4:2:2-Encoding für H.264 und HEVC), 4 × NVDEC (6. Gen.) |
| Display | 4 × DisplayPort 2.1 |
| Host-Schnittstelle | PCIe Gen 5 x16; kein NVLink |
| Leistungsaufnahme | Bis zu 600 W, konfigurierbar |
| Formfaktor | Luft: Dual-Slot, volle Höhe, volle Länge, passiv. Flüssigkeit: Single-Slot |
| Sicherheit | Secure Boot mit Hardware Root of Trust |
Zwei Zeilen dieser Tabelle bestimmen die meisten Designentscheidungen: 96 GB bei 1,6 TB/s, was Modellgröße, Parallelität und Decode-Geschwindigkeit festlegt, und 600 W über PCIe ohne NVLink, was Stromversorgung, Kühlung und die Aufteilung der Arbeit auf mehrere GPUs festlegt.
Eine Anmerkung zu den Tensor-Werten. NVIDIA veröffentlicht Spitzenwerte; der Vergleich von AMAX nennt 3,7 PFLOPS FP4 und 117 TFLOPS FP32, was eine andere Takt- oder Leistungsannahme widerspiegelt. Betrachten Sie alle diese Werte als Obergrenzen. Bei LLM-Inferenz mit kleinen Batch-Größen begrenzt in der Regel die Speicherbandbreite, nicht der Tensor-Durchsatz, die Tokens pro Sekunde.
2. Die Einordnung in NVIDIAs Produktpalette
- Im Vergleich zur L40S: 96 GB GDDR7 statt 48 GB GDDR6, 1.597 GB/s statt 864 GB/s, PCIe Gen 5 statt Gen 4, zusätzlich FP4 und MIG sowie 600 W statt 350 W. Nach unserer Erfahrung passt ein Modell, das wegen des Speichers zwei L40S-Karten brauchte, meist auf eine einzige RTX PRO 6000.
- Im Vergleich zu HGX B200/B300: HGX-Boards verbinden acht GPUs per NVLink und sind mit HBM3E bestückt. Sie sind das richtige Werkzeug für Training und für sehr große Modelle, die Tensor-Parallelität über acht GPUs benötigen. Die RTX PRO 6000 ist das richtige Werkzeug für Inferenz, Fine-Tuning kleiner und mittelgroßer Modelle, Grafik und Simulation in gewöhnlichen luftgekühlten Racks.
- Im Vergleich zu den Workstation Editions: Die Workstation Edition hat eigene Lüfter für einen Desktop-Tower, und die Max-Q Workstation Edition läuft mit 300 W. Die Server Edition ist passiv gekühlt; sie funktioniert daher nur in einem Server, der Luft hindurchdrückt, oder in ihrer flüssigkeitsgekühlten Variante.
3. GPU-Speicher für LLMs dimensionieren
In der Regel geht Ihnen zuerst der Speicher aus, nicht die Rechenleistung. Dimensionieren Sie ihn in drei Teilen: Gewichte, KV-Cache und Overhead.
3.1 Gewichte
Gewichte belegen parameters × bytes per parameter:
| Modellgröße | BF16 (2 Byte) | FP8 (1 Byte) | FP4 (etwa 0,5 Byte plus Skalierungsfaktoren) |
|---|---|---|---|
| 8B | 16 GB | 8 GB | etwa 5 GB |
| 32B | 64 GB | 32 GB | etwa 18 GB |
| 70B | 140 GB | 70 GB | etwa 38 GB |
| 120B | 240 GB | 120 GB | etwa 65 GB |
Die FP4-Werte enthalten einen Zuschlag für die Block-Skalierungsfaktoren, die 4-Bit-Formate speichern; der genaue Overhead hängt vom Format und vom Werkzeug ab, mit dem das Modell quantisiert wurde. Prüfen Sie die Genauigkeit immer mit Ihrem eigenen Evaluierungsdatensatz, bevor Sie ein Produktionsmodell auf FP8 oder FP4 umstellen.
3.2 KV-Cache
Jedes Token in jeder aktiven Konversation hält Keys und Values für jede Schicht vor. Pro Token:
KV bytes per token = 2 × layers × kv_heads × head_dim × bytes per elementFür ein Modell der Klasse Llama 3.3 70B (80 Schichten, 8 KV-Heads mit Grouped-Query Attention, Head-Dimension 128) mit BF16-Cache:
2 × 80 × 8 × 128 × 2 bytes = 327,680 bytes ≈ 320 KiB per token
× 32,768 tokens of context   ≈ 10 GiB per full-length conversation
FP8 KV cache                 ≈ 5 GiB per full-length conversation
3.3 Rechenbeispiele
Angenommen, der Inferenzserver darf 90 % jeder GPU nutzen (vLLMs Standard --gpu-memory-utilization) und einige GB pro GPU entfallen auf Aktivierungen und CUDA Graphs. Dies sind Schätzwerte für die Planung, keine Garantien:
| Konfiguration | Nutzbarer Speicher | Gewichte | Verbleibend für KV-Cache | Gleichzeitige volle 32k-Konversationen |
|---|---|---|---|---|
| 70B FP8 auf 1 GPU | ≈ 86 GB | ≈ 70 GB | ≈ 12 GB | etwa 1 (BF16-KV) oder 2 (FP8-KV) |
| 70B FP4 auf 1 GPU | ≈ 86 GB | ≈ 38 GB | ≈ 44 GB | etwa 4 (BF16-KV) oder 8 (FP8-KV) |
| 70B FP8 auf 2 GPUs, Tensor-Parallelität 2 | ≈ 173 GB | ≈ 70 GB | ≈ 95 GB | etwa 9 (BF16-KV) oder 18 (FP8-KV) |
| 70B FP8, vier Replikate auf einem 4U-Server mit acht GPUs | ≈ 691 GB | ≈ 280 GB | ≈ 380 GB | etwa 35 (BF16-KV) oder 70 (FP8-KV) |
Die meisten Konversationen sind deutlich kürzer als 32k Tokens, und Paged-KV-Caches halten nur das vor, was tatsächlich genutzt wird; die reale Parallelität ist daher meist um ein Mehrfaches höher. Die Methode bleibt dennoch wichtig: Dimensionieren Sie anhand Ihrer realen Kontextlängen und der Spitzenzahl gleichzeitiger Nutzer, nicht allein anhand der Parameterzahl des Modells.
3.4 Durchsatz, grob geschätzt
Bei kleinen Batch-Größen liest jedes erzeugte Token alle Gewichte einmal. Eine grobe Obergrenze für einen einzelnen Stream ist memory bandwidth ÷ weight bytes: 1.597 GB/s ÷ 70 GB ≈ 23 Tokens/s für ein 70B-FP8-Modell auf einer GPU, in FP4 etwa das Doppelte. Werden viele Nutzer gebündelt, steigt der Gesamtdurchsatz weit über den Wert für einen einzelnen Stream, weil die Gewichte pro Schritt nur einmal für den gesamten Batch gelesen werden. Messen Sie Ihre eigenen Prompts mit Ihrem Inferenzserver, bevor Sie sich auf eine GPU-Anzahl festlegen.
4. MIG: eine Karte, bis zu vier GPUs
Multi-Instance GPU teilt eine Karte in isolierte Instanzen auf, jede mit eigenem Speicher, Cache und eigener Rechenleistung sowie einem garantierten Anteil an der Karte. Bei der RTX PRO 6000 bedeutet das bis zu vier Instanzen mit jeweils rund 24 GB. Typische Einsatzzwecke:
- Mehrere kleine Modelle (Embeddings, Reranker, Chat-Modelle mit 7B–8B) auf einer Karte, jedes in seiner eigenen Instanz.
- Entwicklungs- und Testumgebungen für mehrere Teams, ohne dass ein Team ein anderes ausbremst.
- Kubernetes-Cluster, in denen jeder Pod einen festen GPU-Anteil erhalten soll.
Die verfügbaren Profile hängen von der Treiberversion ab; lassen Sie sie daher auf Ihrem Server auflisten, statt Namen von anderswo zu übernehmen:
# Enable MIG mode on GPU 0 (needs the GPU to be idle; may need a GPU reset)
sudo nvidia-smi -i 0 -mig 1

# List the GPU instance profiles this card and driver support
nvidia-smi mig -i 0 -lgip

# Create instances from a profile ID shown above, with their compute instances (-C)
sudo nvidia-smi mig -i 0 -cgi <profile-id>,<profile-id> -C

# Check what you created
nvidia-smi -L
Unter Kubernetes wendet der MIG-Manager des NVIDIA GPU Operator ein MIG-Layout anhand eines Node-Labels an, und das Device-Plugin meldet anschließend jede Instanz als planbare Ressource. Wählen Sie die Strategie single, wenn alle GPUs eines Nodes dasselbe Layout verwenden, und mixed, wenn sie sich unterscheiden.
MIG ist nicht kostenlos: Ein Modell, das den Speicher der ganzen Karte benötigt, kann nicht in einem Viertel davon laufen, und Sie können MIG und Jobs für die ganze Karte nicht gleichzeitig auf derselben GPU nutzen. Planen Sie, welche GPUs partitioniert werden und welche nicht.
5. Server und PCIe-Topologie
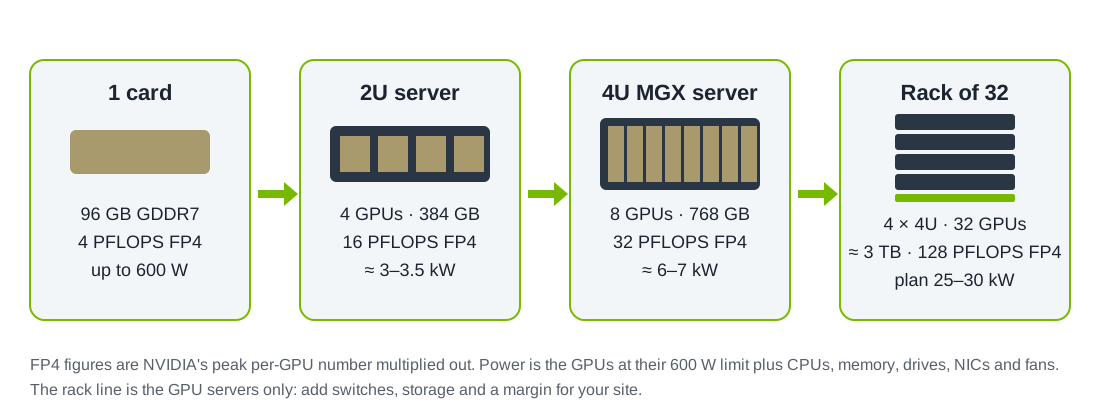
5.1 Die drei gängigen Konfigurationen
- 2U, vier GPUs. Meist ein oder zwei CPUs, wobei die GPUs direkt an CPU-Lanes oder an einem einzelnen PCIe-Switch hängen. Gut geeignet für ein Modell mit Tensor-Parallelität 2 oder 4 oder für mehrere Replikate.
- 4U, acht GPUs auf NVIDIA MGX. MGX ist NVIDIAs modulares Server-Referenzdesign. AMAX' AceleMax AXG-428AG ist ein Beispiel: zwei AMD-EPYC-9005-Prozessoren, acht Dual-Slot-GPUs, bis zu fünf PCIe-Gen-5-x16-Steckplätze für Netzwerkkarten und bis zu acht E1.S-NVMe-Laufwerke.
- Ein Rack mit 32 GPUs. Vier Server mit je acht GPUs plus die Switches dazwischen. AMAX veröffentlicht dies als RackScale 32: 32 GPUs vom Typ RTX PRO 6000 Server Edition, Dual-Socket-EPYC-9005 pro Server, insgesamt bis zu etwa 3 TB GDDR7 (32 × 96 GB) und 128 PFLOPS FP4, mit Spectrum-X Ethernet oder Quantum InfiniBand. Es ist darauf ausgelegt, Rack für Rack wiederholt zu werden.
5.2 Warum die Topologie ohne NVLink wichtig ist
Ohne NVLink tauschen GPUs Daten über PCIe aus. Zwei GPUs unter demselben PCIe-Switch kommunizieren direkt und schnell miteinander; zwei GPUs an unterschiedlichen CPU-Sockeln müssen die Verbindung zwischen den Sockeln überqueren, was langsamer ist. Prüfen Sie das Layout auf jedem Server:
nvidia-smi topo -mIn der Matrix bedeutet PIX oder PXB zwischen zwei GPUs, dass sie sich einen PCIe-Switch-Pfad teilen; NODE bedeutet, dass sie am selben CPU-Sockel, aber an unterschiedlichen Root-Ports hängen; SYS bedeutet, dass der Datenverkehr zwischen den Sockeln wechselt. Praktische Regeln:
- Platzieren Sie die GPUs einer Tensor-Parallel-Gruppe am selben Switch oder zumindest am selben Sockel. Tensor-Parallelität 2 oder 4 ist über PCIe meist der optimale Bereich.
- Für mehr GPUs pro Modell bevorzugen Sie Pipeline-Parallelität über Gruppen hinweg oder betreiben mehrere Replikate hinter einem Load Balancer. Replikate skalieren nahezu linear; breite Tensor-Parallelität über PCIe nicht.
- Setzen Sie jede Netzwerkkarte unter denselben PCIe-Switch wie die GPUs, die sie bedient, damit GPUDirect RDMA Daten zwischen GPU-Speicher und Netzwerk bewegen kann, ohne die CPU zu berühren. Einige neuere RTX-PRO-Serverdesigns haben dies bereits eingebaut, indem sie NVIDIA ConnectX-8 SuperNICs verwenden, die einen PCIe-Switch enthalten.
6. Netzwerk zwischen Servern
Ein einzelner Server benötigt nur gewöhnliche Rechenzentrumsvernetzung. Sobald sich eine Workload über mehrere Server erstreckt, etwa bei verteiltem Fine-Tuning, sehr großen über Nodes verteilten Modellen oder einer gemeinsamen Inferenzflotte mit schnellem Modell-Laden, spielt das Netzwerk eine Rolle.
- Bandbreite: Planen Sie auf Servern mit Multi-Node-Jobs einen 400-Gb/s-Port für jeweils eine oder zwei GPUs. Ein MGX-Server mit acht GPUs und vier oder fünf 400-Gb/s-Karten ist eine gängige Konfiguration.
- Fabric: NVIDIA Spectrum-X Ethernet (Spectrum-4-Switches mit ConnectX- oder BlueField-Netzwerkkarten, über RoCE) oder Quantum InfiniBand. Spectrum-X passt zu Teams, die bereits Ethernet betreiben; InfiniBand passt zu HPC-Teams, die damit vertraut sind.
- Getrennte Netzwerke: Halten Sie die GPU-Fabric getrennt vom Storage-Netzwerk und vom Management (BMC und Out-of-Band). Eine Vermischung ist die übliche Ursache für unvorhersehbare Job-Laufzeiten.
- Storage: lokales E1.S- oder U.2-NVMe für Modellgewichte und Scratch sowie ein paralleles oder NVMe-over-Fabrics-Dateisystem, wenn viele Server dieselben großen Modelle laden.
Für Inferenzflotten, bei denen jede Anfrage auf einem Server läuft, reichen meist 100 oder 200 Gb/s pro Server.
7. Stromversorgung und Kühlung in britischen Räumen
7.1 Strombudget
| System | GPU-Leistung bei 600 W | Gesamtsystem, geschätzt |
|---|---|---|
| 2U, 4 GPUs | 2,4 kW | etwa 3 bis 3,5 kW |
| 4U, 8 GPUs | 4,8 kW | etwa 6 bis 7 kW |
| Rack, 32 GPUs | 19,2 kW | etwa 25 bis 30 kW, ohne Netzwerk-Switches und Storage |
„Gesamtsystem“ umfasst zusätzlich CPUs, Arbeitsspeicher, Laufwerke, Netzwerkkarten, Lüfter und Netzteilverluste. Verwenden Sie für die genaue Konfiguration den Leistungsrechner des Herstellers, bevor Sie ein Angebot abschließen.
Auf britische Verhältnisse übertragen liefert eine einphasige 32-A-Zuleitung bei 230 V etwa 7,4 kW, genug für einen Server mit acht GPUs bei wenig Reserve. Ein Rack mit 32 GPUs benötigt Drehstrom: Eine dreiphasige 32-A-Zuleitung bei 400 V liefert etwa 22 kW; planen Sie daher zwei Zuleitungen pro Rack, mit A- und B-Seite für redundante Netzteile. Viele bestehende britische Technikräume sind für 5 bis 10 kW pro Rack ausgelegt; das 32-GPU-Design bedeutet daher meist einen Colocation-Standort oder eine Raumertüchtigung.
7.2 Leistungsgrenzen
Das Power-Limit der Karte ist konfigurierbar. Wird es gesenkt, verzichten Sie auf etwas Spitzenleistung und können dafür mehr GPUs mit derselben Stromversorgung und Kühlung betreiben. LLM-Decoding, das durch die Speicherbandbreite begrenzt ist, verliert oft weniger als die eingesparte Leistung, aber messen Sie es mit Ihrer Workload.
# Show the allowed range and the current limit
nvidia-smi -q -d POWER

# Set GPU 0 to 450 W (must be inside the allowed range; resets at reboot)
sudo nvidia-smi -i 0 -pl 450
Setzen Sie das Limit beim Booten mit einer systemd-Unit oder Ihrem Konfigurationsmanagement und vermerken Sie es im Asset-Register, damit das Support-Personal weiß, warum eine GPU unter ihrem Maximum läuft.
7.3 Kühlung
- Jedes Kilowatt wird zu etwa 3.412 BTU/h Wärme. Ein 30-kW-Rack übersteigt, was die meisten luftgekühlten Räume pro Rack ohne Einhausung oder Rücktür-Wärmetauscher abführen.
- Die luftgekühlte Karte ist passiv: Sie ist auf die Lüfter des Servers und auf kühle Ansaugluft angewiesen. Halten Sie die Ansaugtemperaturen innerhalb der Grenzwerte des Serverherstellers, verwenden Sie Blindabdeckungen und hausen Sie Warm- und Kaltgänge ein.
- Die flüssigkeitsgekühlte Single-Slot-Version eignet sich für dichte Konfigurationen an Standorten, die bereits über Flüssigkeitskühlung verfügen. Sie ist keine Nachrüstlösung für einen luftgekühlten Raum.
8. Der Software-Stack
- Betriebssystem: eine aktuelle LTS-Distribution, die vom Serverhersteller und von NVIDIA unterstützt wird, etwa Ubuntu Server 22.04 oder 24.04 LTS oder Red Hat Enterprise Linux 9.
- Treiber: ein NVIDIA-Rechenzentrumstreiberzweig mit Blackwell-Unterstützung. Blackwell-GPUs benötigen NVIDIAs offene GPU-Kernelmodule sowie CUDA 12.8 oder neuer.
- Container: das NVIDIA Container Toolkit, konfiguriert für Ihre Runtime.
- Orchestrierung: der NVIDIA GPU Operator unter Kubernetes oder Slurm für Batch-Arbeit.
- Serving: vLLM, SGLang, TensorRT-LLM oder NVIDIA-NIM-Microservices für LLMs; Omniverse und Ihr Renderer für Grafikarbeit; RAPIDS für Data Science.
- Monitoring: NVIDIA DCGM mit dcgm-exporter in Prometheus und Grafana.
# Container runtime (Docker shown)
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker

# Kubernetes: the GPU Operator from NVIDIA's Helm repository
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia && helm repo update
helm install --wait gpu-operator -n gpu-operator --create-namespace nvidia/gpu-operator
Ein OpenAI-kompatibler Endpunkt für ein 70B-Modell auf zwei GPUs, mit FP8-Gewichten und FP8-KV-Cache:
docker run --gpus '"device=0,1"' --ipc=host -p 8000:8000 \
  -v /models/hf:/root/.cache/huggingface \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2 \
  --quantization fp8 \
  --kv-cache-dtype fp8 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90
Pinnen Sie das Image in der Produktion auf eine getestete Version statt auf latest, und halten Sie die Modellgewichte auf lokalem NVMe, damit Neustarts schnell gehen.
9. Einen neuen Server validieren
Wir führen diese Prüfungen an jedem System durch, bevor es unsere Werkstatt verlässt, und erneut vor Ort:
# 1. Every GPU present, at the expected memory, power limit and PCIe link
nvidia-smi --query-gpu=index,name,memory.total,power.limit,pcie.link.gen.current,pcie.link.width.current --format=csv

# 2. ECC enabled and no uncorrectable errors
nvidia-smi -q -d ECC

# 3. Topology as designed (GPU and NIC pairs under the same switch)
nvidia-smi topo -m

# 4. NVIDIA's diagnostics, long run
dcgmi diag -r 3

# 5. GPU-to-GPU bandwidth inside the server (from NVIDIA's nccl-tests)
./build/all_reduce_perf -b 8 -e 4G -f 2 -g 8
Führen Sie anschließend einen mehrstündigen Burn-in unter Volllast durch, nach Möglichkeit mit der realen Inferenz- oder Rendering-Workload, und beobachten Sie dabei Temperaturen, Taktraten und Leistungsaufnahme. Eine Karte, die schon in der Werkstatt drosselt, drosselt in einem warmen Gang noch stärker.
Nützliche DCGM-Metriken für Alarme in der Produktion: DCGM_FI_DEV_GPU_TEMP, DCGM_FI_DEV_POWER_USAGE, DCGM_FI_DEV_FB_USED, DCGM_FI_DEV_GPU_UTIL sowie die XID-Fehlerereignisse im Systemprotokoll.
10. Ein Rollout-Plan
- Benchmark (1–2 Wochen). Führen Sie Ihre Modelle und Prompts auf einem RTX-PRO-6000-Server aus. Erfassen Sie Tokens pro Sekunde, Time to First Token und Speicherbedarf bei Ihren realen Kontextlängen und Ihrer realen Parallelität. Legen Sie die Präzision (BF16, FP8 oder FP4) anhand der Genauigkeit auf Ihrem eigenen Evaluierungsdatensatz fest.
- Dimensionierung und Standortprüfung (1 Woche). Leiten Sie aus dem Benchmark eine GPU-Anzahl mit Reserve ab und prüfen Sie dann Stromversorgung, Kühlung, Netzwerk und Rackplatz am Standort.
- Aufbau und Burn-in. Identische Konfiguration für jeden Server: Firmware, BIOS-Einstellungen, Treiber, Power-Limit und MIG-Layout unter Konfigurationsmanagement.
- Pilot. Ein Team, ein Dienst, mit Monitoring und einer Rufbereitschaftsregelung, bevor die Nutzer kommen.
- Skalierung. Fügen Sie Server derselben Konfiguration hinzu. Wechseln Sie erst dann zu einer Fabric zwischen den Servern, wenn sich eine Workload tatsächlich über mehrere Server erstreckt.
11. Fragen, die uns gestellt werden
Können wir RTX PRO 6000 und L40S in einem Server mischen? Technisch ja, aber setzen Sie sie nicht in dieselbe Tensor-Parallel-Gruppe. Halten Sie jedes Modell auf einem GPU-Typ und lassen Sie den Scheduler die Arbeit verteilen.
Ist FP4 gut genug? Für viele instruktionsoptimierte Modelle mit guten 4-Bit-Checkpoints ja; bei manchen Aufgaben wie Code, Mathematik und langen Argumentationsketten sinkt die Genauigkeit stärker. Testen Sie mit Ihren eigenen Daten. FP8 ist der sichere Standard.
Können wir darauf fine-tunen? Ja, für parametereffizientes Fine-Tuning (LoRA und QLoRA) kleiner und mittelgroßer Modelle und für vollständiges Fine-Tuning kleinerer Modelle. Für vollständiges Fine-Tuning von Modellen der 70B-Klasse oder für Pre-Training sind HGX-Systeme mit NVLink das bessere Werkzeug.
Werden besondere Lizenzen benötigt? Treiber und CUDA sind kostenlos. NVIDIA AI Enterprise (einschließlich NIM) und NVIDIAs Virtual-GPU-Software werden separat lizenziert; Open-Source-Stacks wie vLLM benötigen sie nicht.
Quellen
- NVIDIA: RTX PRO 6000 Blackwell Server Edition, Spezifikationen
- AMAX: RackScale 32 mit NVIDIA RTX PRO 6000 Blackwell Server Edition
- AMAX: AceleMax AXG-428AG
- AMAX: RTX PRO 6000 Blackwell Server Edition im Vergleich zur NVIDIA L40S
Zum Business Case und zu den Systemen, die wir liefern, siehe die Seite zur RTX PRO 6000 Blackwell Server Edition und unseren Blogbeitrag.
Marken. NVIDIA, das NVIDIA-Logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, ConnectX, TensorRT, NIM und DCGM sind Marken und/oder eingetragene Marken der NVIDIA Corporation in den USA und anderen Ländern. AMAX und AceleMax sind Marken der AMAX Engineering Corporation. AMD und EPYC sind Marken von Advanced Micro Devices, Inc. Llama ist eine Marke von Meta Platforms, Inc. Ubuntu ist eine Marke von Canonical Ltd. Red Hat ist eine Marke von Red Hat, Inc. Kubernetes ist eine Marke der Linux Foundation. Docker ist eine Marke von Docker, Inc. Alle anderen Marken gehören ihren jeweiligen Inhabern. Workstation ist ein unabhängiger Anbieter; eine Billigung durch diese Unternehmen ist damit nicht verbunden. Das Video stammt von NVIDIA.


