Was eine KI-Fabrik tatsächlich liefert: Ein Rack, 32 Blackwell Ultra GPUs und die Arbeit, die sie für Sie erledigt
Von Ihren Daten zu Antworten, Agenten und eigenen Modellen, verständlich erklärt
 Balinder Walia2. November 20268 min read
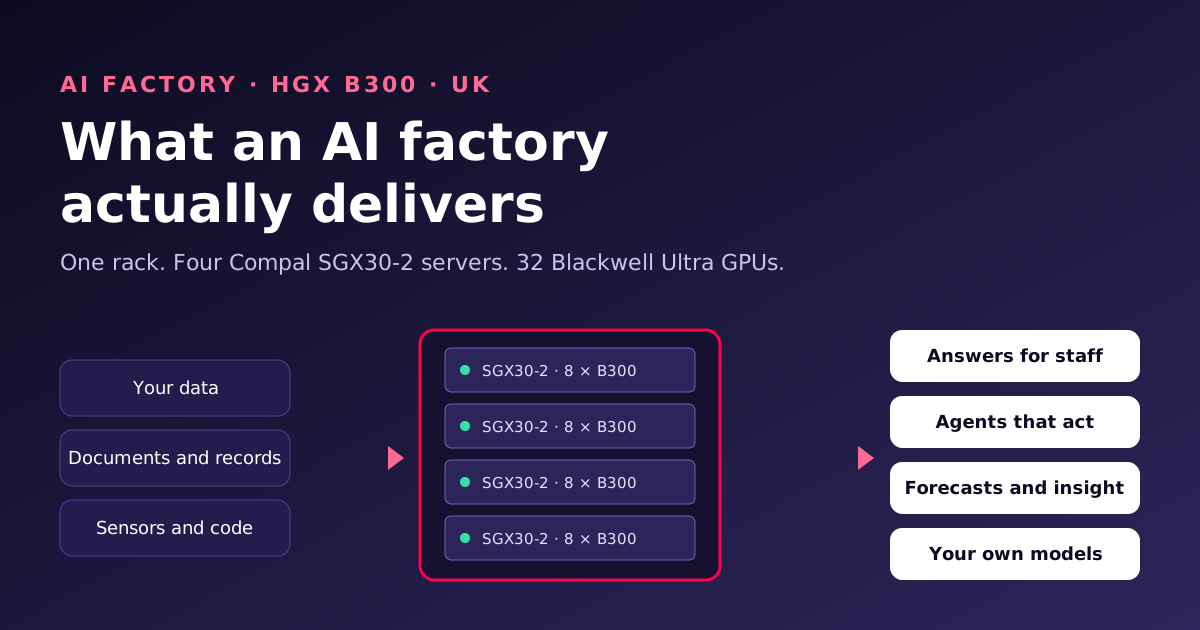
„KI-Fabrik“ wird gerade zu einem dieser Begriffe, die alle verwenden und nur wenige definieren. Dieser Beitrag erklärt in verständlichen geschäftlichen Begriffen, was eine KI-Fabrik tatsächlich liefert: was hineingeht, was herauskommt, wie die Arbeit jeden Tag durch sie hindurchfließt und was Sie brauchen, um eine zu besitzen und zu betreiben. Wir verwenden durchgehend eine reale Konfiguration, ein Rack mit vier Compal SGX30-2 Servern und 32 NVIDIA Blackwell Ultra GPUs, damit die Zahlen konkret sind. Engineers, die die Node-Architektur, das Netzwerkdesign und die Inbetriebnahmetests suchen, sollten den technischen Artikel lesen.

Vom Speichern von Informationen zu ihrer Produktion
Dreißig Jahre lang haben Rechenzentren vor allem Informationen gespeichert und bereitgestellt: Websites, Datenbanken, E-Mail, Dateien. Eine KI-Fabrik tut etwas anderes. Sie fertigt neue Informationen auf Abruf. Eine Mitarbeiterin stellt eine Frage zu einem Vertrag und erhält eine Antwort aus Ihrem eigenen Dokumentenarchiv. Ein Agent liest eine eingehende Schadensmeldung, prüft sie anhand der Richtlinien und entwirft eine Entscheidung. Ein Modell, das mit fünf Jahren Ihrer Wartungsaufzeichnungen trainiert wurde, sagt voraus, welche Maschine nächsten Monat ausfallen wird.
Die Ausgabeeinheit ist das Token, ein Textfragment, das ein Modell liest oder schreibt. Jede Antwort, jede Zusammenfassung und jede Aktion eines Agenten besteht aus Tokens. Die entscheidenden Fragen in einer KI-Fabrik sind daher dieselben wie in jeder Fabrik: Wie viel kann sie produzieren, wie gut ist das Ergebnis, was kostet jede Einheit, und wie zuverlässig läuft sie?
Was hineingeht, was herauskommt
| Geht hinein | Kommt heraus |
|---|---|
| Dokumente, Verträge, Richtlinien, Handbücher | Präzise Antworten mit Quellenverweisen, in Sekunden |
| Tickets, E-Mails, Chatprotokolle | Agenten, die priorisieren, Antworten entwerfen und Arbeit weiterleiten |
| Betriebs- und Sensordaten | Prognosen, Anomaliewarnungen und Wartungsvorhersagen |
| Ihr Code und Ihre Engineering-Unterlagen | Coding-Assistenten, die Ihre Systeme und Standards kennen |
| Feedback dazu, was funktioniert hat | Bessere Modelle im nächsten Monat: feinabgestimmt auf Ihre eigenen Ergebnisse |
Die rechte Spalte ist das, wofür Sie bezahlen. Das Rack ist lediglich die Maschine, die es produziert.
Die Produktionslinie, Stufe für Stufe

- Aufnehmen. Das Rohmaterial trifft ein: Dokumente, Datensätze, Tickets, Code. Es wird bereinigt, dedupliziert und, wo nötig, um personenbezogene Daten geschwärzt. Text wird in Embeddings umgewandelt, damit er nach Bedeutung statt nach Stichwort durchsucht werden kann.
- Trainieren oder feinabstimmen. Die meisten Organisationen trainieren ein Modell nicht von Grund auf. Sie nehmen ein leistungsfähiges offenes Modell und stimmen es mit ihren eigenen Daten fein ab, sodass es ihre Sprache spricht und ihre Produkte kennt. Mit 32 GPUs ist das eine Aufgabe von Stunden oder Tagen, nicht von Monaten.
- Bewerten und freigeben. Bevor ein neues Modell Mitarbeitende oder Kunden erreicht, wird es auf Genauigkeit, Sicherheit, Kosten und Geschwindigkeit getestet. Modelle, die bestehen, werden Schritt für Schritt von einem Test-Ring in die Produktion befördert, so wie gute Softwareteams Code veröffentlichen. Wir nutzen dafür unseren eigenen Ring Promoter, sodass jedes Release einen Audit-Trail hat und zurückgerollt werden kann.
- Bereitstellen. Hier entsteht der Wert: Chat-Assistenten, Dokumentensuche, Agenten und APIs, die den ganzen Tag Anfragen beantworten. Der Zugriff läuft über WSL Proxy, der Verschlüsselung, Anmeldung und Web Application Firewall übernimmt, und Schlüssel und Zugangsdaten liegen in WSL Vault statt im Code.
- Verbessern. Jede Interaktion verrät Ihnen etwas: welche Antworten geholfen haben, welche korrigiert wurden, wo Agenten nicht weiterkamen. Dieses Feedback wird zu den Trainings- und Testdaten für die nächste Runde. Dieser Kreislauf ist der Grund, warum eine KI-Fabrik mit der Zeit wertvoller wird, statt wie gewöhnliche IT an Wert zu verlieren.
Unter allen fünf Stufen verteilt ein Scheduler die GPUs auf Teams und Jobs, sodass Trainings nachts auf Kapazität laufen können, die tagsüber den Mitarbeitenden dient. Ungenutzte GPUs sind das Teuerste in einer KI-Fabrik, und gutes Scheduling ist der Weg, sie zu vermeiden.
Was im Rack steckt und was jedes Teil leistet
Unser Standardbaustein ist der Compal SGX30-2, ein NVIDIA-Certified Server für die HGX B300 Plattform. Vier davon ergeben ein Rack. Das enthält jeder Server, einfach erklärt.
| Komponente | Pro Server | Was sie für Sie leistet |
|---|---|---|
| NVIDIA HGX B300 NVL8 Baseboard | 8 Blackwell Ultra GPUs mit je 288 GB Speicher | Der Motor. Führt die Modelle aus und trainiert sie. Großer Speicher bedeutet, dass große Modelle und lange Dokumente ohne Kompromisse hineinpassen. |
| Intel Xeon 6 Prozessoren | 2 (6767P, 6776P oder 6768P) | Bereitet Daten auf, führt das Betriebssystem aus und versorgt die GPUs fortlaufend mit Arbeit. |
| DDR5-6400 ECC Arbeitsspeicher | 32 × 96 GB (3 TB) | Arbeitsfläche zum Laden von Daten und zum Auslagern von Modellspeicher, wenn die GPUs ausgelastet sind. |
| NVMe E1.S Laufwerke | 8 × 3,84 TB | Schneller lokaler Speicher für Datensätze, Modelldateien und Trainings-Checkpoints. |
| M.2 Boot-Laufwerke | 2 × 960 GB | Betriebssystem, gespiegelt, sodass ein Ausfall den Server nicht stoppt. |
| NVIDIA ConnectX-8 SuperNICs | 8 onboard, 8 × 800G Ports | Eine eigene 800-Gb/s-Leitung für jede GPU, sodass 32 GPUs in vier Servern gemeinsam an einem Job arbeiten können. |
| NVIDIA BlueField-3 B3240 | 1 | Verarbeitet Speicher- und Benutzer-Datenverkehr getrennt, mit integrierter Sicherheit und Isolation. |
| Netzteile | 12 × 3200 W Titanium, 6+6 redundant | Die Hälfte davon kann ausfallen oder eine Stromzuführung wegfallen, und der Server läuft weiter. |
| Garantie | 3 Jahre Return-to-Base | Reparaturen und Ersatz werden über uns abgewickelt. |
Über das gesamte Rack ergibt das 32 GPUs, etwa 8,4 TB GPU-Speicher, 12 TB Arbeitsspeicher und etwa 123 TB schnellen lokalen Speicher, alles verbunden durch ein Netzwerk-Fabric mit 800 Gb/s pro GPU.
Was diese Kapazität in der Praxis bedeutet
Wir achten darauf, keine Leistungszahlen zu versprechen, die wir nicht mit Ihrer Workload gemessen haben, denn der tatsächliche Durchsatz hängt vom Modell, von der Länge der Fragen und Antworten und davon ab, wie viele Personen es gleichzeitig nutzen. Einiges ergibt sich jedoch direkt aus dem Speicher und dem Design:
- Große offene Modelle passen bequem hinein. Ein einzelner Server hat 2,1 TB GPU-Speicher, sodass selbst Modelle mit mehreren hundert Milliarden Parametern von einem Server aus bereitgestellt werden können, mit Reserven für lange Unterhaltungen.
- Mehrere Dienste können parallel laufen. Ein Server kann Ihren Haupt-Assistenten hosten, während ein anderer Dokumentensuche und Embeddings ausführt und die übrigen zwei Agenten und nächtliches Fine-Tuning übernehmen.
- Trainingsjobs können das ganze Rack nutzen. Wenn ein Fine-Tuning-Lauf alle 32 GPUs benötigt, lässt das 800-Gb/s-Fabric vier Server wie einen arbeiten, und der Scheduler gibt die Kapazität danach wieder an die Bereitstellung zurück.
- Sie ist für Reasoning-Modelle gebaut. Blackwell Ultra verdoppelt im Vergleich zur ersten Blackwell-Generation die Geschwindigkeit der „Attention“-Berechnungen im Kern moderner Modelle, was vor allem dann zählt, wenn Modelle ein Problem durchdenken, bevor sie antworten.
Besitzen oder mieten
Cloud-GPUs eignen sich hervorragend für Experimente und kurze Lastspitzen. Die Wirtschaftlichkeit ändert sich, sobald KI Teil der täglichen Arbeit wird. Gemietete Kapazität wird stundenweise abgerechnet, ob sie ausgelastet ist oder nicht, und ihr Preis, ihre Verfügbarkeit und ihre Bedingungen liegen in den Händen eines anderen. Eigene Kapazität ist ein Fixkostenblock: Jede zusätzlich beantwortete Frage, jeder Agentenlauf und jedes trainierte Modell senkt die Kosten pro Einheit.
Neben den Kosten gibt es weitere Gründe. Mit einer KI-Fabrik auf Ihrer eigenen Infrastruktur verlassen Ihre Daten, Prompts und Ergebnisse niemals das Vereinigte Königreich oder Ihre Kontrolle, was Gespräche zur UK GDPR sowie mit Aufsichtsbehörden und Kunden erheblich vereinfacht. Außerdem erhalten Sie Kapazität dann, wenn Sie sie brauchen, ohne Quota-Anfragen und ohne darauf zu warten, dass in einer Cloud-Region etwas frei wird.
Sie ist nicht für jeden das Richtige. Wenn Sie KI nur gelegentlich nutzen oder große Kapazität nur für einige Wochen benötigen, ist Mieten in der Regel günstiger. Wir sagen Ihnen ehrlich, auf welcher Seite dieser Linie Sie stehen.
Was Sie für den Betrieb benötigen
- Strom: Jeder Server benötigt rund 14 kW, das Rack etwa 60 kW. Das schließt die meisten gewöhnlichen Serverräume in Büros aus, doch viele Colocation-Rechenzentren im Vereinigten Königreich können dies bereitstellen.
- Kühlung: Der SGX30-2 ist luftgekühlt, es ist also keine Flüssigkühlungsanlage erforderlich, aber der Rechenzentrumsraum muss Racks mit hoher Leistungsdichte und Warmgang-Einhausung bewältigen können.
- Platz: 40 HE Rackplatz für die vier Server, zuzüglich Netzwerk-Switches und Speicher.
- Zeit: NVIDIA Rechenzentrums-GPUs werden von NVIDIA und den Serverherstellern zugeteilt, und die Lieferzeiten werden in Monaten gemessen. Standortvorbereitung und Design erfolgen während der Wartezeit, sodass die Fabrik kurz nach der Lieferung in Betrieb gehen kann.
- Formalitäten: Fortschrittliche GPUs unterliegen britischen und US-amerikanischen Exportkontrollen, daher bestätigen wir Endnutzer, Verwendungszweck und Installationsort, bevor wir die Lieferung zusagen können.
Wer sie betreibt, sobald sie läuft
Eine Fabrik, die nicht gut betrieben wird, verliert nach und nach Leistung durch Ausfälle, Drift und Sicherheitslücken. Wir können Ihre Fabrik so umfassend oder so punktuell betreiben, wie Sie möchten. Unser Service SysOps247 überwacht rund um die Uhr GPU-Zustand, Temperaturen, Fehler und Kapazität, spielt Firmware- und Sicherheitsupdates in geplanten Wartungsfenstern ein und kümmert sich um Störungen und Garantierücksendungen. Ihre Teams konzentrieren sich auf die Arbeit, die die Fabrik produziert.
Ein sinnvoller Einstieg
- Halten Sie die Arbeit schriftlich fest. Welche Fragen, Entscheidungen und Dokumente würden Sie zuerst an KI übergeben, und wie viele Personen würden sie nutzen?
- Prüfen Sie den Standort. Verfügen Sie über rund 60 kW Rackfläche oder können Sie diese mieten? Wir können den Standort begutachten oder eine Auswahl an Colocation-Optionen zusammenstellen.
- Beginnen Sie mit einem Rack oder sogar einem Server. Alles ist nach einem Referenzdesign aufgebaut, sodass weitere Server und Racks später ohne Neuplanung hinzukommen.
- Planen Sie die ersten drei Dienste. In der Regel ein Mitarbeiter-Assistent für Ihre Dokumente, ein Agent für einen klar definierten Prozess und ein feinabgestimmtes Modell. Weisen Sie dort den Nutzen nach und wachsen Sie dann.
Wie es weitergeht
- Für die Node-Architektur, die vier Netzwerke, den Software-Stack, die Berechnungen zur Modellgröße und die Abnahmetests lesen Sie den technischen Artikel: Ein Blick in eine HGX B300 KI-Fabrik mit 32 GPUs.
- Sehen Sie sich die KI-Fabrik-Lösungen an, die wir bauen, von RTX PRO Servern bis zu GB300 NVL72, sowie die Seiten zum Compal SGX30-2 und zum HGX B300 Rack mit 32 GPUs.
- Der SGX30-2 ist in unserem Shop bestellbar. Die Preise werden in einem schriftlichen Angebot bestätigt.
- Planen Sie etwas Ähnliches? Sprechen Sie mit uns.